
人工智能技术文章
-
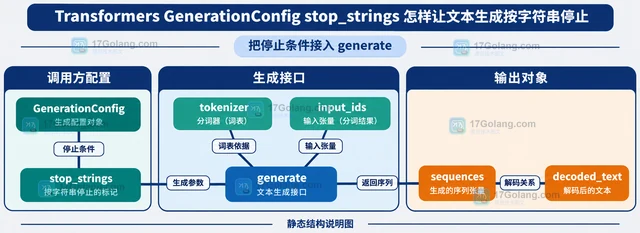 Transformers 文本生成需要在指定字符串出现后停止时,不能只写 stop_strings;还要把同一个 tokenizer 传给 generate,并区分 prompt、新生成 token 和最终展示文本。本文给出配置、批量输入和边界处理的完整写法。375 收藏
-
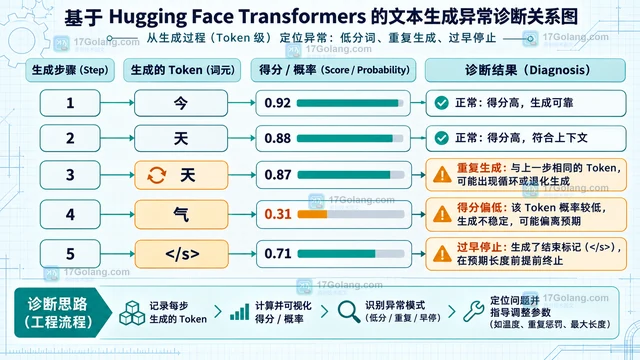 用 Transformers generate 返回逐步分数,按生成 token 对齐 scores,并区分低置信度、重复输出和提前停止。308 收藏
-
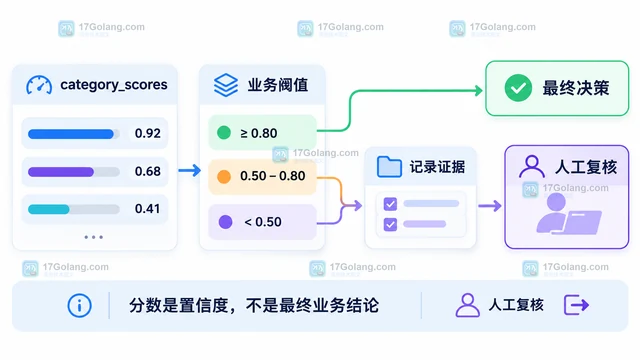 内容审核接口返回的 flagged、categories 和 category_scores 不能混成一个布尔条件。本文用三路决策模型说明多标签结果怎样进入自动通过、拦截和人工复核,并给出记录证据、处理异常和校准阈值的最小实现。160 收藏
-
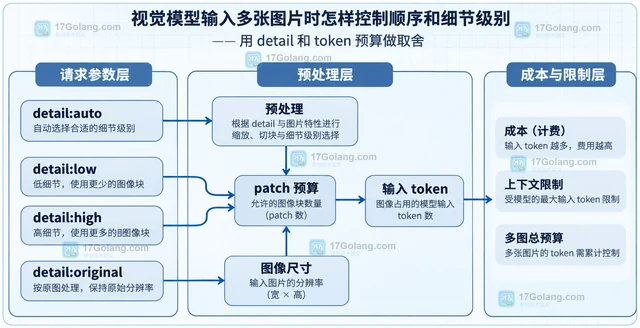 多张图片一起交给视觉模型时,稳定的图片顺序和合理的 detail 比盲目提高分辨率更重要。本文用一个多图分析请求说明 content 数组的语义组织、low/high/original 的选择,以及尺寸、patch 与输入 token 预算之间的关系。386 收藏
-
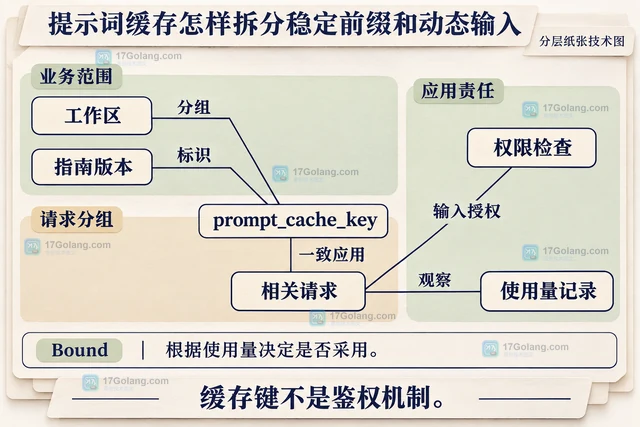 以 OpenAI Responses API 为例,说明稳定规则与动态输入的拆分方式,区分缓存键和显式断点,并给出请求组装、使用量读取与权限边界的实践建议。419 收藏
-
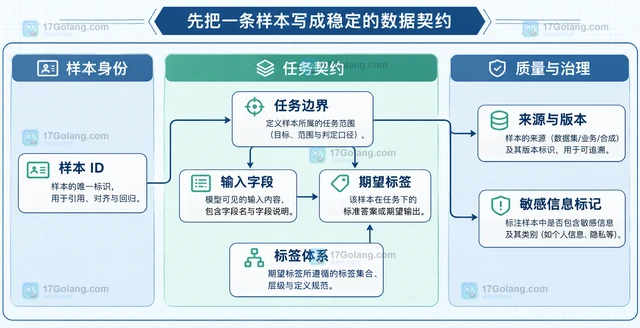 LLM 评测集要能回归,关键不是堆更多样本,而是让任务边界、输入字段、期望标签、版本来源和结果记录保持稳定关联。本文给出一套适合文本任务的样本契约、标签拆分和逐样本结果记录方式。141 收藏
-
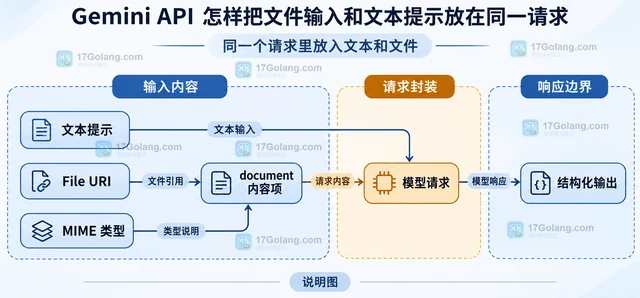 用 Gemini Files API 上传文件后,把文件 URI、MIME 类型和文本提示放入同一个请求;本文同时说明 PROCESSING、ACTIVE、FAILED 状态与临时生命周期,避免把过期文件当成永久资源。164 收藏
-
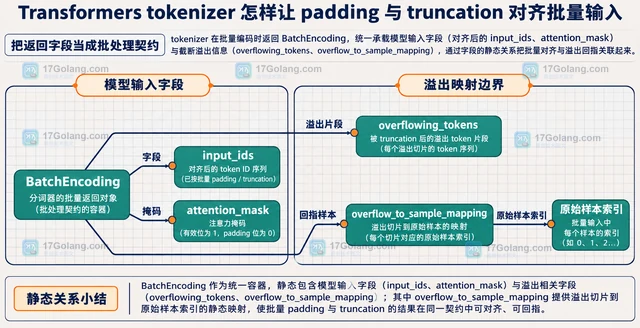 用 Transformers tokenizer 处理长度不同的批量文本:理解 padding、truncation、max_length 和 pad_to_multiple_of 的关系,并用 attention_mask、overflow 映射检查输入是否真正对齐。416 收藏
-
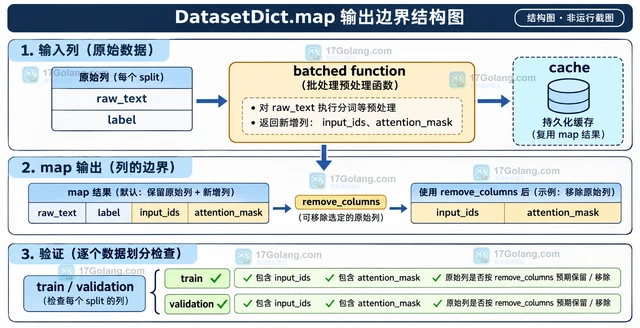 DatasetDict.map 会把同一个预处理函数应用到 train、validation 等分片,返回的仍是 DatasetDict。本文用 batched 函数、remove_columns 和逐分片检查,说明统一预处理的写法、缓存边界与常见误区。267 收藏
-
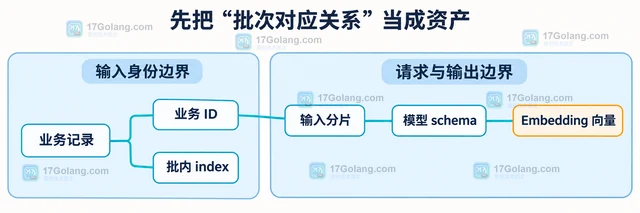 用 Python 设计 Embeddings 批处理:保留业务 ID 与批内 index,按 token 预算切分输入,固定模型和 dimensions,并按返回 index 回填向量,避免结果错位和维度不一致。185 收藏
-
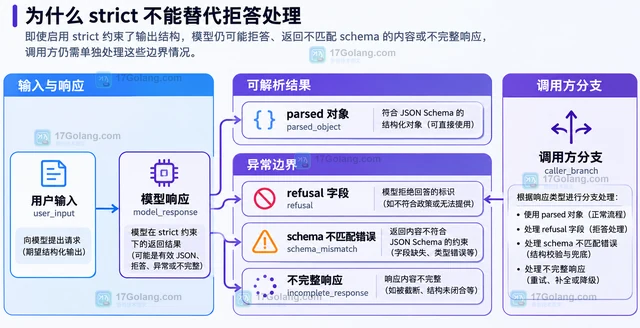 Structured Outputs 解决的不是“返回一段看起来像 JSON”,而是让模型输出尽量贴合调用方定义的 JSON Schema。本文用 schema、strict=true 和 refusal 三个边界,整理 Responses API 与 Chat Completions API 的写法、适用条件和常见误区。328 收藏
-
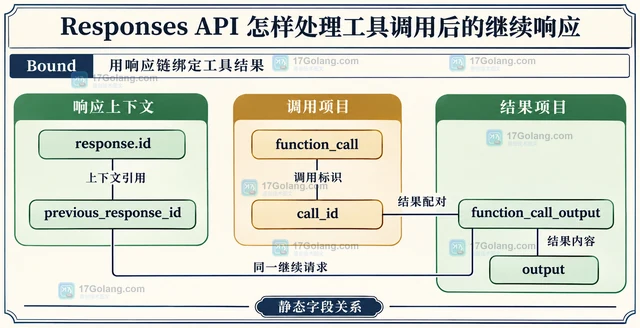 讲清 Responses API 自定义工具调用后的结果回传与继续响应,用 Python 示例说明 call_id 配对、响应链、批量调用、停止预算及应用层恢复责任。156 收藏
-
科技周边 · 人工智能 | 4天前 | 人工智能 · openai · 多轮对话 Responses API conversation state OpenAI API previous_response_id
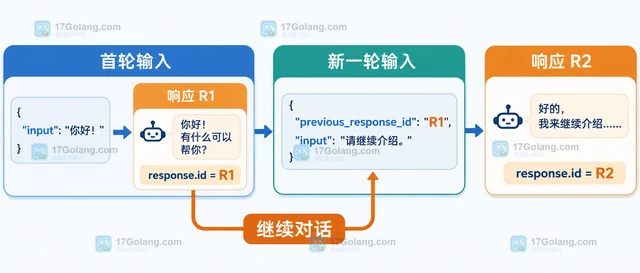 Responses API 可以通过保存上一轮 response.id,并在下一次请求中传入 previous_response_id 来继续多轮对话。本文用 Python 说明响应链、input 历史、store 与 conversation 的边界。121 收藏
-
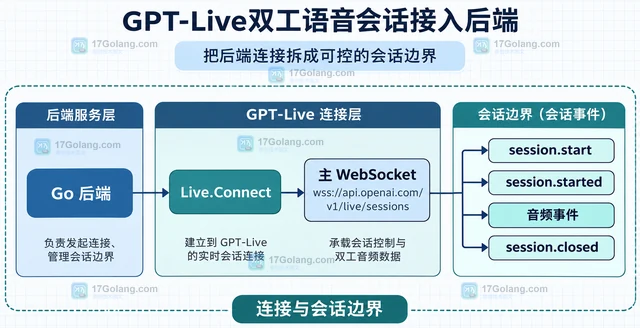 本文用 Go 后端接入 GPT-Live 双工语音会话,说明主 WebSocket、session.start、session.started、音频事件、后台委派和 session.closed 的职责边界,并给出可维护的连接生命周期示例。470 收藏
-
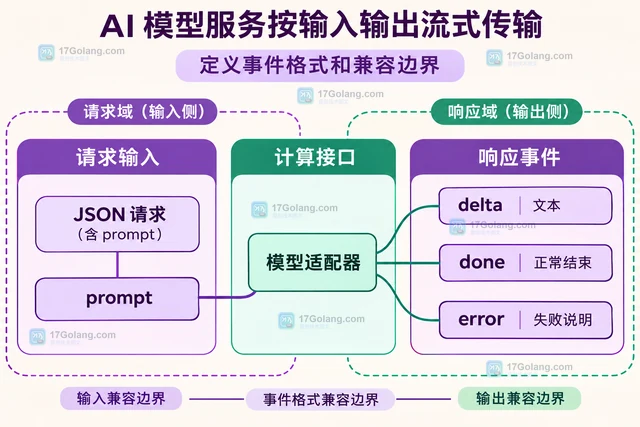 AI模型服务可保留完整JSON请求,改用SSE事件逐步输出答案。本文给出Starlette响应适配和HTTPX读取片段,说明输入输出边界、流内报错、断连、完成判定与兼容回退。417 收藏