-
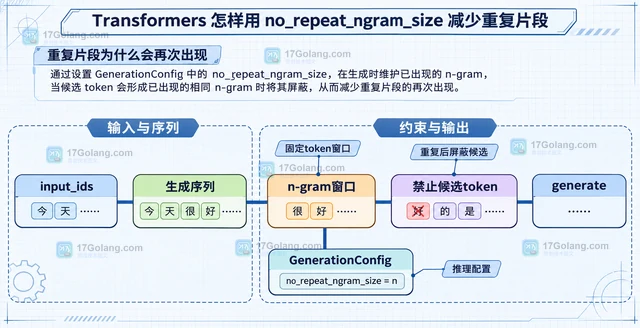
Transformers 的 no_repeat_ngram_size 是一个硬约束:当它大于 0 时,同样大小的 n-gram 在生成序列中只能出现一次。本文从重复片段的根因出发,说明 2、3、4 的选择、与 repetition_penalty 的分工,以及约束过强时如何回退。
-
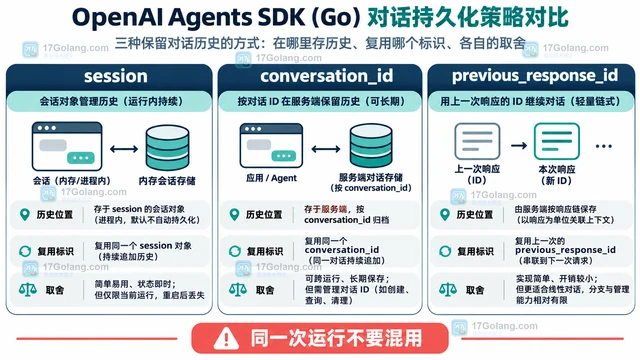
OpenAI Agents SDK 可以用 SQLiteSession、OpenAIConversationsSession 或服务端会话标识保存多轮上下文。本文给出本地文件持久化、进程重启恢复和多实例选型写法,并说明 session 与 conversation_id、previous_response_id 不能在同一次运行里混用。
-
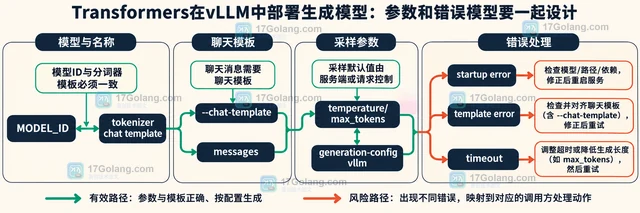
本文说明如何把 Hugging Face Transformers 模型交给 vLLM 启动为生成服务,并用 OpenAI 兼容接口调用,同时处理 chat template、模型名、采样参数和错误边界。
-
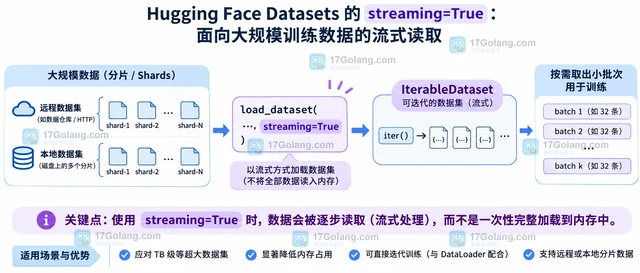
数据集无法完整下载时,可以用 Hugging Face Datasets 的 streaming=True 逐条读取,得到 IterableDataset 后再进行有限缓冲区打乱、map 预处理和按步数训练。本文给出最小写法,并说明随机访问、take/skip 和 Transformers 训练边界。
-
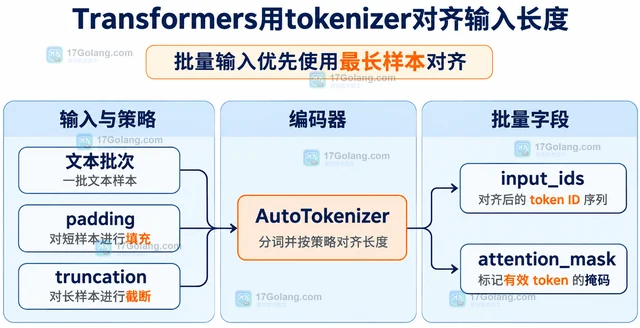
Transformers 中的 tokenizer 可以用 padding 补齐短文本、用 truncation 截断长文本,再通过 max_length 或 pad_to_multiple_of 对齐批量输入。本文用最小 Python 示例说明批内最长、固定长度和硬件倍数三种场景,并解释 input_ids 与 attention_mask 如何配合检查结果。
-
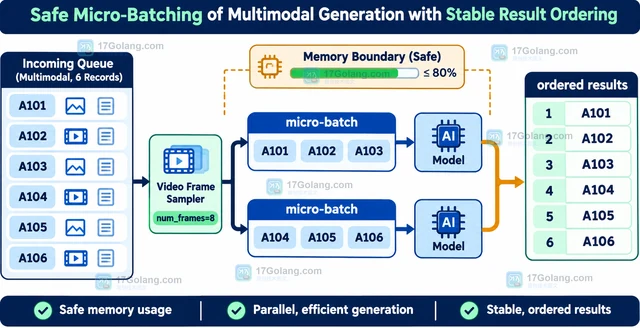
Transformers 处理多模态批次时,关键不是把图片简单塞进列表,而是让每条样本的消息结构、处理器字段和结果顺序保持一致。本文用 AutoProcessor、聊天模板、padding 与 micro-batch 说明一套可落地的批处理写法。
-
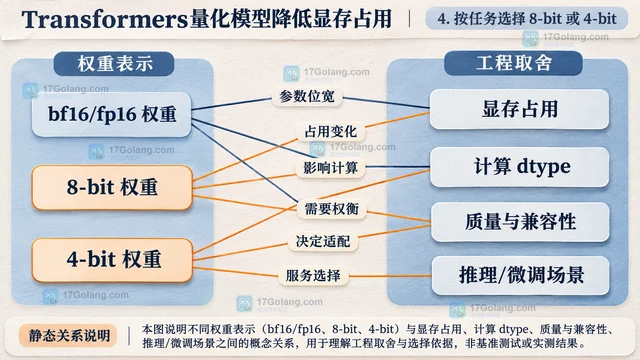
Transformers 可以在 from_pretrained 加载阶段通过 BitsAndBytesConfig 启用 8-bit 或 4-bit 量化,显著降低模型权重占用。本文从估算、依赖、加载代码、8-bit 与 4-bit 取舍以及内存统计五个环节说明怎样把量化配置落到实际推理环境。
-
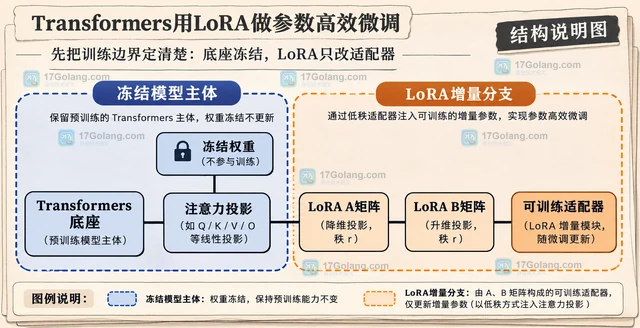
用 Transformers 与 PEFT 配置 LoRA:冻结预训练底座,只训练低秩适配器,并通过 Trainer 保存和恢复轻量检查点。
-
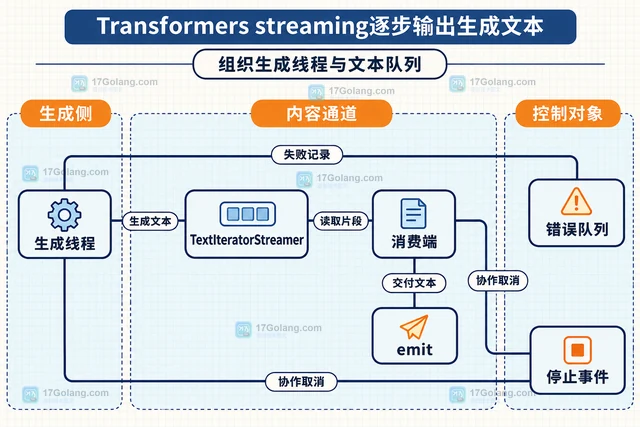
Transformers用TextIteratorStreamer将生成与文本消费分开,实现逐步输出。本文提供单请求原创函数,说明队列超时、协作取消、后台异常回传和完成事件,并给出服务接入的观察指标。
-
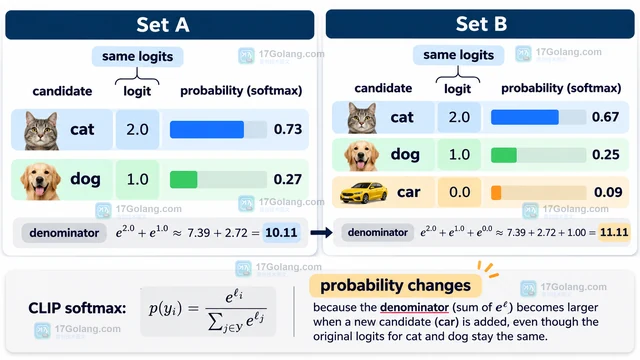
CLIP 增删候选标签后,已保留标签的概率也会变化,根因是 softmax 的归一化分母变了,而不是模型重新理解了图像。本文从 logits_per_image、分母和工程阈值三个层面说明如何正确比较结果。
-
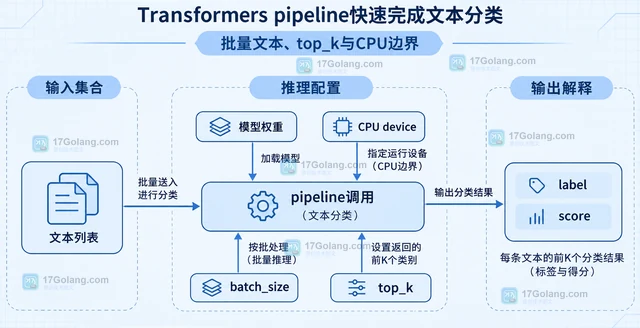
用 Transformers pipeline 接入已经微调好的文本分类模型,完成单条与批量文本推理,解释 label、score、top_k、batch_size 和 CPU 设备参数的边界。
-
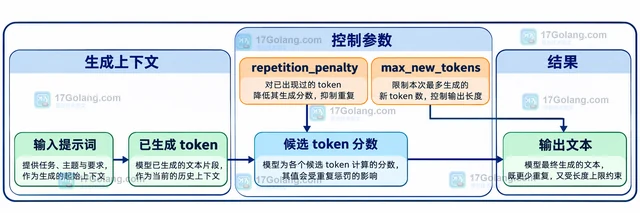
Transformers 的 repetition_penalty 用于调节已经出现过的 token 的生成倾向。本文从固定输出长度开始,给出逐步调参、GenerationConfig 配置和与 no_repeat_ngram_size、采样参数的边界,避免惩罚过高导致关键词丢失。
-
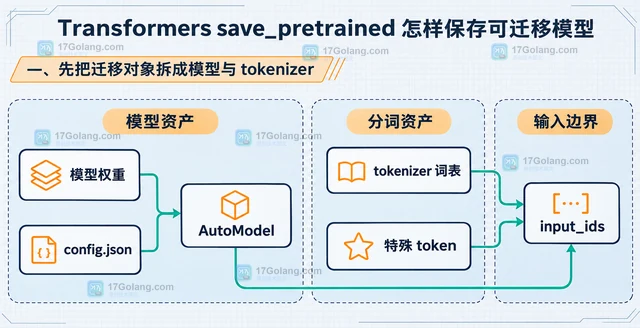
用 Transformers 的 save_pretrained 分别保存模型和 tokenizer,整理权重、配置与词表的目录关系,并说明如何在新环境中恢复。
-
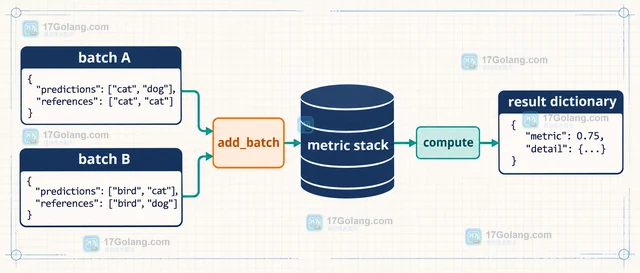
用 Hugging Face Evaluate 完成指标加载、输入格式确认、批量提交预测结果和最终 compute,并解释一次性计算与增量计算的选择边界。
-
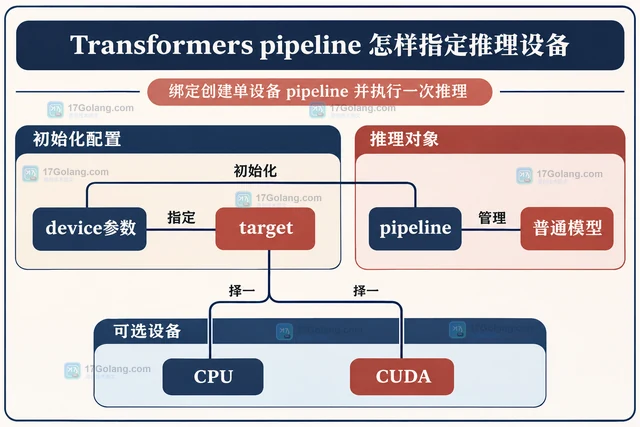
Transformers pipeline 在初始化时用 device 指定 CPU 或 CUDA 等设备。本文说明本地模型示例、输入张量移动、单设备检查,以及 device 与 device_map 不应混用的原因。
