
Transformers datasets流式读取训练数据
来源:17golang原创
时间:2026-11-15 12:41:20 275浏览 收藏
训练集大到无法完整放进本地磁盘时,Hugging Face Datasets 可以用 streaming=True 按迭代器逐步读取。它返回的不是支持随机下标和完整长度的普通 Dataset,而是 IterableDataset:数据在遍历时才被取出,适合直接做预览、预处理和按训练步数消费。
官方地址:https://huggingface.co/docs/datasets/en/stream
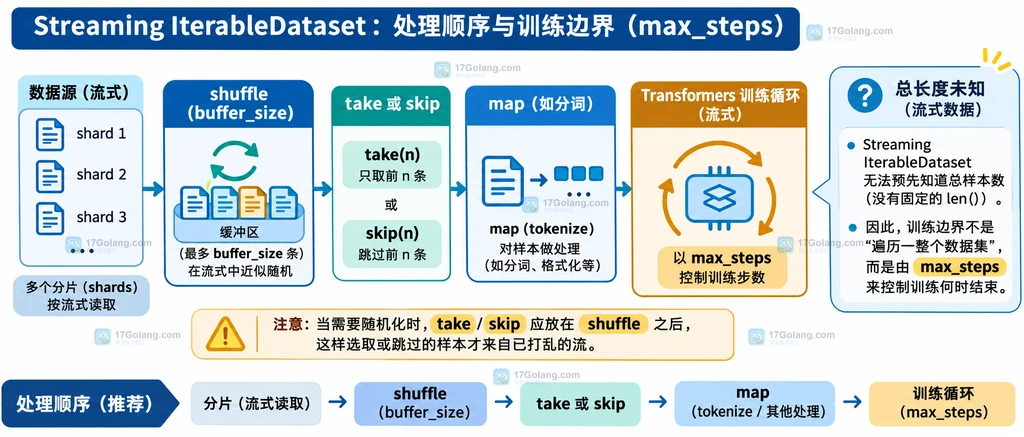
最小方案是:load_dataset(..., streaming=True)创建流式数据集,需要随机化时先调用shuffle(buffer_size=...),再用map做处理;交给 Transformers 训练时不要依赖len(dataset),用max_steps明确训练边界。
- 流式模式不把整个数据集先转换成完整本地 Arrow 数据。
IterableDataset适合顺序迭代,不适合按下标随机访问或直接求总长度。shuffle使用有限缓冲区,不等同于把全部样本装进内存后完全打乱。take和skip会固定后续分片顺序,因此需要随机化时应先 shuffle。
streaming=True 为什么适合大训练集
普通加载方式通常会准备一个可索引的数据集对象;流式加载则把重点放在“边迭代边读取”。当数据集体积超过磁盘容量、只想先取少量样本,或者训练任务本来就按批次持续消费时,这种方式可以减少启动前的完整下载等待。
调用 load_dataset 时只需要把 streaming 设为 True。返回对象的类型变化很重要:它表现为可迭代的数据流,而不是可以随时跳到第 n 条记录的数组。
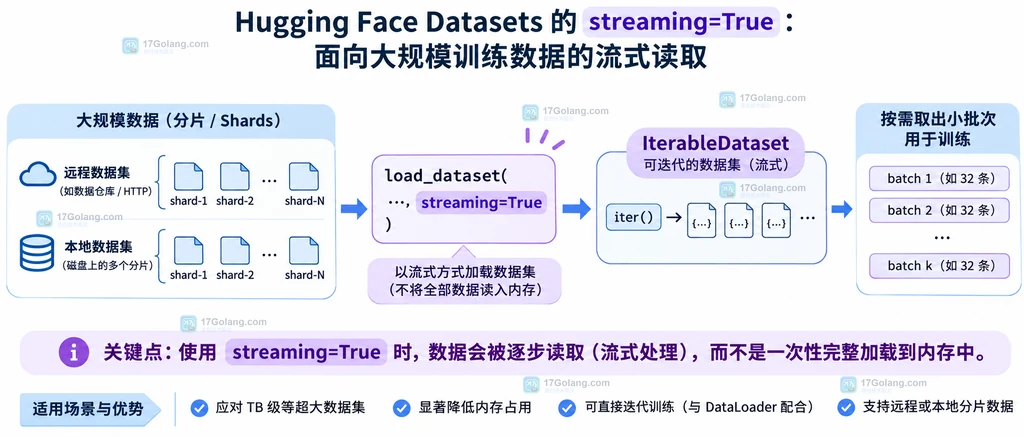
最小写法:先流式取几条样本
先不要把整条训练流水线搬进来,可以用 take 取一个小窗口,确认字段名称和数据形状。这里的 take(3) 表示最多消费前三条,不会为了计算总数而扫描完数据集。
from datasets import load_dataset

# streaming=True 让样本在迭代时读取,不先完整下载训练集。
dataset = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
)

# take 只取一个小窗口,适合先检查字段和内容形状。
for index, row in enumerate(dataset.take(3)):
    # 只打印少量字段,避免把整条样本输出到日志。
    print(index, row.get("text", "")[:120])
如果数据来自本地文件,也可以把 data_files 指向文件或通配路径,再保持 streaming=True。流式并不限定数据必须来自 Hub,关键在于读取方式和返回对象的迭代语义。
IterableDataset 和普通 Dataset 的差别
| 能力 | 普通 Dataset | IterableDataset |
|---|---|---|
| 读取方式 | 通常可按索引访问 | 通过迭代逐步产生样本 |
| 长度 | 通常可以读取 | 可能未知,不应依赖 len |
| 适合场景 | 随机访问、重复切片 | 超大数据、顺序训练、快速预览 |
| 内存/磁盘取舍 | 可使用已准备的数据集表示 | 不要求先完整物化全部数据 |
因此,下面这类写法在流式模式下不应作为主流程:
# 不要把 IterableDataset 当成可以随机下标访问的列表。
first_row = dataset[0]

# 不要依赖总长度来决定一轮训练的步数。
total_rows = len(dataset)
如果业务必须随机访问、精确计算总条数或反复从任意位置读取,先使用普通 Dataset 或准备合适的本地分片会更直接。流式模式解决的是“边读边用”,不是把所有数据集能力都换成惰性版本。
shuffle、map、take 的顺序要固定
流式数据集可以用 shuffle(buffer_size=...) 做有限缓冲区随机化。缓冲区只保存指定数量的候选样本,随机化质量和内存占用都会受到 buffer_size 影响;它不是完整数据集级别的全量洗牌。
from datasets import load_dataset

# 创建流式数据源,长度可以未知。
stream = load_dataset(
    "HuggingFaceFW/fineweb",
    split="train",
    streaming=True,
)

# 先打乱分片和有限缓冲区,再截取本轮要消费的窗口。
shuffled = stream.shuffle(seed=42, buffer_size=10_000)
window = shuffled.take(1_000)

for row in window:
    # 这里只演示消费边界;真实训练中可在 map 中完成 tokenize。
    text = row["text"]
    if text:
        print(text[:80])
take 和 skip 会锁定后续分片顺序,所以需要随机化时应先 shuffle 再切分。反过来先 take 再 shuffle,只会在已经截取的小窗口内进行随机化,不能达到“从全体流式数据中抽取”的效果。
预处理可以用 map 串在流上。每条样本在被消费时处理,适合轻量、确定性的字段转换;如果转换本身很重,要额外评估 CPU、网络读取和训练 GPU 的节奏是否匹配。
接入 Transformers 训练时用 max_steps 设边界
流式数据通常没有可直接依赖的总长度,因此训练循环不应以“完整遍历一遍数据集”作为唯一停止条件。使用 Transformers 的 Trainer 或类似训练器时,常见做法是指定 max_steps,让训练以优化步数结束。
from datasets import load_dataset
from transformers import AutoTokenizer, DataCollatorWithPadding, TrainingArguments

model_name = "distilbert/distilbert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 训练数据按需读取,避免先把全部文本落到本地。
stream = load_dataset(
    "imdb",
    split="train",
    streaming=True,
)

def tokenize_batch(batch):
    # truncation 给单条文本设置上限,避免异常长样本拖垮批次。
    return tokenizer(batch["text"], truncation=True, max_length=256)

# batched 处理要与下游训练器的批次约定一致。
tokenized_stream = stream.map(tokenize_batch, batched=True)
collator = DataCollatorWithPadding(tokenizer=tokenizer)

args = TrainingArguments(
    output_dir="./outputs",
    per_device_train_batch_size=8,
    # 数据长度未知时,用明确步数代替按 epoch 推断总样本数。
    max_steps=1_000,
    logging_steps=50,
)

# 这里将 tokenized_stream 交给 Trainer 的 train_dataset 参数。
# 具体 Trainer、模型和标签列需按任务补齐,本文只展示流式边界。
print(args.max_steps, collator)
print(next(iter(tokenized_stream)))
上例把“数据能持续产生”与“训练何时结束”拆成两个问题:前者由 IterableDataset 和迭代器负责,后者由 max_steps 负责。若仍希望按 epoch 表达,需要先明确可用的样本数或分片计划,不能假设流式对象会自动提供精确长度。
并行、分片与随机访问的边界
如果从一个已经存在的普通数据集转换为 IterableDataset,可以通过分片让多个 DataLoader worker 分担读取。官方文档给出的思路是准备多个 shard,再使用 to_iterable_dataset(num_shards=...),这样每个 worker 负责其中一部分,而不是让所有 worker 反复读同一份数据。
from datasets import load_dataset
from torch.utils.data import DataLoader

# 先得到可索引数据集,再转换成带分片能力的可迭代数据集。
materialized = load_dataset("ethz/food101", split="train")
iterable = materialized.to_iterable_dataset(num_shards=64)

# 缓冲区随机化只在迭代过程中生效,worker 数量应与分片数量匹配。
iterable = iterable.shuffle(seed=7, buffer_size=10_000)
dataloader = DataLoader(iterable, num_workers=4)

for batch in dataloader:
    # 真实项目里这里接模型训练;示例只消费一个批次。
    print(batch.keys())
    break
这条路线的代价是:你先准备了普通数据集,才获得了更方便的分片转换;它与“完全不下载远程大数据”的 load_dataset(..., streaming=True) 不是同一条路径。选择哪一种,取决于数据是否已经在本地以及是否需要 worker 级分片。
性能和安全注意
- 缓冲区不是全量洗牌。 增大
buffer_size通常会增加内存和预取压力,先根据样本大小和 worker 数量估算。 - 不要把未知长度写成伪长度。 训练步数、梯度累积和 batch size 要一起换算,避免最后的训练量与预期不一致。
- 谨慎打印原始样本。 训练数据可能含个人信息、访问令牌或业务文本,预览时只打印必要字段和截断片段。
- 先 shuffle 再 take/skip。 需要随机采样时,这个顺序比把一个已经固定的小窗口再次随机化更符合预期。
- 区分网络瓶颈和模型瓶颈。 流式读取让下载与训练交错进行,网络、解压、tokenize 或 worker 任一环节变慢,都可能让 GPU 等待。
速查表:什么时候选流式读取
| 需求 | 建议 | 原因 |
|---|---|---|
| 先看几条样本 | streaming=True + take | 不必等待全部数据准备完成 |
| 数据大于本地磁盘 | 流式加载并按步数训练 | 训练数据边迭代边读取 |
| 需要近似随机化 | 先 shuffle(buffer_size) | 在有限内存中维护随机缓冲区 |
| 必须按下标访问 | 普通 Dataset 或本地索引格式 | IterableDataset 不提供同样的随机访问语义 |
| 需要多 worker 分片 | to_iterable_dataset(num_shards) | 把分片分配给 DataLoader worker |
相关问题
streaming=True 会不会把数据集缓存成完整文件?
它的目标是迭代时读取,不要求先把整个数据集准备成完整本地数据集;具体缓存和底层文件行为仍取决于数据格式与加载器。
IterableDataset 能不能直接调用 len?
不要把它当成一定有长度的对象。流式数据的总样本数可能未知,训练时使用明确的 max_steps 更稳妥。
为什么 take 要放在 shuffle 后面?
take 会固定后续分片顺序。若先 take,后续 shuffle 只作用于已经截取的小窗口;先 shuffle 再 take 才能让窗口从流式随机化结果中产生。
流式数据能不能做 tokenize?
可以使用 map 在迭代过程中处理,常见做法是配合 batched=True 交给 tokenizer;需要关注 tokenizer 速度是否跟得上读取和训练。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
470 收藏
-
417 收藏
-
493 收藏
-
414 收藏
-
122 收藏
-
207 收藏
-
317 收藏
-
306 收藏
-
460 收藏
-
340 收藏
-
210 收藏
-
211 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习