
人工智能技术文章
-
科技周边 · 人工智能 | 6天前 | python · 人工智能 · 并行处理 index Hugging Face Datasets Datasets shard num_shards contiguous
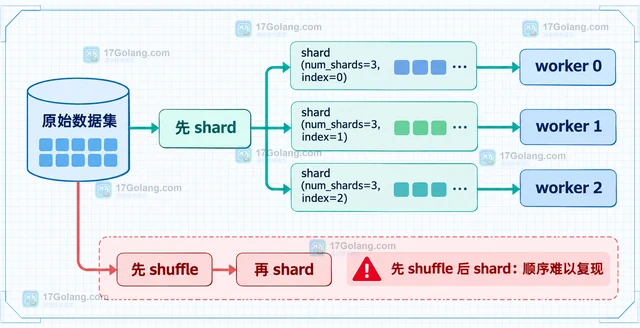 用 Hugging Face Datasets 的 shard 方法把数据集分给多个 worker,解释 contiguous、num_shards 和 index 的关系,处理余数、shuffle 顺序以及分片边界问题。417 收藏
-
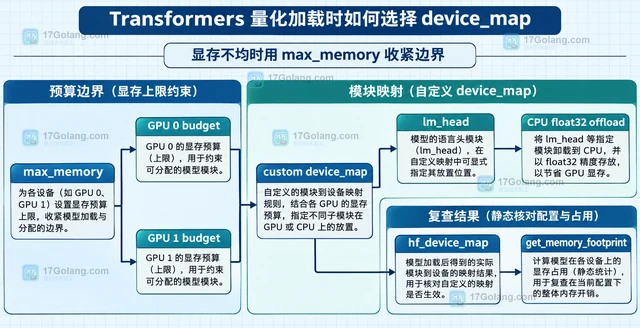 用 Transformers 和 bitsandbytes 加载量化模型时,device_map 应按推理方式、显存预算和是否需要 CPU offload 来选择。本文区分 auto、明确设备、自定义字典与 max_memory,并说明如何读取分配结果。280 收藏
-
科技周边 · 人工智能 | 6天前 | python · Transformers TextIteratorStreamer 流式生成 AsyncTextIteratorStreamer StoppingCriteria
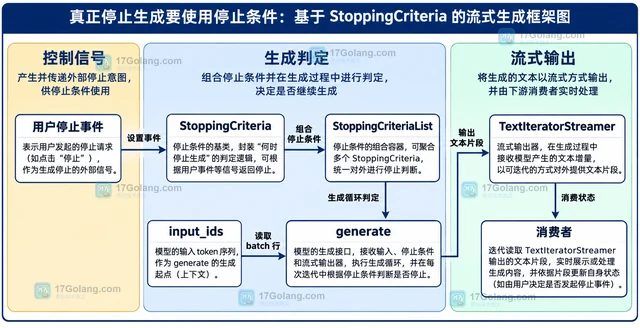 Transformers streamer 的结束 sentinel 只负责通知消费者收尾,不会自动取消 model.generate。本文区分 TextIteratorStreamer、AsyncTextIteratorStreamer、timeout、stop_strings 与 StoppingCriteria 的职责,并给出线程、异步和外部停止按钮的实现边界。198 收藏
-
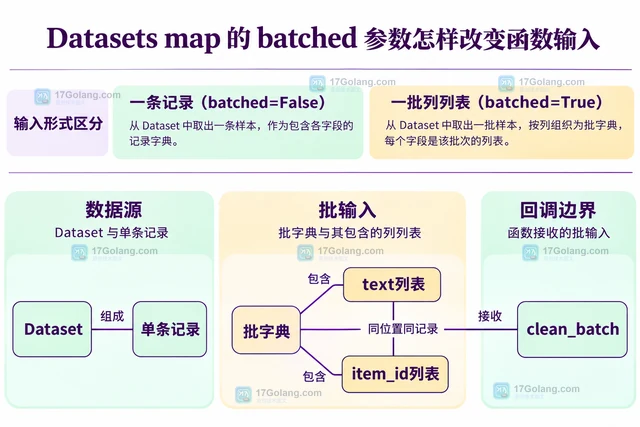 Datasets map 设置 batched=True 后,回调默认接收列列表组成的批字典。本文通过本地小数据集说明逐条与批量写法、输出列行数对齐、remove_columns 和尾批处理。279 收藏
-
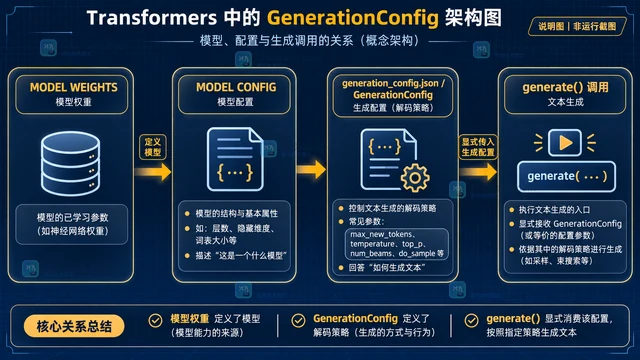 用 GenerationConfig 集中保存 Transformers 的生成参数,掌握 generation_config.json 的复用方式、加载边界和 generate 调用优先级。161 收藏
-
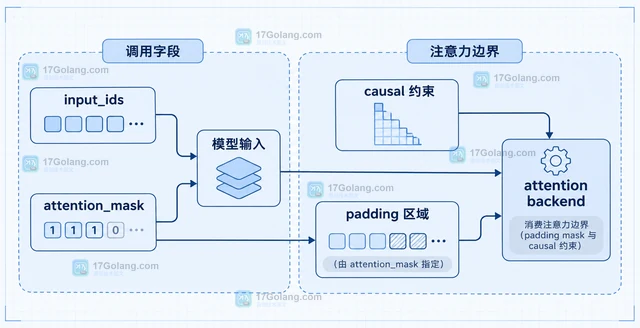 解释 Transformers 中 attention_mask 缺失的影响,区分单条输入、批量 padding、因果 mask 和 decoder mask,并给出 tokenizer 自动生成与检查掩码的实用示例。453 收藏
-
科技周边 · 人工智能 | 6天前 | 人工智能 · padding Transformers tokenizer max_length attention_mask truncation return_tensors
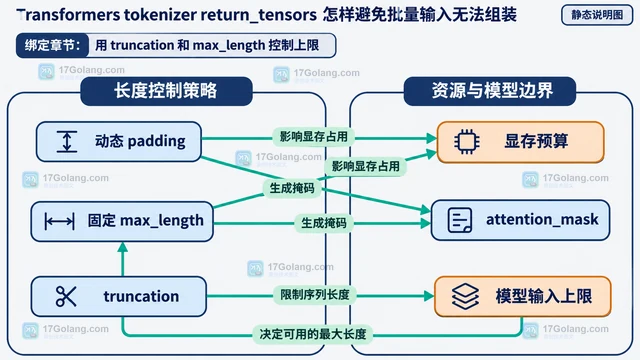 Transformers tokenizer 的 return_tensors 只负责把编码结果转换成张量,不会自动解决批量文本长度不同的问题。本文从批量输入无法组装的现象出发,说明 padding、truncation、max_length 和 attention_mask 如何配合,并给出动态长度与固定长度的选择方法。352 收藏
-
科技周边 · 人工智能 | 6天前 | 人工智能 · 文本分类 softmax Transformers AutoModelForSequenceClassification logits id2label
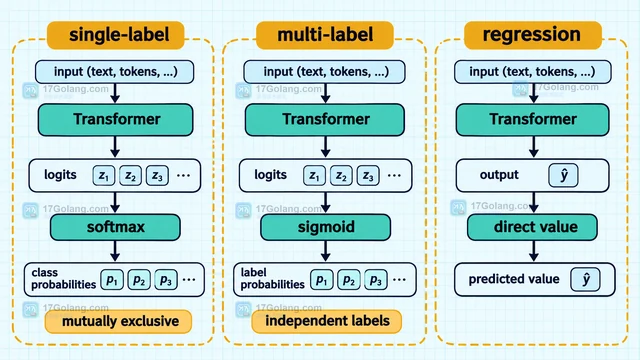 Transformers 分类模型返回的 logits 不是概率。本文从输出张量形状、id2label 映射和任务类型三个角度说明如何把 logits 正确解释成类别结果,并给出保留批量维度的最小推理代码。172 收藏
-
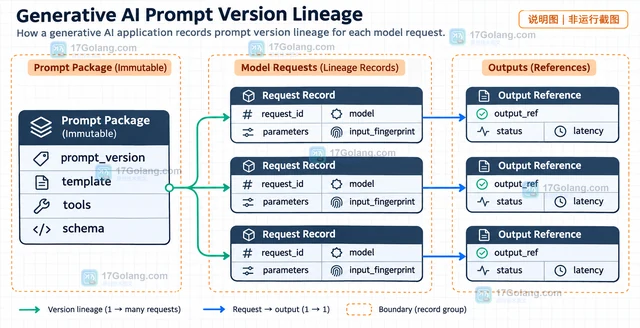 生成式 AI 应用应把提示词正文、工具定义和输出约束固定成不可变版本,再用 request_id 关联模型请求与输出。本文给出版本键、请求事件字段和敏感数据分层记录方法。243 收藏
-
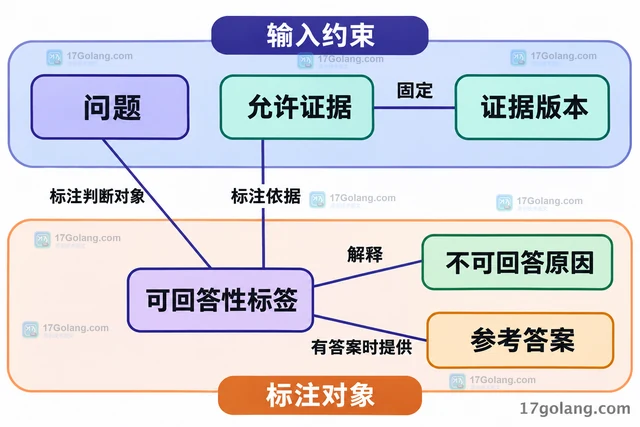 以允许证据定义不可回答标签,将正确拒答、错误拒答和无依据作答分开统计,说明拒答率与拒答精确率的分母、回答质量和拒答表达评分,以及版本比较的样本边界。457 收藏
-
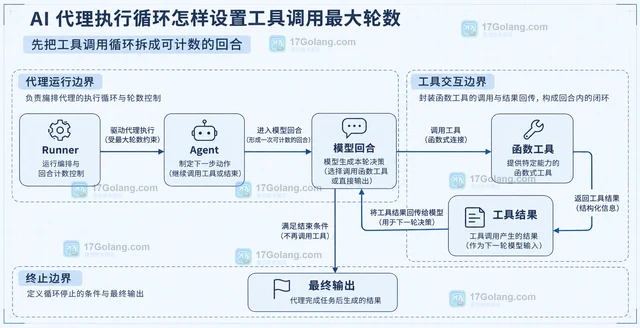 AI 代理的工具调用循环应把 max_turns 当作模型回合硬上限,再分别观测工具错误率、延迟与成本。本文用 OpenAI Agents SDK 的 Runner 示例说明上限触发、受控退出、并发工具和嵌套代理的预算边界。253 收藏
-
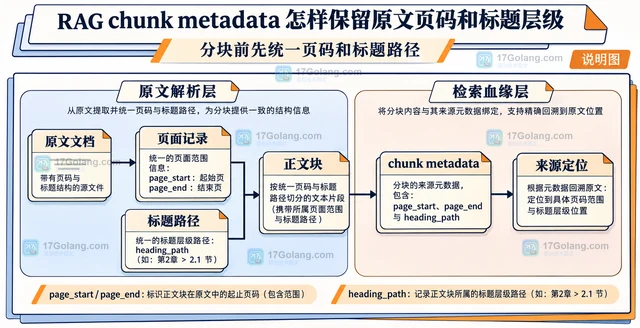 RAG 召回结果如果只有文档名,读者很难回到原文位置。本文用 page_start、page_end、heading_path 等 chunk metadata 记录页码范围和标题层级,并说明如何在分块时复制标题栈、召回后格式化来源,以及如何区分文件级 attributes 与片段级血缘字段。114 收藏
-
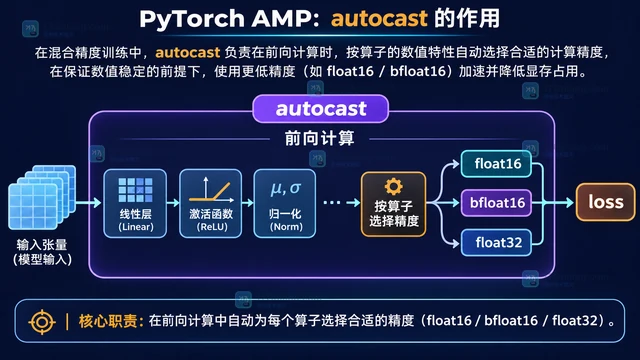 PyTorch AMP 里,autocast 负责前向算子选择合适的计算精度,GradScaler 负责放大 loss、还原梯度并在出现 inf 或 NaN 时保护优化器更新。本文按训练循环拆开两者职责,并说明梯度裁剪、float16、bfloat16、梯度累积和多优化器的放置边界。276 收藏
-
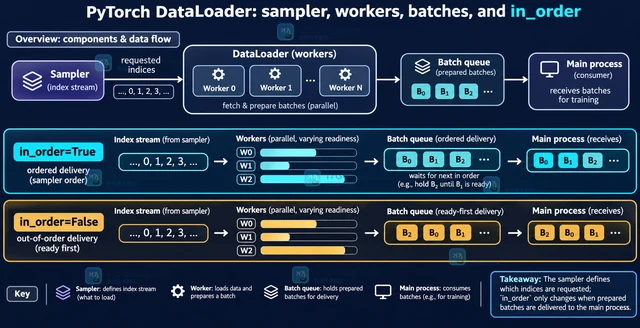 PyTorch DataLoader 的 in_order=False 改变的是多进程 batch 的交付顺序,不是简单改写 sampler。本文解释加载耗时如何与返回顺序产生关联,并给出训练、验证和数据审计的选择与对照排障方法。403 收藏
-
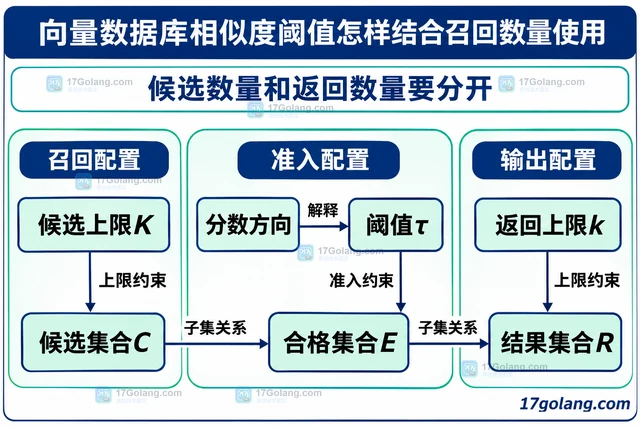 说明向量检索 top-k 与相似度阈值的不同职责,区分候选数量和最终返回数量,给出独立的过滤示例,并解释分数方向、正常空结果与查询失败的处理边界。412 收藏