-
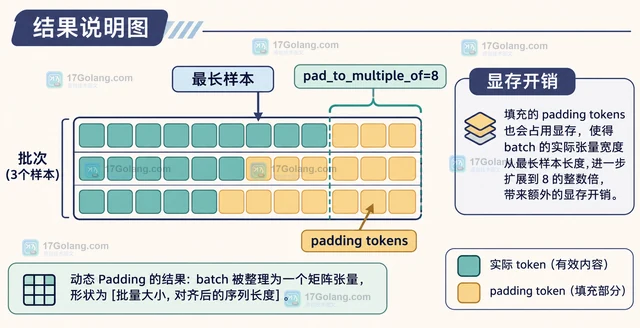
用 Transformers DataCollatorWithPadding 在 batch 内按最长序列动态补齐,区分 truncation、padding、max_length 和 pad_to_multiple_of,减少无效 token 并排查显存异常。
-
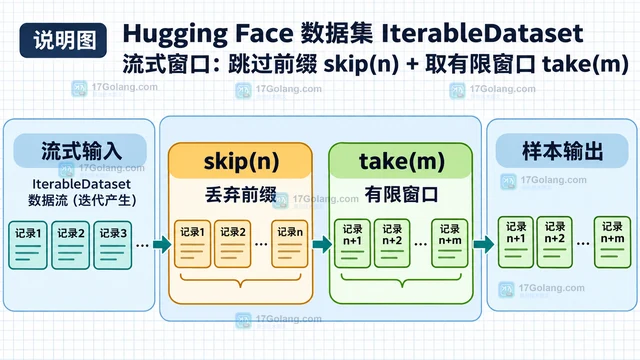
Hugging Face datasets 开启 streaming=True 后得到 IterableDataset,不适合用 dataset[1000] 做行随机索引。本文说明如何用 shuffle、skip、take 组合读取有限窗口,并解释跳过仍需顺序推进、何时应改用普通 Dataset。
-
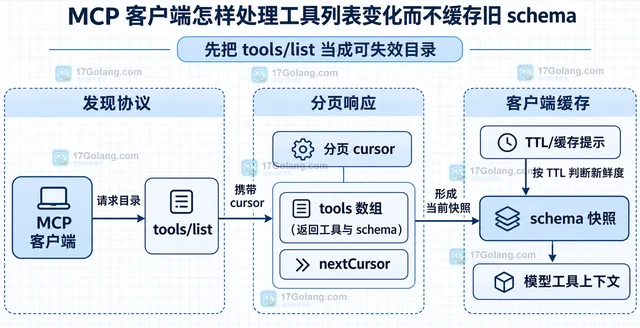
MCP 客户端不要把首次 tools/list 永久缓存;应完整处理分页,收到 notifications/tools/list_changed 后重新拉取,用目录代次和调用前 schema 校验挡住旧定义,并按授权上下文隔离缓存。
-
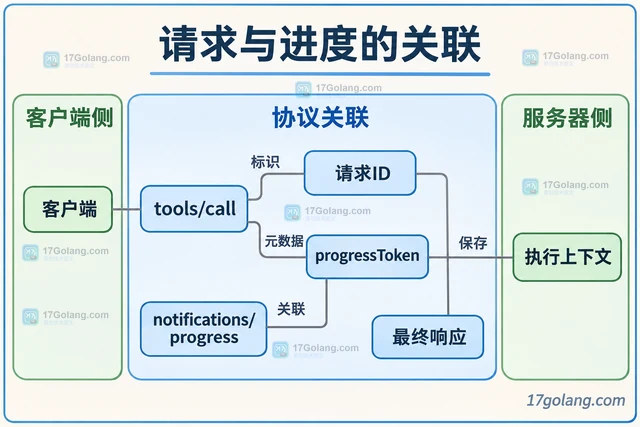
区分 MCP 进度通知与后台执行,说明 progressToken 和请求 ID 的关联、异步执行器与有界队列、普通请求取消,以及支持 Tasks 时的任务状态和结果获取边界。
-
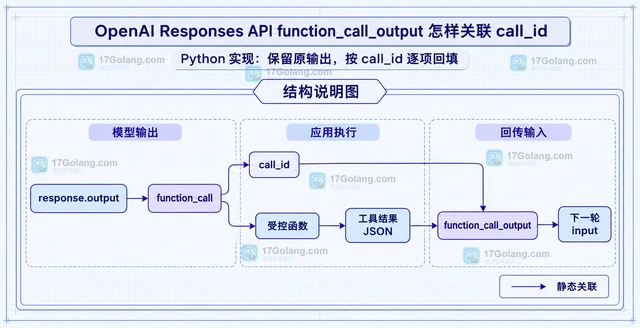
Responses API 工具调用中,function_call_output 必须使用对应 function_call 的 call_id 回传结果;本文区分 response.id 与 call_id,说明多工具调用、推理上下文和 Python 实现中的关联边界。
-
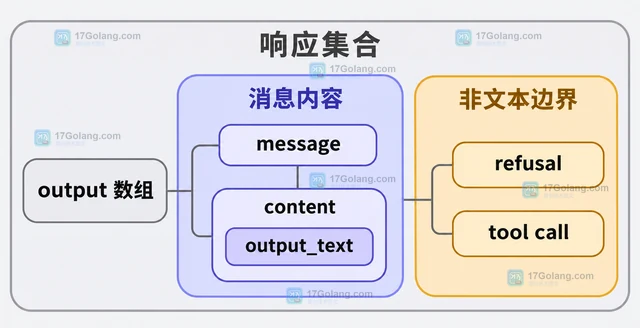
Responses API 只展示文本时可用 SDK 的 output_text 便捷字段;涉及工具调用、拒答、注释或完整响应记录时,应遍历 output 并按 type、content 类型解析,不能假设 output[0] 一定是最终文本。
-
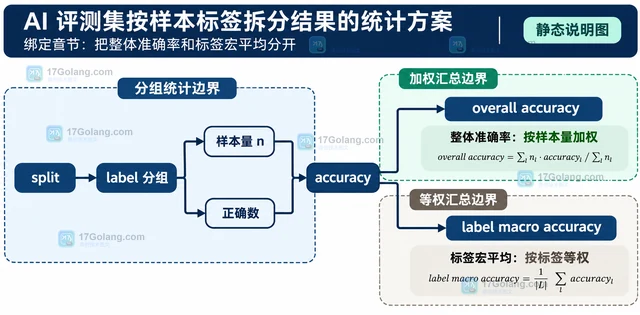
围绕 AI 评测集的样本标签拆分,给出从行式结果、分组计数到整体准确率与标签宏平均的可复算统计方案,并说明小样本、缺失标签和重复样本的处理边界。
-
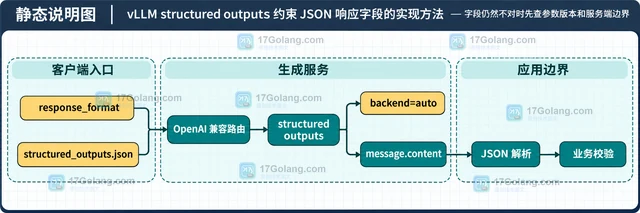
使用 vLLM OpenAI 兼容接口时,可以通过 response_format 的 json_schema 或 structured_outputs.json 声明 JSON Schema,约束模型返回字段。本文从字段契约、Python 调用、旧 guided_json 迁移和常见排查边界说明具体写法。
-
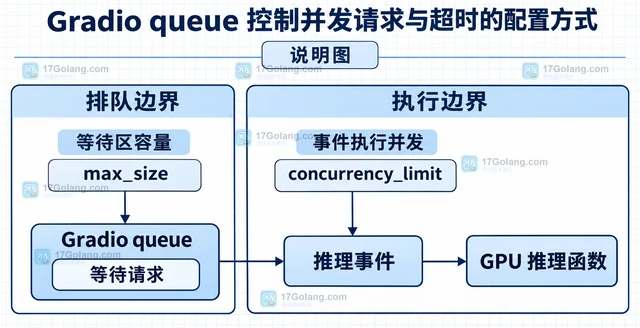
Gradio queue 的并发和超时配置要分层处理:用 max_size 控制等待区,用 concurrency_limit 限制事件执行数,用 concurrency_id 保护共享资源,真正的函数超时交给下游调用层。
-
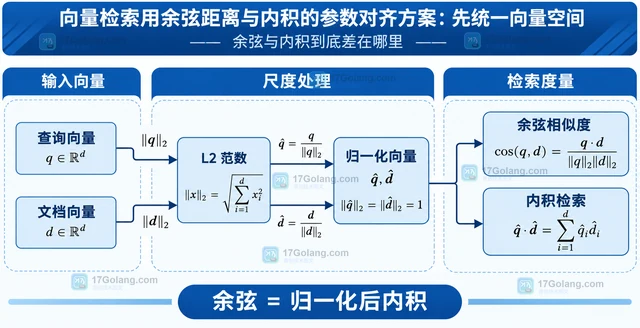
向量检索从余弦距离切换到内积时,关键不是只改 metric,而是确认查询向量和库内向量是否都做了 L2 归一化。本文用公式、Python 检查代码和迁移清单说明两种参数如何对齐,以及未归一化时为什么会改变排序。
-
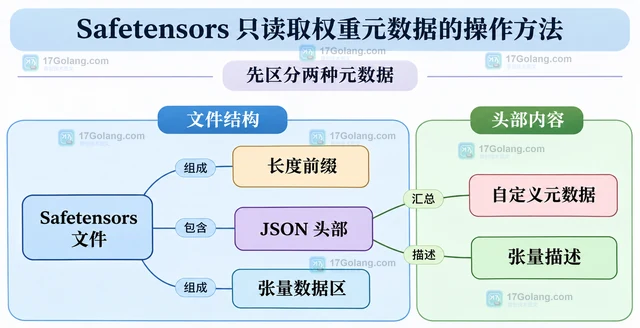
用 Python 标准库读取 Safetensors 长度前缀和 JSON 头部,获取张量名称、dtype、shape 与偏移,区分自定义元数据及分片索引,无需构造张量或初始化模型。
-
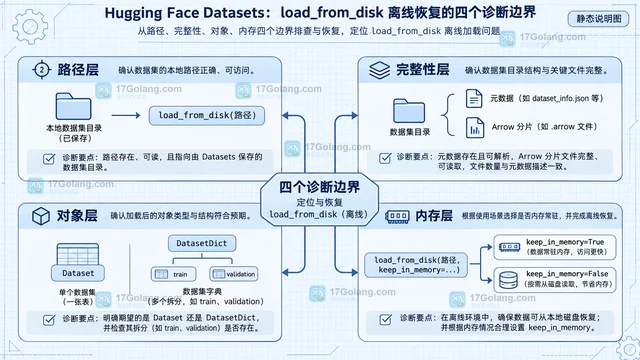
Hugging Face Datasets 的 save_to_disk 可以把 Dataset 或 DatasetDict 写入固定目录,load_from_disk 再从该目录恢复。本文从离线场景出发,说明单数据集与多 split 的保存方式、分片参数、路径边界,以及目录缺失和内存占用的排查顺序。
-
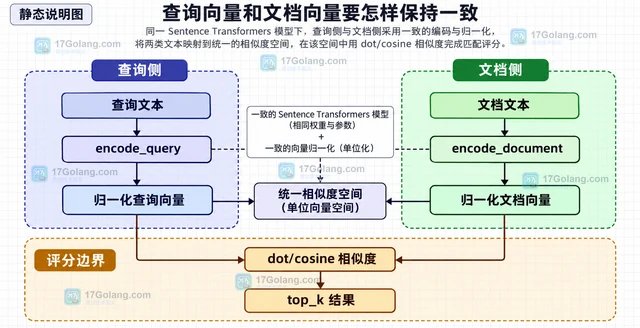
用 Sentence Transformers 的 encode 批量处理文本时,batch_size 决定分批边界,convert_to_numpy 控制输出容器,normalize_embeddings=True 让每个向量长度归一到 1。本文给出一段可迁移的 Python 写法,并说明查询、文档、维度、显存和索引兼容性的边界。
-
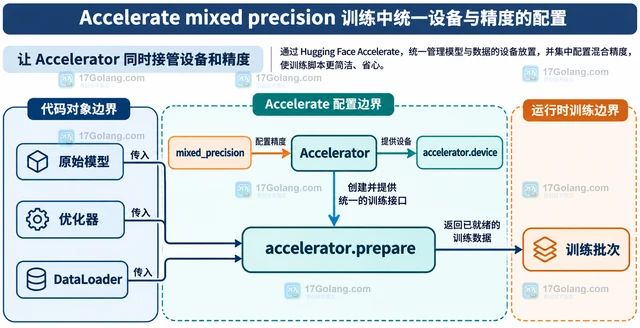
Accelerate 训练时,把设备放置、mixed precision 和启动参数集中到同一个 Accelerator 配置中,能减少手动 to 设备造成的冲突。本文用一段可迁移的 PyTorch 训练骨架说明 prepare、autocast、backward 以及常见排查方法。
-
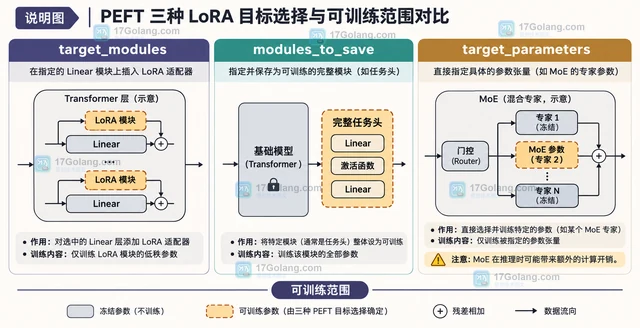
用 target_modules 选择 LoRA 插入位置,用 modules_to_save 保留需要完整训练的模块,并用 target_parameters 处理 MoE 参数级目标;最后通过参数统计清点实际训练范围。
