
人工智能技术文章
-
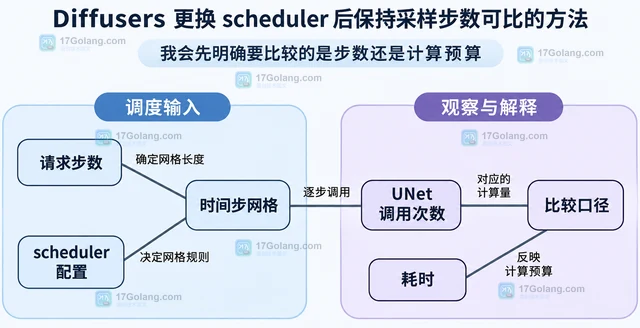 说明 Diffusers 更换 scheduler 时如何区分请求步数、时间步网格和实际网络调用,给出配置继承、独立随机生成器及 UNet 调用记录示例,建立同预算比较方法。451 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · 工具调用 · Transformers JSON Schema 工具调用 chat template apply_chat_template tool_calls
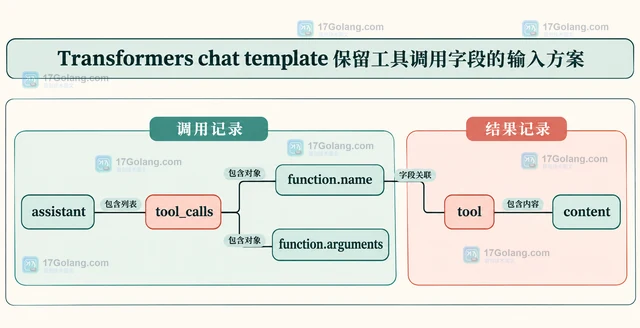 Transformers chat template 接入工具调用时,工具定义应通过 tools 传入,assistant 的 tool_calls 保留列表和嵌套字段,tool 结果写入字符串 content。本文给出完整消息结构、apply_chat_template 调用方式和字段丢失排查表。495 收藏
-
科技周边 · 人工智能 | 1星期前 | python · Hugging Face Datasets Dataset.filter with_indices input_columns load_from_cache_file num_proc
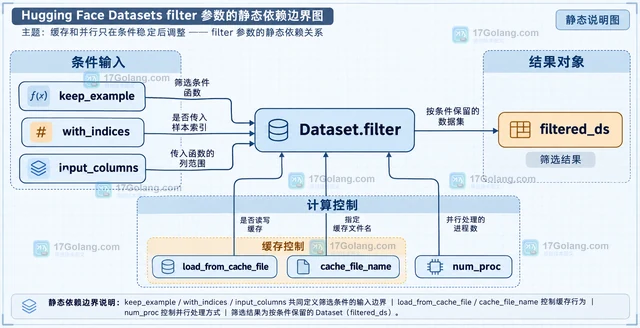 Hugging Face Datasets 的 Dataset.filter 按条件返回新的数据集对象。本文用 Python 说明条件函数、with_indices、input_columns、缓存和 num_proc 的边界,并整理行数、字段与空结果的检查方法。225 收藏
-
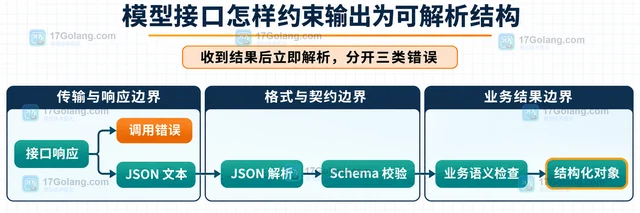 本文用一个工单摘要示例说明模型接口怎样用 JSON Schema 或 grammar 约束输出形状,并区分接口错误、JSON 解析错误、Schema 校验错误和业务语义问题。134 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · PyTorch DataLoader Hugging Face Datasets set_format with_format torch.Tensor
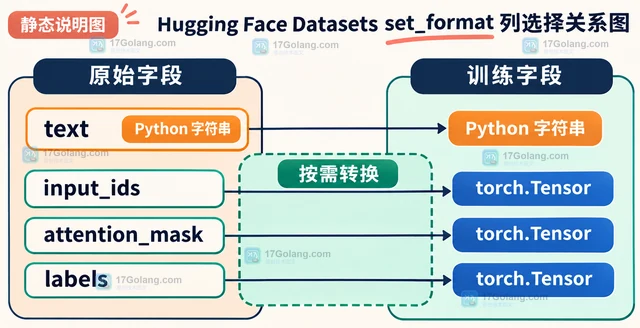 Hugging Face Datasets 同时含有原始文本、标签和模型输入时,可以用 set_format 或 with_format 只选择 input_ids、attention_mask、labels 等训练字段按需转换为 torch.Tensor。本文说明两者差异、output_all_columns 的边界、DataLoader 接入方式和 reset_format 的恢复方法。177 收藏
-
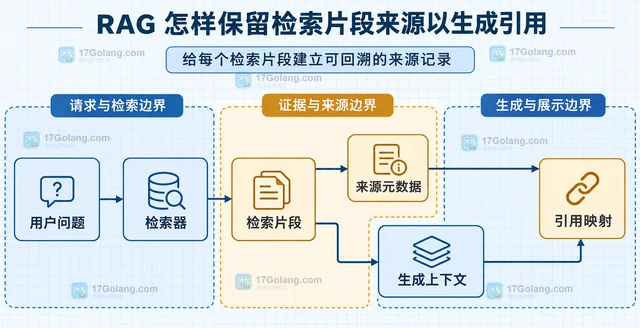 本文说明 RAG 如何在切片、检索、上下文拼接和回答渲染之间保留 chunk_id 与来源元数据,并把短引用标记映射回标题、章节和 URL。435 收藏
-
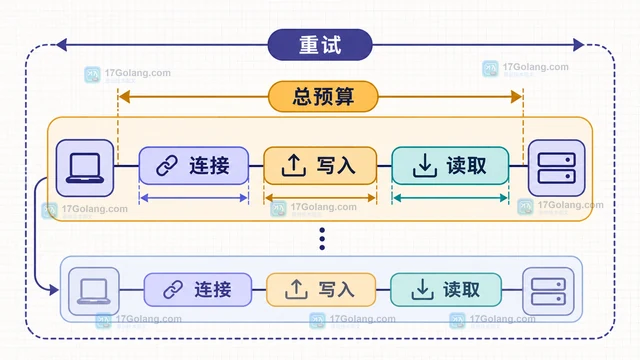 使用 OpenAI 兼容接口时,超时应同时考虑客户端默认值、单次请求覆盖、连接与读取阶段,以及超时后的重试预算。本文以 Python 客户端为例,给出从无限等待迁移到可控超时和异常处理的完整做法。135 收藏
-
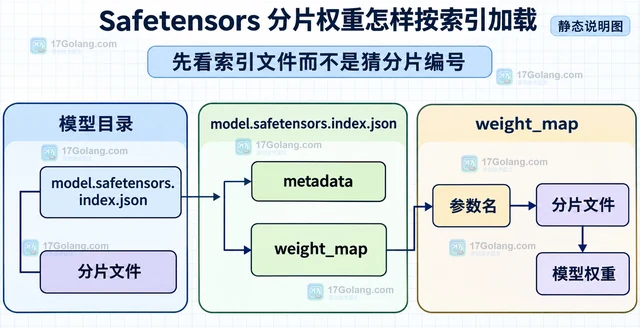 Safetensors 分片模型的关键不是按文件名猜顺序,而是读取 model.safetensors.index.json 的 weight_map。本文给出 Transformers 自动加载和 safe_open 按索引读取两种做法,并说明缺片、键名不匹配与内存取舍。389 收藏
-
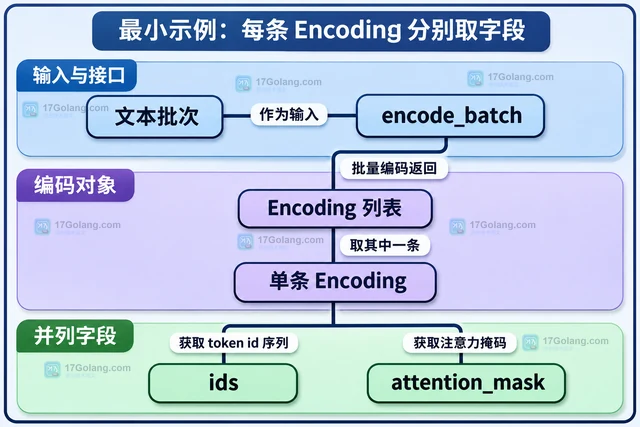 以 Tokenizers 0.20.3 Python API 为例,展示 encode_batch 返回 Encoding 列表后读取 ids 与 attention_mask 的写法,并说明填充、截断、输入资源限制及模型配套配置。204 收藏
-
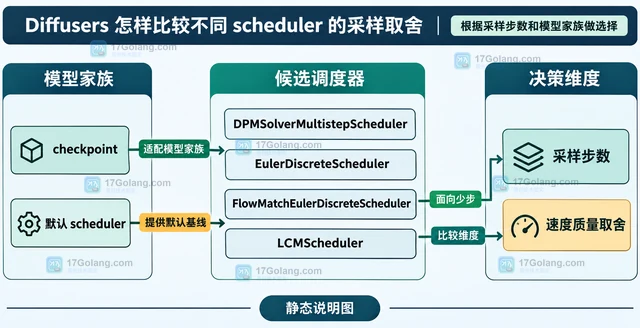 从同一 pipeline、固定输入和 from_config() 出发,比较 Diffusers 不同 scheduler 在采样步数、速度、稳定性与细节上的取舍,并给出按模型家族选择的判断方法。134 收藏
-
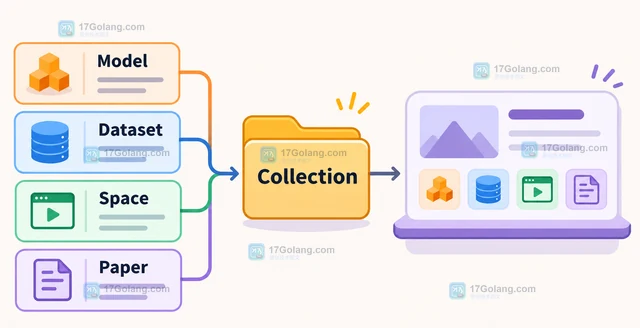 本文以一个项目目录的整理场景为线索,说明 Hugging Face Collections 如何创建集合、加入模型/数据集/Space、添加纯文本备注、调整条目顺序并处理公开展示边界。160 收藏
-
科技周边 · 人工智能 | 1星期前 | 人工智能 · 深度学习 · PyTorch DataLoader Accelerate 多进程训练 split_batches dispatch_batches
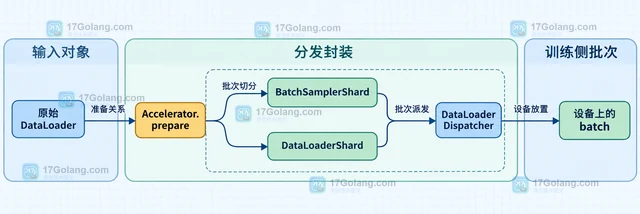 本文围绕 Accelerator.prepare() 说明如何把 PyTorch DataLoader 接入多进程训练,重点解释 split_batches、dispatch_batches、even_batches 的批次分发、设备放置和尾部样本边界。222 收藏
-
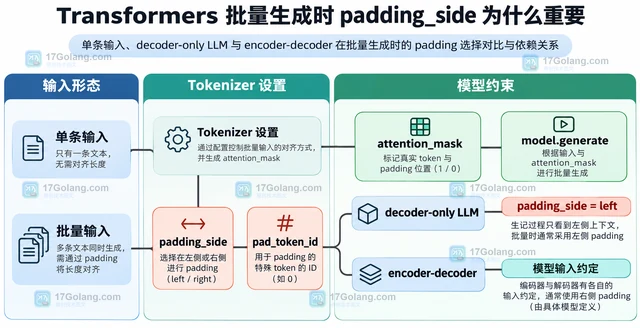 批量生成时 padding_side 会影响 decoder-only 模型读取的最后有效位置。本文比较 left、right、pad_token 与 attention_mask 的关系,并给出 Transformers 的批量配置示例。270 收藏
-
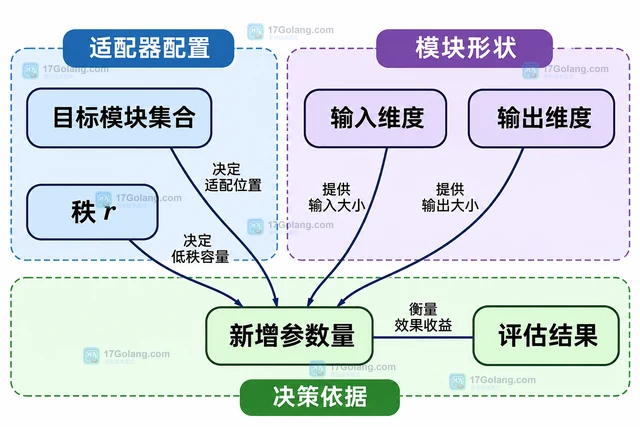 从模型真实模块名称出发,比较窄范围注意力投影与 all-linear 的适用条件,说明 LoRA 最小配置、参数预算及融合投影、MoE 等特殊结构的选择边界。378 收藏
-
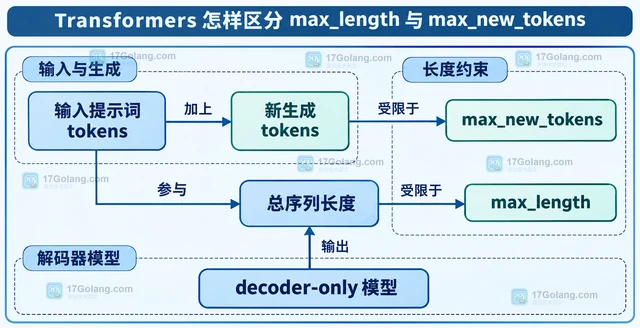 Transformers 的 max_length 控制序列总长度,而 max_new_tokens 只控制本次新增 token 数。本文用 decoder-only 与 encoder-decoder 两类场景说明怎样选择参数,避免提示词变长后输出预算失控。373 收藏