
LoRA 合并权重后输出变化过大应检查什么
来源:17golang原创
时间:2026-10-09 02:57:58 404浏览 收藏
LoRA 合并后输出变化很大,先不要急着重训。PEFT 的 merge_and_unload() 会把适配器增量并入基础模型,得到可以独立推理的模型;在基础 checkpoint、adapter、缩放配置、dtype、tokenizer 和生成参数都一致时,合并前后的结果应该接近。差异明显时,通常是对照链不一致,或者量化、随机采样把小误差放大了。
官方地址:https://huggingface.co/docs/peft/en/conceptual_guides/lora
- 先核对同一个 base model、同一个 adapter 和同一个 tokenizer,再谈合并是否正确。
- 重点检查
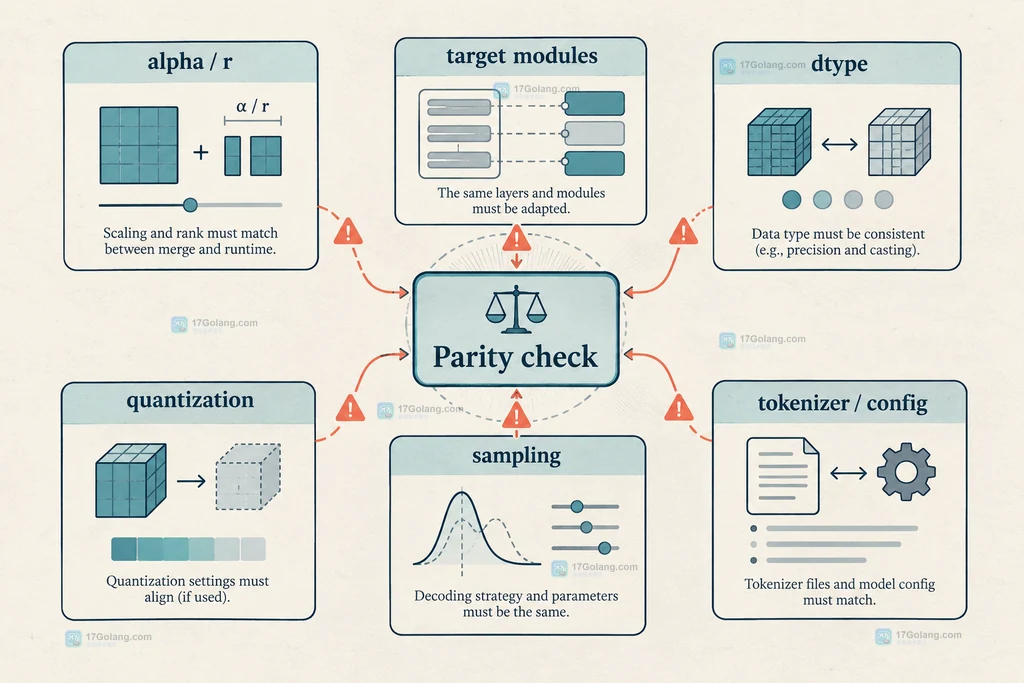
lora_alpha / r、target_modules、modules_to_save、量化与 dtype。 - 先用贪心生成或 logits 对照复现,确认差异不是采样种子、温度或缓存造成的。
先把合并前后的对照路径固定
运行时加载 LoRA 的路径是“基础权重 + adapter 增量”,而合并路径是把同一份增量写回基础权重后再推理。两条路径必须从同一个基础模型目录、同一个 adapter 版本和同一个激活适配器开始。只要把训练时的 base model 换成了同名但不同 revision 的 checkpoint,输出变化就可能被误判成 merge 错误。
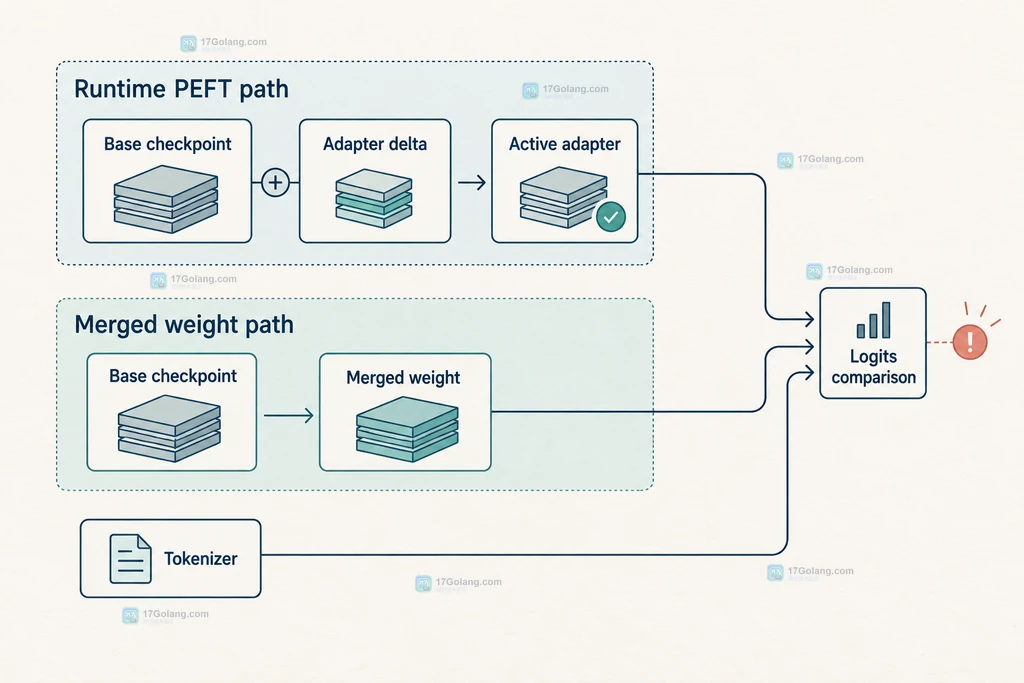
先记录四项事实:adapter_config.json 中的 base_model_name_or_path,实际加载的 revision,当前 active adapter 名称,以及 tokenizer 的词表和 special tokens。若是多 adapter 场景,确认没有把 set_adapter() 切到另一份权重;若用 add_weighted_adapter(),还要记录每个 adapter 的权重。
缩放系数和目标层是最容易被忽略的根因
LoRA 不是简单把两个文件相加。PEFT 会按配置把低秩更新缩放,经典形式是 lora_alpha / r;启用 Rank-Stabilized LoRA 时,缩放形式会变成 lora_alpha / sqrt(r)。因此,重新创建配置、手动转换权重或只复制 A/B 矩阵,都可能让增量强度改变。
| 检查项 | 异常表现 | 处理方式 |
|---|---|---|
| base revision | 合并后整体风格和知识都变 | 锁定训练时的 commit 或 revision |
| active adapter | 同一输入像不同任务 | 明确调用 set_adapter() |
| alpha、rank、target_modules | 任务特征过强或几乎消失 | 以 adapter 配置为准,不手填新配置 |
| modules_to_save | 分类头或 embedding 不一致 | 确认额外保存模块也随模型导出 |
PEFT 文档还区分了 merge_adapter() 和 merge_and_unload():前者保留 PeftModel,方便后续 unmerge 或切换 adapter;后者得到普通基础模型。排查阶段优先保留一份未合并的 PEFT 模型,避免把唯一对照物覆盖掉。
先比较 logits,再判断是不是量化误差
不要一上来只看完整生成文本。先关闭采样,用固定输入比较两条路径的 logits;如果 logits 接近而文本不同,优先查 temperature、top_p、随机种子和停止条件。如果 logits 已明显偏离,再查 dtype、量化和加载路径。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel

base_id = "your-base-model"
adapter_id = "your-lora-adapter"
text = "请用一句话解释 LoRA 合并的目的。"

tokenizer = AutoTokenizer.from_pretrained(base_id)
runtime_base = AutoModelForCausalLM.from_pretrained(base_id, torch_dtype=torch.float32).eval()
merge_base = AutoModelForCausalLM.from_pretrained(base_id, torch_dtype=torch.float32).eval()
runtime_model = PeftModel.from_pretrained(runtime_base, adapter_id).eval()
merge_model = PeftModel.from_pretrained(merge_base, adapter_id).eval()

inputs = tokenizer(text, return_tensors="pt")
with torch.inference_mode():
    # 运行时 adapter 路径:保留 PEFT 包装器作为对照
    runtime_logits = runtime_model(**inputs).logits
    # 合并后路径:用同一 base 与 adapter 的独立副本作为对照
    merged_model = merge_model.merge_and_unload().eval()
    merged_logits = merged_model(**inputs).logits

max_diff = (runtime_logits - merged_logits).abs().max().item()
print(f"最大 logits 差异: {max_diff:.6g}")  # 先看数值差异,再看生成文本
这段代码只用于建立可重复的对照,不代表某个具体模型的实测数值。若高精度对照接近,而 4-bit/8-bit 合并后偏差变大,应把“量化后合并”单独作为实验变量:先用未量化或同 dtype 的基础模型完成合并,再在部署阶段做一次明确的量化,并用同一组评测样本回归。
把随机生成和 tokenizer 差异排除后再保存模型
文本输出不是稳定的数值指标。排查时固定 do_sample=False、max_new_tokens、prompt 模板和停止 token,必要时直接比较 logits。确认两条路径一致后,再保存 merged checkpoint,并把原始 adapter 和 adapter_config.json 一并归档,便于回滚。
如果只在聊天模板下出现差异,重点检查 tokenizer 的 chat template、BOS/EOS 设置、padding side 和 special tokens;如果只有长上下文或 batch 推理异常,再检查 attention mask、KV cache 复用和设备 dtype。不要用一次随机生成的长文本直接判定合并失败。
常见问题
合并后模型文件变大,是不是合并错了?
不一定。独立模型通常保存完整基础权重,本来就会比只有低秩增量的 adapter 大;文件体积不能替代输出对照。
QLoRA 的 adapter 能直接合并到 4-bit 基础模型吗?
不要把“能加载”当成“适合合并”。先用明确的 dtype 和量化策略做小规模对照;若差异过大,回到更高精度基础权重合并,再单独量化并回归。
merge_adapter() 和 merge_and_unload() 怎么选?
需要保留 PEFT 包装器、切换或取消合并时选前者;准备导出独立模型时选后者,并保留未合并副本。
-
234 收藏
-
173 收藏
-
369 收藏
-
284 收藏
-
387 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习