
RAG把检索片段绑定到可追溯引用的实现方法
来源:17golang原创
时间:2026-09-15 22:53:40 171浏览 收藏
我在第一次给 RAG 接引用时,做过一个看起来很省事的版本:检索器返回几段文本,模型回答完,再把几个文档链接拼到末尾。问题很快暴露出来——链接能打开,却不知道回答中的哪句话来自哪一段,重排或过滤一次,引用编号还会错位。
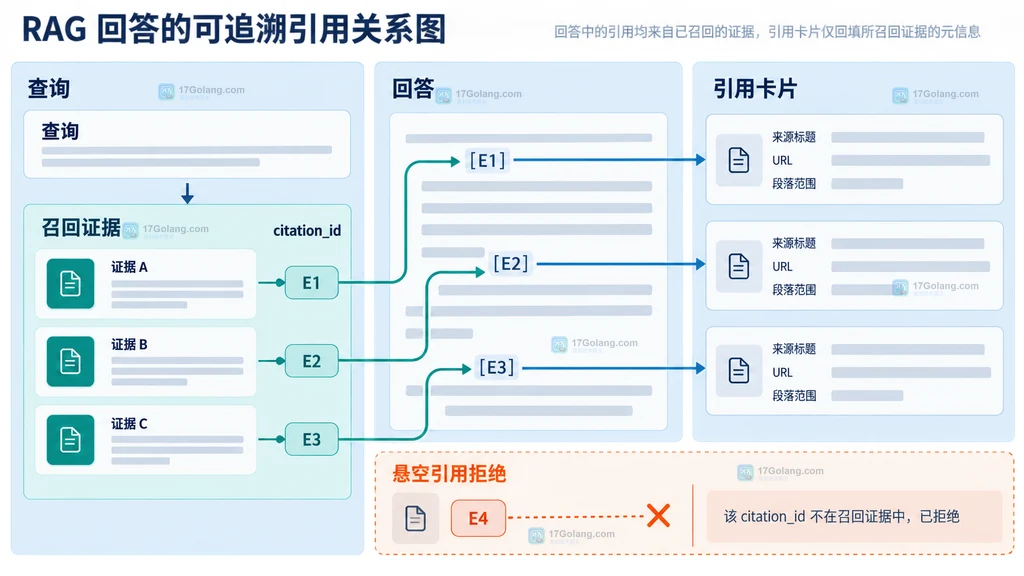
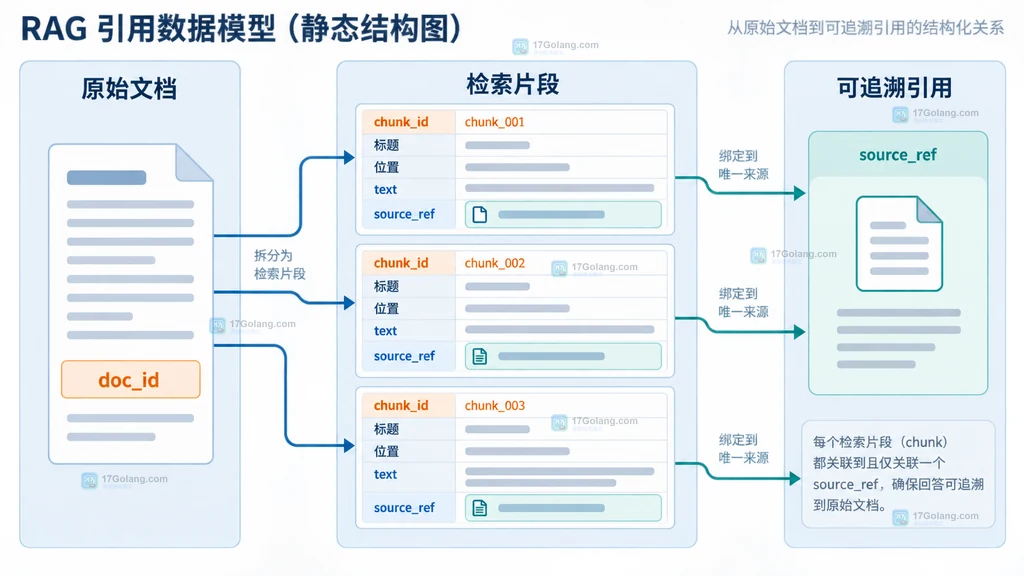
更稳的实现是把检索片段当成证据对象处理:入库时保存稳定的文档身份和位置,召回时生成只属于本次结果的 citation_id,回答只能引用这些 ID,最后再从证据表回填标题、URL 和段落范围。这样引用跟着片段走,不跟着数组下标走。
- 每个片段至少绑定 doc_id、chunk_id、位置和 source_ref,引用才有回溯路径。
- citation_id 是一次回答的局部标识,不能直接把向量库主键当成展示编号。
- 渲染前检查引用是否来自实际召回集合,并记录悬空引用、引用覆盖率和来源一致性。
官方参考地址:https://developers.llamaindex.ai/python/framework/module_guides/loading/documents_and_nodes/。LlamaIndex 文档把 Document 和 Node 作为数据与分块的核心抽象;本文只讨论应用层证据绑定,不把它描述成框架自带的引用协议。
先把来源身份写进每个检索片段
旧写法通常只保存 text 和 score。分数能帮助排序,却不能说明来源;而且同一份文档被重新切分后,数组下标和向量库内部 ID 都可能变化。我的做法是为原始文档生成不随重排改变的 doc_id,再给每个片段分配 chunk_id,同时保存标题、页码或段落范围。
from dataclasses import dataclass
from typing import Optional

@dataclass(frozen=True)
class Evidence:
    text: str
    doc_id: str
    chunk_id: str
    title: str
    source_url: str
    locator: str
    score: float

def to_evidence(node, score: float) -> Evidence:
    meta = node.metadata
    # 中文注释:来源身份来自入库元数据,不能用本次召回数组下标替代。
    return Evidence(
        text=node.get_content(),
        doc_id=meta["doc_id"],
        chunk_id=meta["chunk_id"],
        title=meta["title"],
        source_url=meta["source_url"],
        locator=meta.get("locator", "未记录位置"),
        score=score,
    )
这里的 source_url 应指向你实际维护的来源记录,locator 则可以是 PDF 页码、Markdown 标题或数据库记录范围。不要只存一个网页链接:网页内容会更新,只有文档版本、抓取批次或内容哈希也纳入元数据,后续才有机会解释“当时引用的到底是哪一版”。
把检索结果变成一次回答的证据表
召回后不要直接把 Node 列表插入提示词。先建立一个本次回答的证据表,把每条结果映射成局部的 CIT-1、CIT-2。这个编号只服务当前回答,重新检索、过滤或重排后重新生成,避免客户端缓存了旧编号。
| 字段 | 来源 | 展示或校验用途 |
|---|---|---|
| citation_id | 本次召回生成 | 让模型引用实际证据 |
| chunk_id | 入库时固定 | 定位原文片段 |
| source_url、locator | 来源元数据 | 渲染可点击或可复制的出处 |
| score | 检索器返回 | 排序和阈值判断,不直接当作事实证明 |
def build_evidence_table(nodes):
    table = {}
    for index, node_with_score in enumerate(nodes, start=1):
        evidence = to_evidence(node_with_score.node, node_with_score.score)
        citation_id = f"CIT-{index}"
        # 中文注释:编号只在这次回答内有效,证据对象本身仍靠稳定 chunk_id 定位。
        table[citation_id] = evidence
    return table

def prompt_context(table):
    lines = []
    for citation_id, evidence in table.items():
        # 中文注释:把编号和原文放在同一条记录中,降低模型错配来源的机会。
        lines.append(f"[{citation_id}] {evidence.title} | {evidence.text}")
    return "\n".join(lines)
提示词中要写清边界:只能引用给出的 CIT-*,没有证据就说无法从资料确认。应用层解析回答时,再用正则或结构化输出提取引用 ID,并丢弃不在 table 中的编号。这里的检查不是为了让模型“更聪明”,而是把错误引用变成可观测的失败。
让回答只引用实际召回的证据
引用渲染应晚于回答解析。先得到回答正文和引用 ID,再回查证据表,补出来源标题、URL 和位置;不要允许模型自由生成 URL。若某个引用 ID 被过滤掉,保留回答文字并显示“该句缺少可用出处”,或者触发一次更窄的检索,取舍取决于业务对完整性的要求。
def render_citations(answer_text, citation_ids, table):
    cards = []
    for citation_id in citation_ids:
        evidence = table.get(citation_id)
        if evidence is None:
            # 中文注释:拒绝悬空引用,避免展示模型臆造的出处。
            continue
        cards.append({
            "id": citation_id,
            "title": evidence.title,
            "url": evidence.source_url,
            "locator": evidence.locator,
        })
    return {"answer": answer_text, "citations": cards}
回归时我会看三项:引用覆盖率(有多少可核实结论带了有效 ID)、悬空引用率(出现了多少未召回编号)、来源一致性(引用卡片的标题和位置是否仍属于对应 chunk)。向量分数只能作为排序信号,不能单独决定“这句话一定正确”。
从无引用旧实现迁移时的检查清单
迁移不必一次重写整个 RAG。先给入库任务补齐 doc_id、chunk_id、source_url 和 locator;再在召回适配器外包一层证据表;最后把前端的链接拼接改成统一渲染器。旧数据缺少位置时,可以先展示文档级出处,但要明确这是降级状态,不能伪装成精确段落引用。
- 数据层:来源身份是否稳定,重切分后能否定位旧片段。
- 检索层:过滤、重排后是否重新生成 citation_id。
- 生成层:模型是否只能选择证据表中的 ID。
- 展示层:URL、标题和位置是否由服务端回填。
- 监控层:是否记录空引用、悬空引用和覆盖率变化。
常见问题
可以直接把向量数据库的主键当引用编号吗?
不建议。主键适合内部定位,展示编号应是本次回答的局部 ID;两者分开,重排和分页时更不容易错配。
只有 URL 没有页码时还能追溯吗?
可以做文档级追溯,但不能声称精确定位。应在元数据中保留版本、标题或内容哈希,缺少段落范围时明确降级。
引用覆盖率越高越好吗?
不一定。无关句子堆满引用会降低可读性。应优先覆盖可验证结论,并同时观察来源相关性和悬空引用率。
LlamaIndex 会自动生成这种引用吗?
它提供 Document、Node、metadata 和 relationships 等基础抽象;具体的 citation_id、证据表和渲染规则仍应由应用层定义。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
234 收藏
-
科技周边 · 人工智能 | 3小时前 | 错误处理 · 参数校验 · agent · openai api · AI工程 · Tool calling · 函数调用 业务错误 JSON Schema Tool calling strict 工具参数校验 模型错误380 收藏
-
191 收藏
-
科技周边 · 人工智能 | 7小时前 | 人工智能 · 结构化输出 · JSON解析 · 模型输出 · 接口容错 · 大模型结构化输出 模型输出JSON缺字段 JSON兜底解析 JSON Schema校验 AI接口异常处理272 收藏
-
251 收藏
-
357 收藏
-
473 收藏
-
381 收藏
-
195 收藏
-
162 收藏
-
246 收藏
-
145 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习