
Redis Pipeline批量请求的延迟收益与内存边界
来源:17golang原创
时间:2026-09-20 14:08:17 426浏览 收藏
批量写入 Redis 时,Pipeline 的收益和风险其实来自同一个动作:先把多条命令排队,再集中发送和读取回复。它能把多次网络往返压缩成较少的通信轮次,但 Redis 仍要暂存尚未交付的回复,客户端也会保留待执行命令。批次越大不一定越快,真正要调的是“少付几次 RTT”和“不要让两端队列失控”之间的平衡。
官方地址:https://redis.io/
- Pipeline 主要减少 RTT;它不会把普通命令变成事务。
- 批次边界要同时约束客户端命令队列和服务端回复缓存。
- 先用小批次建立延迟、吞吐和内存基线,再逐步放大。
Redis Pipeline为什么能降低批量请求延迟
逐条调用 Redis 时,客户端发出一条命令,等待响应,再发下一条。即使命令本身只花很短时间,网络往返也会重复累积。Pipeline 则允许客户端先连续写入多条请求,最后集中读取响应;命令顺序仍按提交顺序返回。
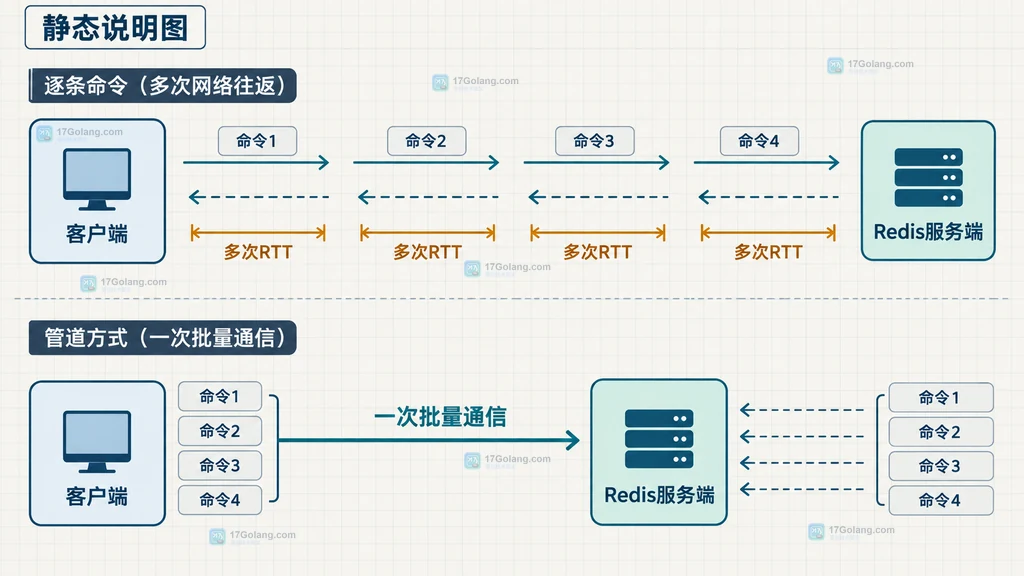
因此,Pipeline 更适合一批互相独立的 GET、SET 或统计命令。若后一个命令必须使用前一个命令的实时返回值,客户端仍然需要在中间读取结果;如果还要求一组命令不被其他客户端插入,则应明确使用事务或 Lua,而不能把“批量发送”误当成原子性。
批量大小要同时照顾客户端队列和服务端回复
Redis 官方文档特别提醒:Pipeline 期间服务端会为尚未交付的回复使用内存。所以一次把几十万条命令塞入 Pipeline,可能让客户端请求队列、网络缓冲和 Redis 回复缓存一起变大。更稳的做法是切成固定批次,每批执行后读取结果,再进入下一批。
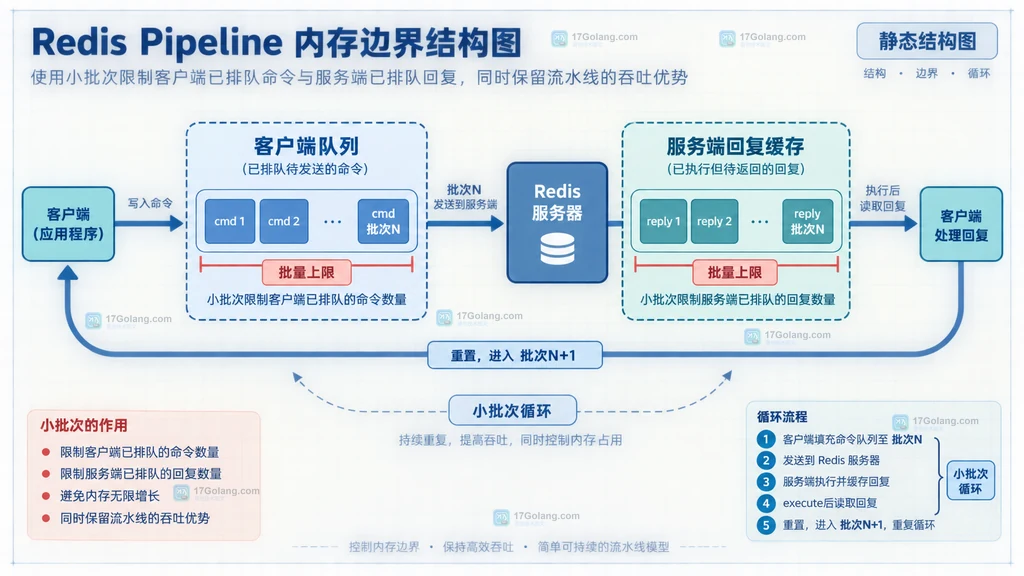
下面的示例使用 redis-py。这里关闭事务模式,只需要批量缓冲,不需要 MULTI/EXEC 的原子语义:
import redis

client = redis.Redis.from_url(
    "redis://127.0.0.1:6379/0",
    decode_responses=True,
)

def write_in_batches(items, batch_size=500):
    """分批写入,避免一次排队过多命令和回复。"""
    for start in range(0, len(items), batch_size):
        batch = items[start:start + batch_size]
        pipe = client.pipeline(transaction=False)
        for key, value in batch:
            # 只把独立写命令放入当前批次,统一在 execute 时发送。
            pipe.set(key, value)
        try:
            # 读取本批全部回复后,才进入下一批,形成内存边界。
            pipe.execute()
        except redis.RedisError:
            # 生产环境应记录批次起点并按幂等策略重试,避免盲目重放。
            raise

items = [(f"profile:{i}", f"user-{i}") for i in range(5000)]
write_in_batches(items, batch_size=500)
batch_size=500只是一个可测的起点,不是 Redis 的固定推荐值。单条回复很小、网络 RTT 较高时,可以逐步增大;回复包含大字符串、网络带宽紧张或客户端内存上涨时,应先减小。事务模式还会改变执行语义和服务端排队方式,不能只为“看起来更快”就打开。
用延迟、吞吐和内存现象选择批次
| 现象 | 可能原因 | 调整方向 |
|---|---|---|
| 批量变大后耗时下降很少 | RTT 已不是主要成本,服务端命令处理或网络带宽占主导 | 停止放大,转看命令复杂度和响应体积 |
| 吞吐提高但客户端内存持续上涨 | 命令对象或待处理回复在单批中积累 | 减小批次,及时 execute 并释放临时对象 |
| Redis 内存和延迟同时抖动 | 服务端回复缓存与其他请求争用资源 | 缩短单批,错开高峰并观察慢命令 |
| 批量写入失败后重跑出现重复效果 | 命令并非幂等,重试边界没有记录 | 按批次记录进度,优先使用可幂等写法 |
实践中我会先固定数据规模和连接方式,只改变批量大小,记录 p95 延迟、每秒命令数、客户端进程内存和 Redis used_memory 的变化。若从 500 增到 1000 后吞吐只小幅提升,却明显拉长单批耗时,就没有必要继续追求更大的数字。Pipeline 的目标是降低通信开销,不是把所有任务变成一个超大队列。
常见问题
Pipeline 会自动保证命令原子性吗?
不会。它首先是通信批处理机制;需要事务边界时要显式选择事务或 Lua,并单独评估失败语义。
批量越大,Redis QPS 一定越高吗?
不一定。RTT 成本下降后,服务端处理、响应大小、带宽和内存压力会成为新的瓶颈。
应该先调客户端还是 Redis 服务端参数?
先从客户端批次和单批响应大小入手建立基线,再结合 Redis 延迟和内存观测判断是否存在服务端资源争用。
把 Pipeline 写成“固定批次、执行、读取、记录”的循环,通常比一次性追求最大队列更容易解释、回滚和调优。批次大小最终应由真实数据体积和延迟曲线决定。
-
461 收藏
-
226 收藏
-
476 收藏
-
489 收藏
-
485 收藏
-
349 收藏
-
236 收藏
-
130 收藏
-
364 收藏
-
309 收藏
-
354 收藏
-
223 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习