
cgroup v2 限制服务内存并观察回收事件
来源:17golang原创
时间:2026-10-03 21:31:11 494浏览 收藏
服务内存异常时,先别急着把机器的总内存调大。cgroup v2 更适合把“这一个服务最多能用多少”和“达到压力后如何回收”拆成两层:用 memory.high 施加回收压力,用 memory.max 设置硬边界,再用 memory.current、memory.events 和 memory.events.local 判断究竟发生了什么。
memory.high是压力阈值,超过后会触发更重的回收和节流,不等同于立即 OOM。memory.max是硬上限,无法回收时可能在该 cgroup 内触发 OOM。memory.events默认包含层级统计,定位当前服务时还要对照memory.events.local。
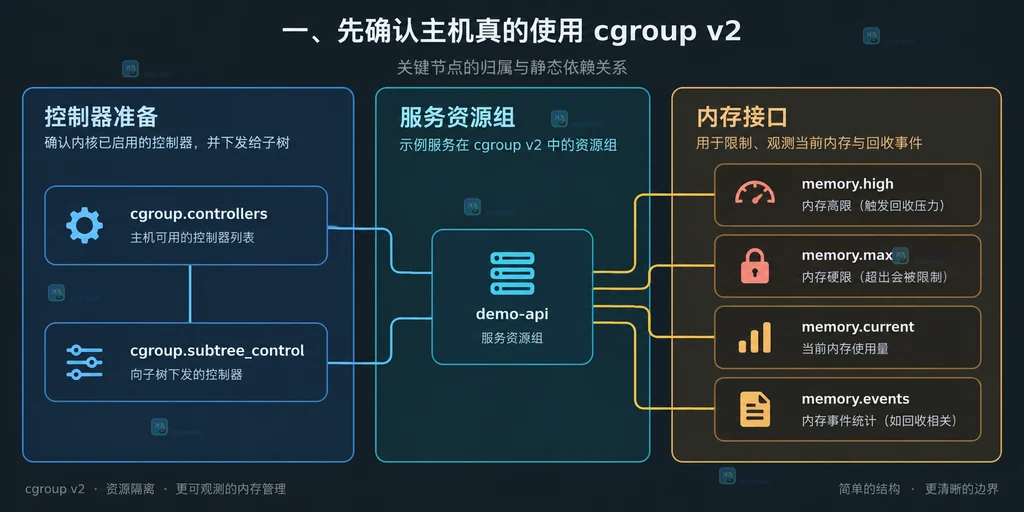
一、先确认主机真的使用 cgroup v2
先查看挂载点和可用控制器。以下命令只读系统状态,示例路径假定统一层级挂在 /sys/fs/cgroup。
# 确认目标目录是否为 cgroup2 文件系统
stat -fc %T /sys/fs/cgroup

# 查看当前层级可以向子 cgroup 提供哪些控制器
cat /sys/fs/cgroup/cgroup.controllers

# 查看根层级已经向子 cgroup 开启了哪些控制器
cat /sys/fs/cgroup/cgroup.subtree_control
第一条命令应看到 cgroup2fs。如果 cgroup.controllers 中没有 memory,先检查内核配置、挂载方式和上级层级,而不是直接向目标目录写入 memory.max。v2 的控制器需要由父层级通过 cgroup.subtree_control 提供给子层级。
二、为服务建立 memory.high 和 memory.max 边界
确认控制器可用后,创建一个只用于示例服务的叶子 cgroup。这里把可回收压力阈值设为 512 MiB,把硬上限设为 768 MiB;实际数值应根据服务稳定工作集、缓存策略和突发流量压测结果确定。
# 创建服务专用的 cgroup 目录
sudo mkdir -p /sys/fs/cgroup/demo-api

# 超过该值后增加回收压力和节流,但不直接等同于 OOM
echo 512M | sudo tee /sys/fs/cgroup/demo-api/memory.high

# 无法继续回收时的硬边界;max 表示不设硬上限
echo 768M | sudo tee /sys/fs/cgroup/demo-api/memory.max

# 读取内核实际接受的值,避免只相信写入命令没有报错
cat /sys/fs/cgroup/demo-api/memory.high
cat /sys/fs/cgroup/demo-api/memory.max
memory.high 适合做服务保护的第一道边界:它让超出阈值的工作负载承受更强回收压力。memory.max 才是硬限制,但内核文档也明确指出,某些情况下使用量可能暂时超过它,且部分分配路径不会按普通 OOM 方式处理。因此这两个值不能简单理解成“512 MiB 和 768 MiB 两个精确瞬时开关”。
三、让服务进程真正归属这个 cgroup
只创建目录并不会改变服务归属。对已经启动的单进程服务,可以把 PID 写入 cgroup.procs;systemd 管理的服务则更适合把限制写到 unit,让重启后仍然有效。
# 读取目标服务的 PID;这里的服务名仅作示例
pid="$(systemctl show -p MainPID --value demo-api.service)"

# 把主进程加入目标 cgroup,生产环境还要确认子进程继承和权限边界
echo "$pid" | sudo tee /sys/fs/cgroup/demo-api/cgroup.procs

# 核对 PID 当前是否已经出现在目标 cgroup
grep -w "$pid" /sys/fs/cgroup/demo-api/cgroup.procs
如果服务由 systemd 托管,持久配置可以使用资源控制属性:
# 为 unit 写入可持久化的内存压力阈值和硬上限
sudo systemctl set-property demo-api.service MemoryHigh=512M MemoryMax=768M

# 查看 systemd 展开的属性,确认 unit 层配置已生效
systemctl show demo-api.service -p MemoryHigh -p MemoryMax
手工写 cgroup 文件适合排查和一次性实验;长期运行的服务应让 systemd 或其他编排层成为唯一配置来源,避免重启、迁移和子进程管理把限制丢掉。
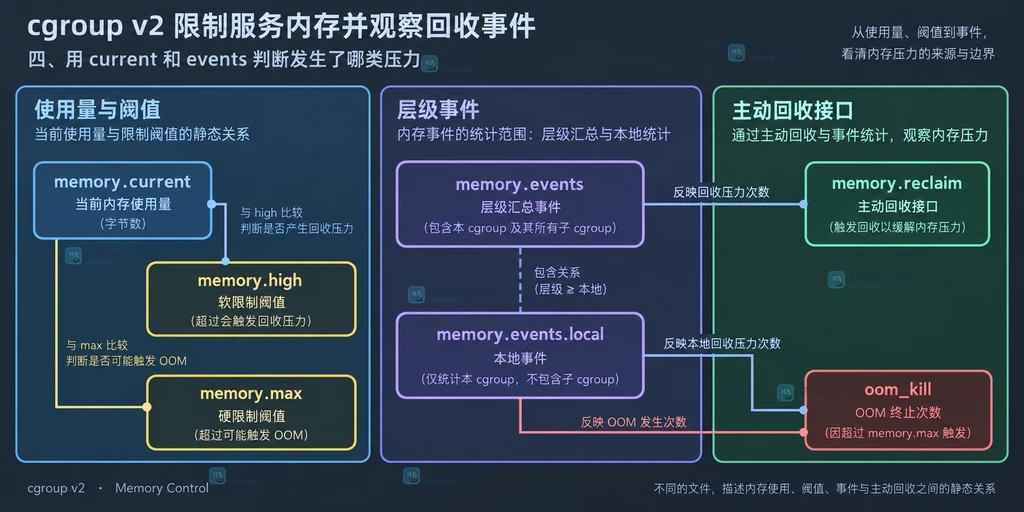
四、用 current 和 events 判断发生了哪类压力
先看当前使用量,再看事件计数。计数变化说明边界曾被触碰,但不能单独证明某一次请求就是唯一原因。
# 当前 cgroup 的内存使用量,单位为字节
cat /sys/fs/cgroup/demo-api/memory.current

# 读取包含子层级的事件统计
cat /sys/fs/cgroup/demo-api/memory.events

# 只读取 demo-api 自身产生的事件,便于排除子 cgroup 干扰
cat /sys/fs/cgroup/demo-api/memory.events.local
常见字段可以这样理解:
| 字段 | 它说明什么 | 排查重点 |
|---|---|---|
high | 内存使用触碰过 high 边界 | 工作集是否长期高于阈值,是否出现持续节流 |
max | 使用量触碰过 max 边界 | 回收是否跟不上,是否需要拆分缓存或降低并发 |
oom | cgroup 内发生过 OOM 触发 | 结合服务日志和进程退出时间判断影响面 |
oom_kill | 发生过 OOM kill | 优先保留计数与日志,不要只看一次 current |
五、按照现象调整,而不是看到 max 就盲目放大
如果 high 持续增长而 oom_kill 不变,通常先检查工作集、缓存上限和并发,再评估是否提高 memory.high。如果 max、oom 或 oom_kill 增长,要把它当作硬边界告警,核对服务是否被杀、是否有子 cgroup 分摊,以及 memory.events 的层级统计是否把后代事件算进来了。
复查时至少保留三份信息:限制值(memory.high、memory.max)、当前值(memory.current)和事件快照(memory.events.local)。如果需要主动回收,memory.reclaim 可以触发目标 cgroup 的回收,但它是管理接口,不能用来伪造“发生了内存压力”的业务证据;回收结果也可能多于或少于请求值。
常见问题
memory.high 达到后会马上杀掉服务吗?
不会。它主要引入更重的回收和节流;真正的硬边界是 memory.max,也仍应结合事件和服务日志判断结果。
为什么 memory.events 和 memory.events.local 数字不一样?
memory.events 默认是层级统计,可能包含后代 cgroup;memory.events.local 只看当前 cgroup。服务拆分子组时应同时读取两者。
systemd 和手工写 memory.max 选哪个?
一次性定位问题可以手工写文件;长期服务优先使用 systemd 的 MemoryHigh、MemoryMax,让限制和 unit 生命周期一起管理。
最后用一张清单复查:控制器是否已向子层级开放、服务 PID 是否在目标 cgroup、high/max 是否符合工作集、events 是否按 local 与 hierarchy 分开解释。这样看到“回收事件增加”时,才能知道是在保护服务,还是已经撞上了硬边界。
-
426 收藏
-
387 收藏
-
242 收藏
-
238 收藏
-
402 收藏
-
462 收藏
-
324 收藏
-
440 收藏
-
326 收藏
-
369 收藏
-
475 收藏
-
229 收藏
-
471 收藏
-
415 收藏
-
277 收藏
-
298 收藏
-
347 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习