
Python subprocess.Popen pipesize 什么时候有效
来源:17golang原创
时间:2026-10-04 19:48:26 187浏览 收藏
我第一次把 pipesize 加进 subprocess.Popen(),是因为一个子进程会连续输出较大的日志。结果很容易产生误解:参数写上了,不代表任何平台都扩大了管道,也不代表程序从此不会阻塞。判断它什么时候有效,关键看两个条件:stdin、stdout 或 stderr 是否真的使用了 subprocess.PIPE,以及运行环境是否支持改变管道容量。
pipesize从 Python 3.10 加入,当前 CPython 文档说明只有 Linux 会实际调整由PIPE创建的管道。- 它改变的是操作系统管道容量;
bufsize改的是 Python 文件对象的缓冲策略,不能混为一谈。 - 即使增大容量,也应使用
communicate()或持续读取输出,不能靠更大的管道解决所有死锁。
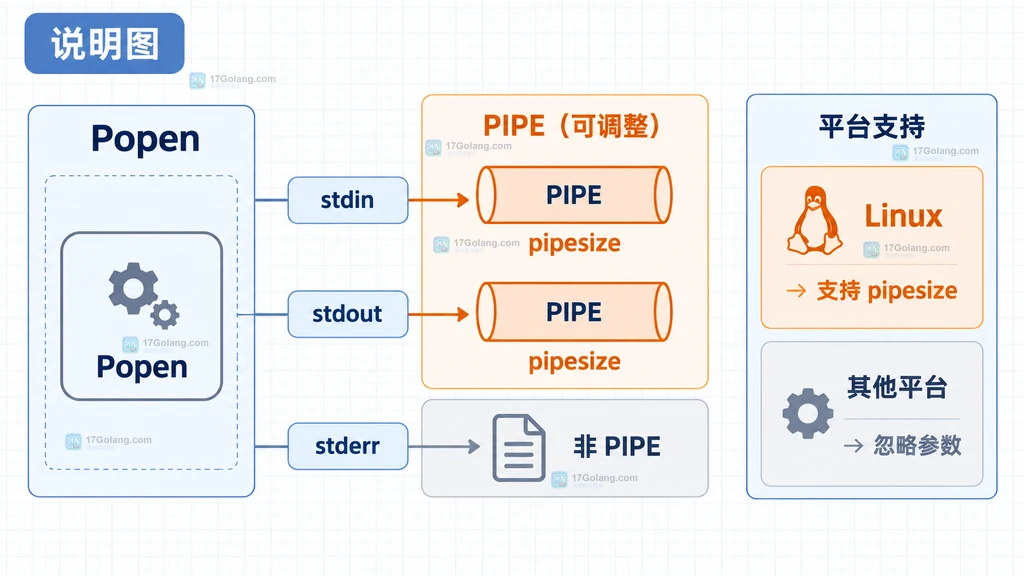
先看 PIPE 和平台,才能判断 pipesize 是否生效
Popen 的 pipesize 不是全局缓存开关。只有某个标准流的值是 subprocess.PIPE,Python 才有一条自己创建的管道可以尝试调整;如果输出直接继承父进程、重定向到文件,或者传入了已有文件描述符,这个参数就不是在调那条管道。
平台也很重要。Python 官方文档把 pipesize 标记为仅在支持该能力的平台上调整,目前明确写出的支持平台是 Linux,其他平台会忽略该参数。因此在 Windows 或 macOS 上,代码可以保留这个关键字,但不能把它当作容量已经变大的证明。
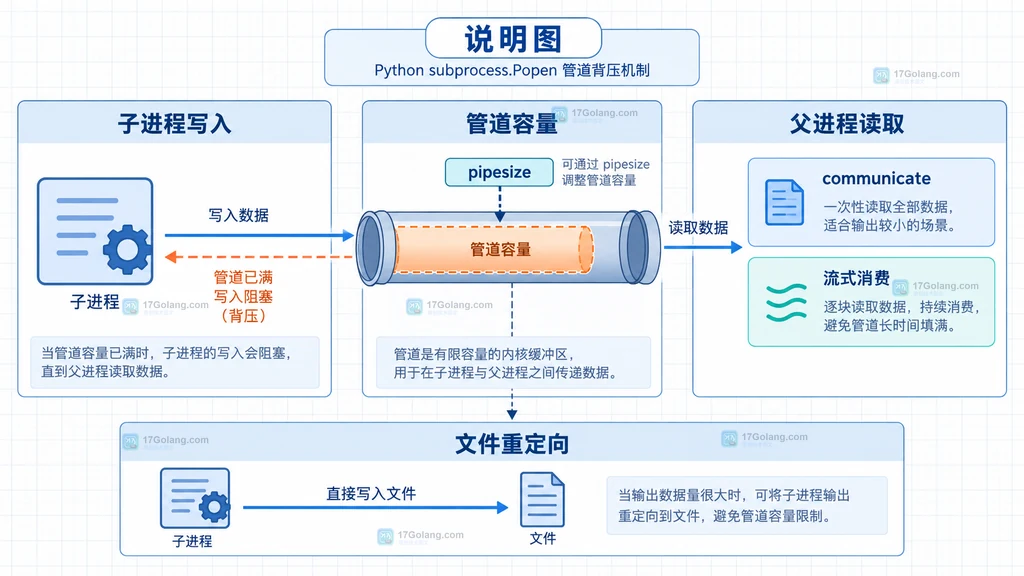
pipesize 和 bufsize 调的是两层不同的缓冲
pipesize 对应内核管道的容量,影响子进程写入端何时遇到背压;Linux 的管道容量还会受到页大小、/proc/sys/fs/pipe-max-size 和用户管道页限制影响,请求值可能被向上取整或直接被拒绝。它不是“允许写入多少条消息”的精确承诺,管道本身仍然是字节流。
bufsize 则会传给 Python 创建 stdin/stdout/stderr 文件对象时使用的 open() 缓冲层。下面的写法把两个参数放在各自的位置,注释也标明了它们的边界:
import subprocess

proc = subprocess.Popen(
    ["python", "worker.py"],
    stdout=subprocess.PIPE,          # 只有 PIPE 才会创建可调整的输出管道
    stderr=subprocess.STDOUT,        # 合并错误流,避免只读取 stdout 时漏掉错误输出
    text=True,
    bufsize=1,                       # Python 文本流的行缓冲,不是内核管道容量
    pipesize=256 * 1024,             # Linux 上请求更大的 PIPE 容量;其他平台可能忽略
)

try:
    output, _ = proc.communicate(timeout=30)  # 持续收集输出并等待子进程结束
except subprocess.TimeoutExpired:
    proc.kill()                               # 超时先终止子进程,避免留下孤儿进程
    output, _ = proc.communicate()            # 再收尾读取剩余输出

if proc.returncode != 0:
    raise RuntimeError(f"worker failed: {proc.returncode}")
这里的 bufsize=1 只有在文本模式下才表示行缓冲;它并没有把 Linux 管道扩成 256 KiB。反过来,增大 pipesize 也不会让 Python 的读取接口自动变成逐行消费。
真正有效的使用方式:大输出场景配合 communicate
当子进程会产生突发的大量标准输出,而父进程暂时来不及读取时,较大的管道容量可以把短时背压往后推,减少子进程立即卡在 write() 上的概率。它适合日志汇总、编译器诊断或批量转换这类“输出较多但最终仍要整体收集”的场景。
但 Popen.wait() 在同时使用 stdout=PIPE 或 stderr=PIPE 时仍可能因管道写满而死锁,官方文档建议使用 communicate()。如果输出持续增长到内存不可接受,正确方向是流式消费、把输出写入文件、减少子进程日志,或改用 asyncio 子进程接口,而不是不断把 pipesize 调大。
参数边界和采用清单
| 检查项 | 结论 | 处理建议 |
|---|---|---|
标准流是 PIPE | 决定是否存在可调整的 Popen 管道 | 先确认 stdout/stderr/stdin 的重定向方式 |
| Linux 支持 | 才有实际调整容量的路径 | 跨平台代码把 pipesize 当作可选优化,不写成必然行为 |
| 请求值过大 | 可能受内核上限或用户资源限制影响 | 用小步调参并记录异常,别把权限错误吞掉 |
| 读取方式 | 容量大不等于不会死锁 | 优先 communicate 或持续消费两个输出流 |
因此,判断“什么时候有效”的最短答案是:在 Linux 上,Popen 确实创建了 PIPE,并且请求容量没有超过系统允许的范围时,它才可能改变这条管道的容量;其收益仍取决于父进程是否及时消费数据。
常见问题
把 stdout 重定向到文件后,pipesize 还会影响文件写入速度吗?
不会。此时 stdout 不是 Popen 创建的 PIPE,pipesize 不负责调整文件系统缓存或写入吞吐。
pipesize 设置失败时应该忽略异常吗?
不建议无条件忽略。生产代码至少记录平台、请求值和异常;如果参数只是优化,可以降级为默认容量,但不要因此跳过输出读取和超时清理。
增大 pipesize 能替代 communicate 吗?
不能。它只能延后管道写满,不能消除持续输出、双路输出或父子进程等待顺序造成的阻塞。
-
369 收藏
-
344 收藏
-
464 收藏
-
327 收藏
-
349 收藏
-
366 收藏
-
369 收藏
-
158 收藏
-
205 收藏
-
171 收藏
-
410 收藏
-
403 收藏
-
236 收藏
-
218 收藏
-
108 收藏
-
文章 · python教程 | 2天前 | 日志 · logging · Python教程 · Python contextvars request_id LogRecord logging.Filter410 收藏
-
351 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习