
Python memoryview.toreadonly 怎样生成只读视图而不复制底层数据
来源:17golang原创
时间:2026-11-18 13:47:04 470浏览 收藏
如果一个函数只应该读取二进制数据,但调用方手里拿的是可写的 bytearray,直接把原始 memoryview 交出去会留下写入入口。Python 的 memoryview.toreadonly() 适合处理这个边界:它返回一个只读视图,不复制底层缓冲区,原来的视图仍保持原有权限。
官方文档:https://docs.python.org/3/library/stdtypes.html#memoryview
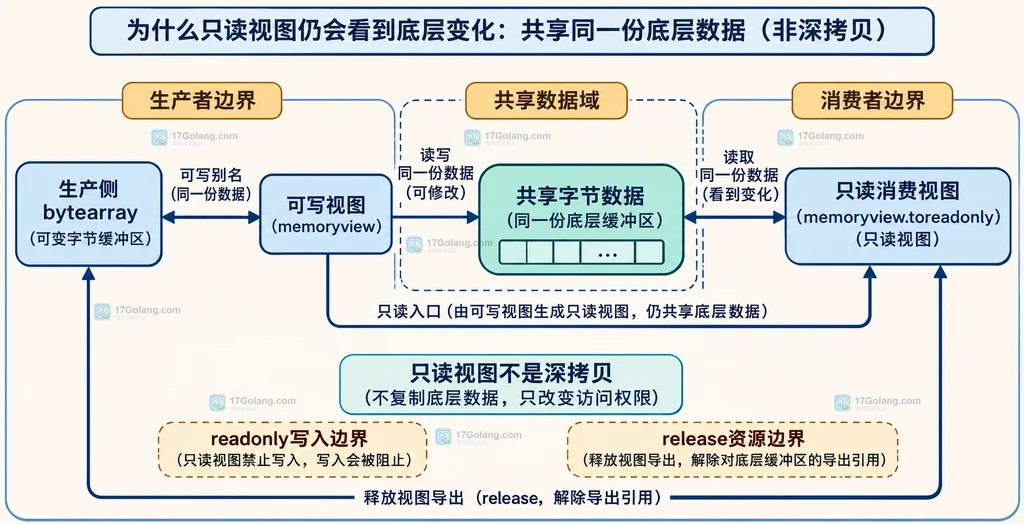
要记住一个容易混淆的点:只读的是“这个视图的访问方式”,不是底层对象突然变成了不可变对象。只要仍有可写别名,底层数据变化后,只读视图也会看到变化。
先看清三层关系:缓冲区、视图和访问权限
memoryview让Python代码访问支持缓冲区协议的对象,而不必先把数据复制成新的字节串。这里可以把它拆成三层:
- 底层缓冲区:例如
bytearray,实际保存字节。 - 可写视图:对底层缓冲区提供读写窗口。
- 只读视图:仍指向同一份数据,但禁止通过它赋值。
因此,toreadonly()解决的是“把数据交给不应修改它的消费者”这个接口问题,而不是“制作一份隔离副本”。
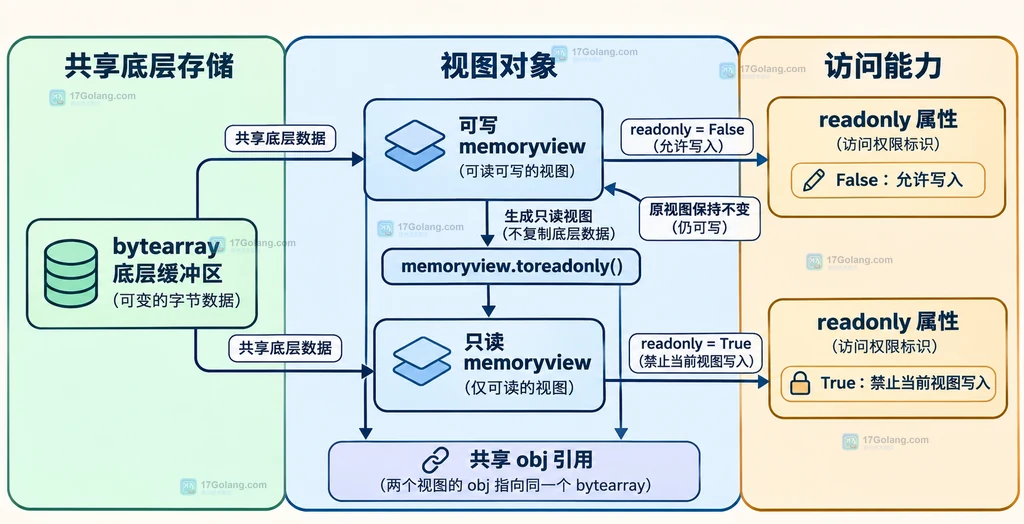
用toreadonly()生成只读视图
最小写法是先创建一个可写视图,再调用 toreadonly():
buffer = bytearray(b"abc")
writable = memoryview(buffer)
readonly = writable.toreadonly()

# 只读属性属于新视图;原来的writable不会被改成只读。
assert writable.readonly is False
assert readonly.readonly is True

# 两个视图仍然引用同一个底层对象,不需要复制abc这三个字节。
assert writable.obj is buffer
assert readonly.obj is buffer

# 读操作照常进行;只读视图上的赋值会被拒绝。
assert readonly.tobytes() == b"abc"
try:
    readonly[0] = ord("A")
except TypeError:
    pass  # 这是预期的保护行为,调用方不能通过readonly写入。
官方文档把返回值描述为原 memoryview 的只读版本,并明确原视图不变。这里的“新”主要是新建一个视图对象;底层的 bytearray 内容没有因此复制。
为什么只读视图仍会看到底层变化
只读限制只作用于 readonly 这个入口。如果生产侧还保留着 writable,它仍能修改同一个 bytearray,消费者手里的只读视图会读到修改后的内容:
buffer = bytearray(b"abc")
writable = memoryview(buffer)
readonly = writable.toreadonly()

# 生产侧通过可写别名更新共享缓冲区。
writable[0] = ord("A")

# 消费侧不能写,但读取到的是同一份底层数据。
assert readonly[0] == ord("A")
assert readonly.tobytes() == b"Abc"
这正是零拷贝视图的取舍:节省了复制成本,也意味着数据生命周期和并发修改责任仍在调用方。若消费者需要一份完全不受后续修改影响的快照,应显式调用 bytes(readonly) 或 readonly.tobytes(),那一步才会产生新的字节数据。
把readonly属性当成能力检查
当一个函数既接受 bytes、bytearray,也接受外部传入的 memoryview 时,不要只根据参数类型猜测能不能写。用 view.readonly 表达当前视图的写入能力更直接:
def consume_packet(view: memoryview) -> int:
    # 这里的函数只读取数据,因此先把写入能力降到只读。
    safe_view = view.toreadonly() if not view.readonly else view

    # nbytes表示连续表示时需要的字节数,不等同于所有格式下的len。
    packet_size = safe_view.nbytes
    # 业务逻辑只读取,不在safe_view上做切片赋值。
    return packet_size


payload = bytearray(b"header-body")
assert consume_packet(memoryview(payload)) == len(payload)
如果输入本来就是只读的,直接复用它可以避免不必要地创建第二个视图对象;如果输入可写,再用 toreadonly()把消费侧的能力收窄。注意,这种做法不会阻止其他别名修改源缓冲区。
别把toreadonly()和深拷贝混为一谈
可以用下面这张判断表快速选型:
| 目标 | 推荐写法 | 是否复制数据 | 后续是否受源缓冲区变化影响 |
|---|---|---|---|
| 共享数据但禁止当前入口写入 | view.toreadonly() | 否 | 是 |
| 得到独立的不可变快照 | bytes(view) | 是 | 否 |
| 继续通过当前入口修改 | 保留可写 memoryview | 否 | 是 |
所以,标题里的“而不复制底层数据”对应的是第一行。它适合数据量大、只需要短暂读取、且所有者能够管理缓冲区生命周期的场景;不适合需要跨线程、跨请求或长期保存独立快照的场景。
持有视图时记得release
对 bytearray 这类对象,导出缓冲区后通常不能随意调整大小。视图不再使用时,可以调用 release(),或者使用上下文管理器让释放更明确:
payload = bytearray(b"abc")

with memoryview(payload).toreadonly() as view:
    # 在上下文中完成读取,离开代码块时释放该视图持有的缓冲区导出。
    first_byte = view[0]

# view已经释放;不要在这里继续索引它。
assert first_byte == ord("a")
release()释放的是视图对底层缓冲区的导出,不是把 bytearray 清空。释放之后继续操作该视图会收到 ValueError;如果只是要让数据继续存在,应保留底层对象,而不是继续使用已释放的视图。
最后用四个问题做判断
- 我需要的是权限收窄,还是独立快照?前者用
toreadonly(),后者用bytes()。 - 是否还有可写别名?如果有,只读视图仍可能看到源数据变化。
- 消费者是否会长期持有视图?如果会,应明确生命周期,并考虑
release()或上下文管理器。 - 输入本身是否已经只读?先看
view.readonly,避免无意义地创建额外视图对象。
一句话总结:memoryview.toreadonly()把“谁可以写”从底层缓冲区的所有者手里,收窄到当前视图的访问能力;它保持共享数据的效率,也把源数据生命周期和别名修改责任留给了调用方。
相关问题
toreadonly()会复制bytearray吗?
不会把底层字节复制成独立快照;它返回只读的视图对象。需要快照时再调用 bytes(view) 或 view.tobytes()。
只读视图能阻止其他地方修改数据吗?
不能。它只禁止通过当前只读视图写入,其他可写视图或底层 bytearray 仍可能改变共享数据。
什么时候需要release()?
当视图不再使用,尤其是底层对象需要调整大小或资源边界需要尽快解除时,应调用 release() 或使用 with。
-
文章 · python教程 | 1小时前 | 标准库 · Python教程 · Python decimal flags 精度 舍入 Context.copy_abs Decimal.copy_abs389 收藏
-
文章 · python教程 | 1小时前 | 字符串 · 标准库 · Python教程 · Python placeholder 文本截断 textwrap TextWrapper max_lines301 收藏
-
411 收藏
-
文章 · python教程 | 4小时前 | 反射 · 调试 · python · Python inspect.getmembers_static inspect.getmembers descriptor __getattr__358 收藏
-
287 收藏
-
341 收藏
-
文章 · python教程 | 8小时前 | 错误处理 · 字符集 · Python教程 · Python MIME email.utils collapse_rfc2231_value RFC 2231330 收藏
-
479 收藏
-
348 收藏
-
275 收藏
-
文章 · python教程 | 9小时前 | 日志 · 标准库 · HTTP · python · Python HTTPS post logging.handlers.HTTPHandler HTTPHandler 远程日志262 收藏
-
205 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习