
Python sqlite3.Connection.backup 怎么在线复制数据库
来源:17golang原创
时间:2026-10-05 05:13:35 264浏览 收藏
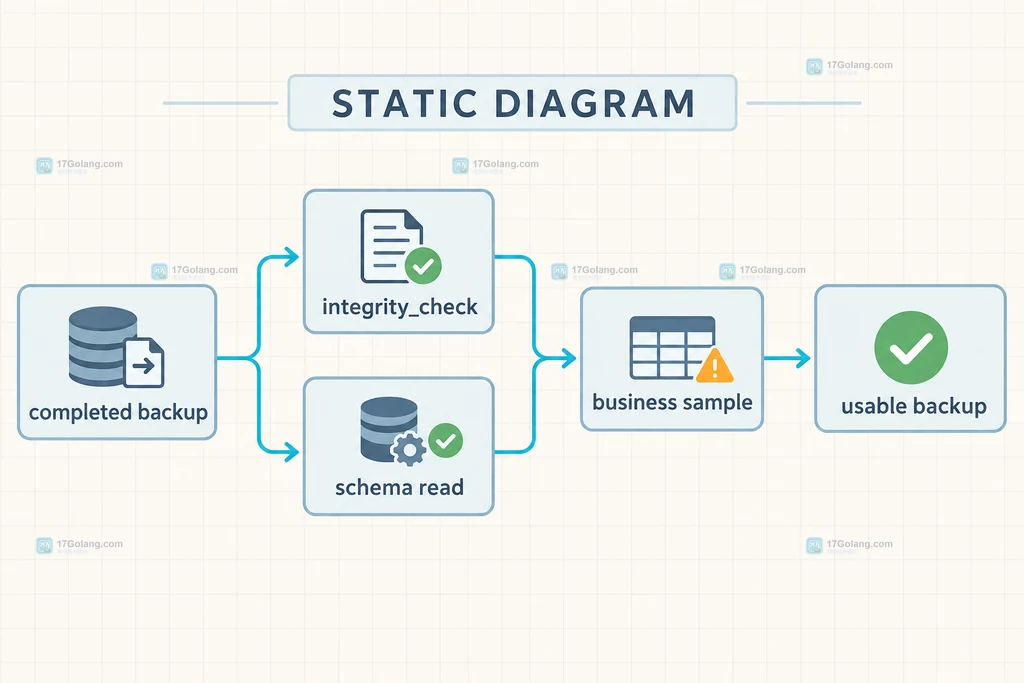
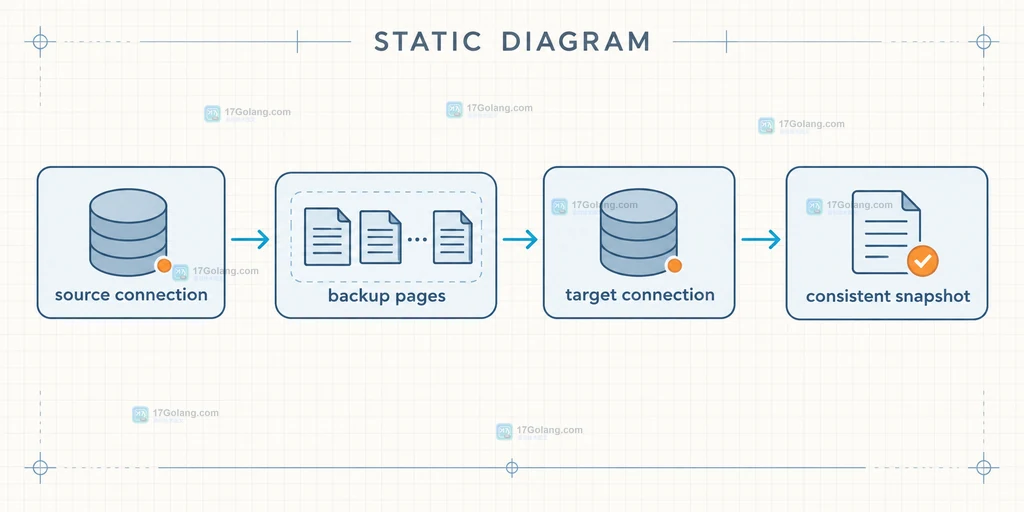
Python 标准库的 sqlite3.Connection.backup() 适合做在线复制:源数据库仍可被其他连接访问,目标连接会得到一个一致快照。最小调用关系是 source.backup(target),不要直接用文件复制命令替代它,因为 SQLite 可能正处在写入或 WAL 检查点阶段。
官方文档:https://docs.python.org/3/library/sqlite3.html
- 源连接调用
backup(),参数是目标连接,目标原有内容会被覆盖。 pages控制每轮复制的页数,sleep控制剩余页之间的等待。- 复制完成后要关闭连接,并在备份副本上做
PRAGMA integrity_check与业务抽样查询。
先把在线复制的最小写法跑通
源库和备份库必须是两个独立的 Connection。目标文件不存在时,sqlite3.connect() 会创建它;目标文件已经存在时,backup() 会用源库内容覆盖目标库,因此生产环境不要把唯一的历史备份当作目标路径。
import sqlite3
from pathlib import Path

def backup_live_db(source_path: str, target_path: str) -> None:
    # 先确保备份目录存在,源连接和目标连接分别管理两个文件。
    Path(target_path).parent.mkdir(parents=True, exist_ok=True)
    source = sqlite3.connect(source_path, timeout=10)
    target = sqlite3.connect(target_path, timeout=10)
    try:
        # pages=16 让复制按小批次推进,适合仍在提供读写服务的源库。
        with target:
            source.backup(target, pages=16, sleep=0.1)
    finally:
        # 无论复制成功还是异常,都释放两个连接,避免文件句柄滞留。
        target.close()
        source.close()

backup_live_db("data/app.db", "backup/app.db")
这里的“在线”并不是零锁等待,而是 SQLite 在复制过程中只短暂读取源库页面,其他客户端通常可以继续工作。备份结果代表复制开始时的数据库快照;如果业务要求把刚写入的数据也纳入备份,应先明确提交时点,而不是在复制后猜测。
pages、sleep 和 progress 怎么配
默认 pages=-1 会一次复制全部页面,数据库较大时可能让源库读锁保持更久。把它改成正数后,每一轮只搬运指定页数,sleep 是剩余页面之间的等待时间。复制速度和业务干扰之间需要按实际负载取舍。
import sqlite3

def copy_with_progress(source_path: str, target_path: str) -> None:
    # 进度回调中的 remaining 和 total 都是 SQLite 页面数,不是字节数。
    def report(status: int, remaining: int, total: int) -> None:
        # total 为 0 时避免除零;status 可用于记录本轮状态码。
        percent = 100.0 if total == 0 else (total - remaining) * 100 / total
        print(f"status={status} progress={percent:.1f}%")

    source = sqlite3.connect(source_path, timeout=10)
    target = sqlite3.connect(target_path, timeout=10)
    try:
        # 小 pages 配合短 sleep,给并发写入留出更多机会。
        with target:
            source.backup(target, pages=32, progress=report, sleep=0.2)
    finally:
        target.close()
        source.close()
progress 每轮收到三个整数:最近一轮状态、剩余页数和总页数。它适合写日志或更新任务状态,不应该在回调中执行耗时 SQL。若源库持续高频写入,复制可能反复遇到锁竞争,应该记录失败原因、调整批次大小或安排低峰备份,而不是无限增加等待时间。
一致性、锁等待与失败处理
在线复制最容易误解的地方有三个。第一,目标库的旧内容会被覆盖,不能把它当作增量备份。第二,源连接与目标连接不能共用同一个文件路径。第三,源连接尚未提交的事务是否进入快照,取决于复制开始时 SQLite 能看到的状态,所以写入方应先完成自己的提交。
| 现象 | 优先判断 | 处理方式 |
|---|---|---|
| 复制很慢 | pages 太大或源库持续写入 | 降低 pages,设置有限 sleep,观察进度 |
| 出现锁等待 | 其他连接持有写事务 | 设置合理 timeout,并让调用方重试整次备份 |
| 目标文件打不开 | 目标路径冲突或复制异常 | 保留失败文件名,修正路径后生成新的目标文件 |
如果备份任务被异常终止,不要继续把同一个目标文件当作成功备份。更稳妥的做法是写入带时间或任务标识的临时目标,复制完成并检查通过后,再由业务层替换正式备份名;替换动作本身不属于 backup() 的职责。
复制完成后如何确认备份可用
不要只看 Python 函数没有抛异常。打开目标连接后,先让 SQLite 做完整性检查,再读取一张关键表的数量或最新记录。检查应针对备份连接执行,避免误把源库的结果当成备份结果。
import sqlite3

def check_backup(target_path: str) -> tuple[str, int]:
    # 只读打开备份副本,检查失败时把异常交给上层任务处理。
    connection = sqlite3.connect(f"file:{target_path}?mode=ro", uri=True)
    try:
        # integrity_check 返回一行文本,正常结果通常是 ok。
        integrity = connection.execute("PRAGMA integrity_check").fetchone()[0]
        # 用业务表做一次轻量抽样,表名应替换为项目中的真实表。
        row_count = connection.execute("SELECT COUNT(*) FROM records").fetchone()[0]
        if integrity != "ok":
            raise RuntimeError(f"backup integrity failed: {integrity}")
        return integrity, row_count
    finally:
        connection.close()
如果备份用于灾备,还应把检查结果、源库标识、复制时间和文件大小一起写入任务记录,并定期在隔离环境中恢复演练。backup() 解决的是一致复制,不等于自动加密、异地保存、保留周期或恢复流程。
常见问题
可以直接复制正在使用的 .db 文件吗?不建议。文件级复制无法可靠表达 SQLite 事务、WAL 和锁的边界;优先使用 Connection.backup() 或 SQLite 官方提供的备份方案。
pages 越小越安全吗?不是。它主要改变锁占用与复制速度的平衡,最终仍要用完整性检查和业务抽样确认目标库。
目标库为什么不能继续保留旧数据?backup() 是把源库内容复制成目标快照,不是按表合并;如果需要历史版本,应使用不同的目标文件或先做保留策略。
-
428 收藏
-
410 收藏
-
344 收藏
-
378 收藏
-
315 收藏
-
370 收藏
-
207 收藏
-
143 收藏
-
187 收藏
-
366 收藏
-
369 收藏
-
158 收藏
-
205 收藏
-
171 收藏
-
410 收藏
-
403 收藏
-
236 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习