
Go http.Request.Clone 为什么不会深复制 Body
来源:17golang原创
时间:2026-10-05 07:47:56 182浏览 收藏
http.Request.Clone 不会深复制 Body,因为 Body 是一个有状态的 io.ReadCloser 流:它可能连接网络、文件、管道或自定义读取器,标准库无法通用地复制其数据、游标和关闭语义。Clone 会复制 URL、Header、Trailer 等可复制字段,但两个请求仍指向同一个 Body。
所以只要任意一方读取或关闭 Body,另一方就会看到同一个游标变化或关闭结果。要独立读取,必须根据请求来源显式创建新的 Body。官方文档:https://pkg.go.dev/net/http
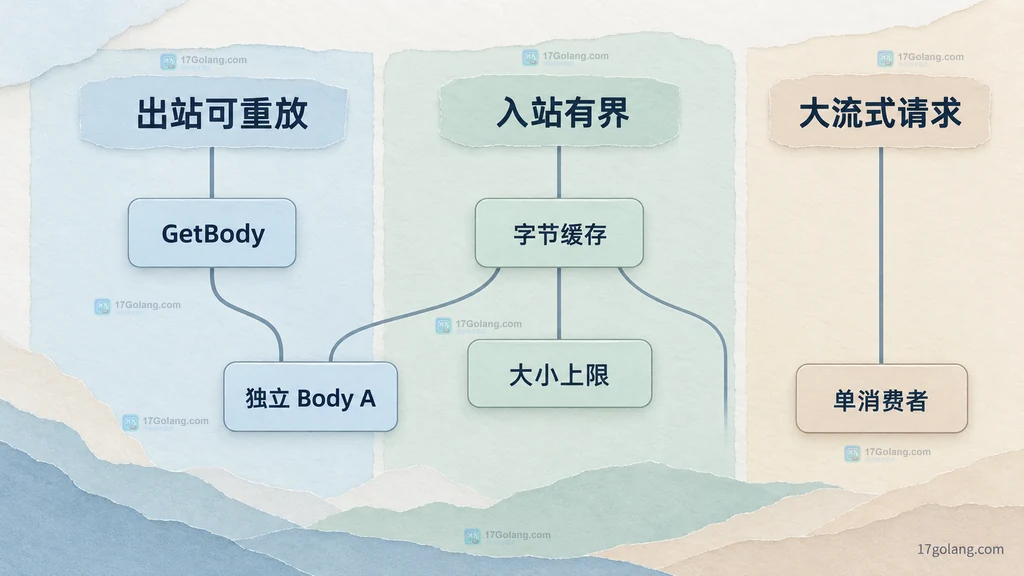
- 只改 context、Header 或 URL,不重复读正文:直接
Clone。 - 出站请求且
GetBody非空:克隆后用GetBody()创建新 Body。 - 入站小请求:设置大小上限,读取一次字节,再为原请求和副本各建一个读取器。
- 大文件、流上传或实时管道:保持单消费者,不要为了克隆而全量缓存。
最小现象:副本读完,原请求也到 EOF
下面的请求由 strings.Reader 创建。虽然 NewRequest 会为这种常见读取器设置 GetBody,但调用 Clone 本身不会自动调用它:
package main

import (
	"context"
	"fmt"
	"io"
	"net/http"
	"strings"
)

func main() {
	req, err := http.NewRequest(http.MethodPost, "https://example.com/orders", strings.NewReader("id=42"))
	if err != nil {
		panic(err)
	}
	defer req.Body.Close() // 原请求与副本共享 Body,因此这里只关闭一次

	cloned := req.Clone(context.Background())

	first, _ := io.ReadAll(cloned.Body) // 读取共享流并推进同一个游标
	second, _ := io.ReadAll(req.Body)   // 此时原请求已经读到 EOF

	fmt.Printf("clone=%q original=%q\n", first, second)
}
常见误判是“Clone 文档说返回 deep copy,所以每个字段都应该独立”。官方文档紧接着专门声明:Clone only makes a shallow copy of the Body field。这不是偶然遗漏,而是 API 对流式资源边界的明确约定。
Clone 的深复制边界在哪里
从标准库源码看,Clone 先复制整个 Request 值,再为 URL、Header、Trailer、TransferEncoding、Form、PostForm、MultipartForm 和路由参数等字段建立独立副本。Body 没有被替换,因此保留初次结构体复制得到的同一个接口值。
这种设计有三个现实原因:
- 读取器不一定可回放:网络流、压缩流和管道一旦消费就不能回到开头。
- 复制成本不可预知:Body 可能是几个字节,也可能是数 GB 文件或无限流。
- 关闭语义无法猜测:两个副本是否各自关闭、何时释放底层连接,必须由拥有资源的代码决定。
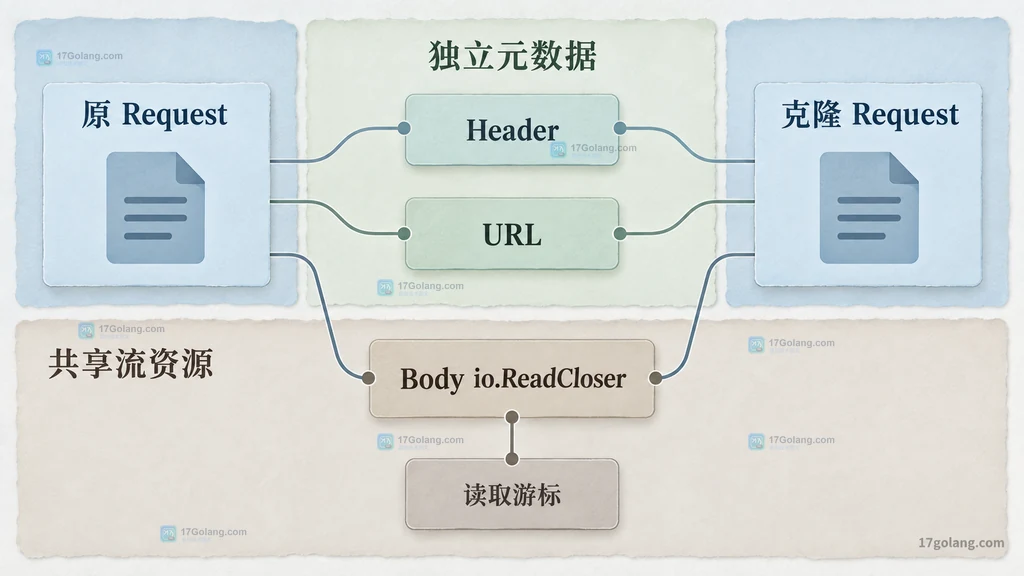
因此 Clone 的“深”针对请求的结构化元数据;Body 属于外部流资源,只做浅复制。两个 goroutine 同时读两个克隆请求的 Body,也不是两份独立数据,而是在竞争同一个读取器。
出站请求:优先使用 GetBody
对于客户端出站请求,最简洁的方案是检查 GetBody。http.NewRequest 在 body 为 *bytes.Buffer、*bytes.Reader 或 *strings.Reader 时会自动设置它;这个函数每次返回一个从头开始的新 io.ReadCloser。
func CloneOutgoing(req *http.Request, ctx context.Context) (*http.Request, error) {
	cloned := req.Clone(ctx)

	if req.Body == nil || req.Body == http.NoBody {
		// 无正文时普通 Clone 已经足够
		return cloned, nil
	}
	if req.GetBody == nil {
		return nil, fmt.Errorf("request body 不可重放,GetBody 为空")
	}

	body, err := req.GetBody()
	if err != nil {
		return nil, fmt.Errorf("重新创建 request body: %w", err)
	}
	// 用新的读取器替换 Clone 继承的共享 Body
	cloned.Body = body
	return cloned, nil
}
这里不用再次复制 Header 或 ContentLength,因为 Clone 已经处理了结构字段,ContentLength 也随 Request 值复制。真正需要替换的只有共享 Body。
GetBody 的主要用途之一是客户端需要重放请求正文,例如某些 307、308 重定向。它不是所有请求都自动具备的能力:如果 body 是自定义流、文件流或管道,调用方要么自己提供 GetBody,要么承认这个请求不可重放。
入站小请求:读取一次,再建立两个独立读取器
服务器收到的请求不会使用 GetBody。如果鉴权、审计或日志中间件需要查看正文,后续 handler 也要继续读,可以在入口处对大小受控的 Body 做一次缓存。
func CloneIncomingBody(r *http.Request, ctx context.Context, maxBytes int64) (*http.Request, error) {
	if maxBytes  maxBytes {
		return nil, fmt.Errorf("request body 超过 %d 字节", maxBytes)
	}

	// 原请求与克隆请求各自持有独立游标
	r.Body = io.NopCloser(bytes.NewReader(data))
	cloned := r.Clone(ctx)
	cloned.Body = io.NopCloser(bytes.NewReader(data))
	return cloned, nil
}
这段代码的关键不是 io.ReadAll,而是上限。没有上限地缓存外部请求体,可能把大上传直接搬进内存。超过限制后函数会返回错误,调用方应中止当前请求;不要继续假设原 Body 还能完整读取。
如果代码位于 HTTP handler,更适合结合 http.MaxBytesReader 和明确的 413 响应管理限制。上面的通用函数展示的是独立游标的核心做法:同一份不可变字节,各创建一个 bytes.Reader,而不是复制 io.ReadCloser 接口。
大文件和实时流:不要复制 Body
文件上传、流式代理、实时压缩和消息管道不适合先读入内存。此时“让两个模块各读一遍”本身就是错误目标,通常应改成下面之一:
- 只让一个组件拥有 Body,其他组件接收解析后的摘要、哈希、结构体或审计事件。
- 需要边读边观察时使用
io.TeeReader,但旁路写入仍会给主读取路径增加背压。 - 确实需要重复读取大文件时,显式落到受控临时文件,再为每个消费者打开独立文件句柄,并负责清理。
- 客户端重试时重新从业务来源生成流,而不是指望
Clone复制已经消费的网络读取器。
io.TeeReader 也不是“免费克隆”。它只在主消费者读取时同步把相同字节写向另一个 Writer,不能让两个消费者以不同速度独立拉取。旁路写入变慢时,主读取也会变慢。
按请求来源选择独立 Body 方案
| 场景 | 推荐方案 | 主要代价 | 不要做什么 |
|---|---|---|---|
| 只改 context 或元数据 | 直接 Request.Clone | Body 仍共享 | 不要让副本再次读取 Body |
| 出站且 GetBody 非空 | Clone 后调用 GetBody() | 为每个副本创建新读取器 | 不要忘记替换 cloned.Body |
| 入站小 JSON/表单 | 限长读取一次,建立两个 reader | 占用与正文大小相当的内存 | 不要无上限 ReadAll |
| 大文件或实时流 | 单消费者、摘要旁路或受控落盘 | 需要重新设计所有权 | 不要并发读共享 Body |
判断顺序可以很简单:先问是否真的需要第二次读取;需要时再问是否已有 GetBody;没有时判断 Body 是否足够小且允许缓存;两者都不满足,就不要克隆流。
关闭和并发边界也要一起处理
共享 Body 时,关闭任意一个请求的 Body 就是在关闭同一个底层读取器,因此不能对原请求和普通 Clone 分别 defer Close()。建立独立读取器后,每个 Body 才有各自的关闭责任。
对于出站请求,http.Client 和 Transport 会负责关闭发送的请求 Body;如果只是手动调用 GetBody 后自行读取,则调用方要关闭返回值。对于入站请求,Server 会管理最初的 Body,但当中间件主动替换 Body 后,仍应保持所有权简单,避免多个层重复关闭同一个对象。
并发方面,Request 文档只要求 Body 的 Read 可以与 Close 并发;它没有承诺两个 Read 可以安全并发,更没有承诺两个读取者各自得到完整内容。需要并行消费者时,必须先创建真正独立的数据源。
相关问题
Request.Clone 和 WithContext 有什么区别?
WithContext 对整个 Request 做浅复制并替换 context;Clone 还会复制 URL、Header、Trailer 等结构字段。但两者都不会为 Body 创建独立数据流。
为什么 NewRequest 已经设置 GetBody,Clone 还不自动使用?
因为 Clone 的职责是复制请求结构并更换 context,而不是决定调用方是否要重放正文。自动创建新 Body 会带来额外资源和关闭责任,因此需要调用方显式选择。
读完 Body 后重新赋值就安全吗?
只有在你保存了完整字节、限制了大小,并为每个消费者创建独立 reader 时才安全。把同一个 reader 再赋给两个请求,仍然共享游标。
可以让两个 goroutine 同时读原请求和 Clone 吗?
不可以把它当成两份数据。普通 Clone 共享同一个 Body,两个读取者会竞争字节;应先通过 GetBody、字节缓存或文件句柄建立独立来源。
总结:Request.Clone 不深复制 Body,是因为 Body 是不可通用复制的有状态流。只复制元数据时直接 Clone;出站可重放请求用 GetBody;入站小请求在明确上限内缓存并重建两个读取器;大流式请求则保持单消费者。先确定数据所有权,再决定是否复制,比在 EOF 出现后补一次 io.ReadAll 更可靠。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
253 收藏
-
352 收藏
-
145 收藏
-
436 收藏
-
354 收藏
-
210 收藏
-
146 收藏
-
145 收藏
-
384 收藏
-
414 收藏
-
135 收藏
-
124 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习