
PEFT 多个 adapter 怎么按权重组合推理
来源:17golang原创
时间:2026-10-06 18:49:33 454浏览 收藏
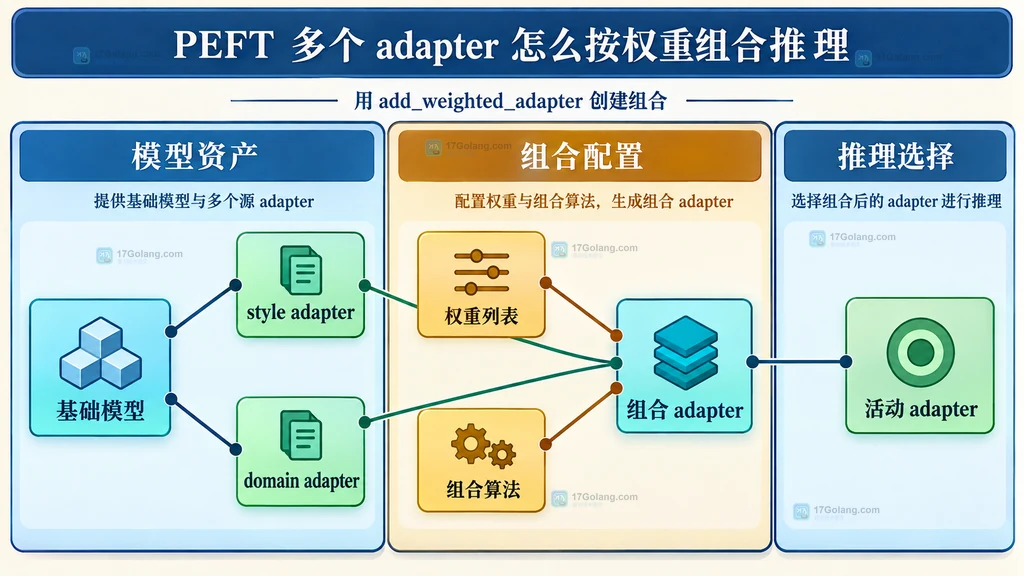
PEFT 要把多个 LoRA adapter 按权重组合用于推理,核心接口是 add_weighted_adapter():先把所有来源 adapter 以不同名称加载到同一个 PeftModel,再传入名称列表、权重列表、组合名称和 combination_type,最后用 set_adapter() 激活新组合。
权重不是“能力占比概率”,组合也不是简单同时启用多个 adapter。PEFT 会根据指定算法生成一个新的 adapter;来源 adapter 仍然保留,组合结果要单独命名、激活并评测。
官方文档:https://huggingface.co/docs/peft/developer_guides/model_merging
先保护好三个不变量
项目里常见的需求是:一个 adapter 学会领域术语,另一个 adapter 学会输出风格,希望推理时获得两种能力。动手前先核对三个不变量,否则调权重只会掩盖配置问题。
- 同一个基础模型。来源 adapter 应针对相同 base model 及兼容词表训练,不能只因为模型尺寸相同就混用。
- 兼容的 PEFT 类型和目标模块。本文以 LoRA 为主;目标模块集合和配置形态要能被 PEFT 共同注入。
- 明确 rank 与额外模块。
linear、ties、dare_ties等策略通常要求来源 adapter rank 相同;重复命中的modules_to_save也可能阻止组合。
如果某个 adapter 训练时新增了 special token,还要先统一 tokenizer 与 embedding 行。adapter 合并只处理适配器参数,不会自动替你解决不同词表的语义冲突。
把多个 adapter 加载到同一个模型
下面用两个占位路径展示最小结构。实际项目应把 BASE_MODEL_ID、ADAPTER_STYLE 和 ADAPTER_DOMAIN 替换成同一基础模型体系下的真实仓库或本地目录。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel

BASE_MODEL_ID = "your-org/base-model"
ADAPTER_STYLE = "your-org/style-lora"
ADAPTER_DOMAIN = "your-org/domain-lora"

# 先加载所有 adapter 共同依赖的基础模型和 tokenizer。
tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL_ID)
base_model = AutoModelForCausalLM.from_pretrained(
    BASE_MODEL_ID,
    torch_dtype=torch.float32,
    device_map="auto",
)

# 第一个 adapter 在创建 PeftModel 时命名为 style。
model = PeftModel.from_pretrained(
    base_model,
    ADAPTER_STYLE,
    adapter_name="style",
    is_trainable=False,
)

# 第二个 adapter 加载到同一模型,但不会自动变成活动 adapter。
model.load_adapter(
    ADAPTER_DOMAIN,
    adapter_name="domain",
    is_trainable=False,
)
adapter 名称是组合接口的引用键,必须唯一且稳定。不要依赖多个地方都叫 default,否则配置记录和评测日志很难追溯到底用了哪份权重。
用 add_weighted_adapter 创建组合
# 两个来源名称与两个权重必须一一对应。
source_adapters = ["style", "domain"]
source_weights = [0.4, 0.6]

# linear 简单直接,但要求来源 LoRA rank 兼容,且属于近似组合。
model.add_weighted_adapter(
    adapters=source_adapters,
    weights=source_weights,
    adapter_name="style-domain-linear-v1",
    combination_type="linear",
)

# 新组合创建后不会自动激活,推理前要显式切换。
model.set_adapter("style-domain-linear-v1")
model.eval()
add_weighted_adapter() 新增的是一个命名 adapter,不会修改 style 和 domain。这非常适合做 A/B 对照:同一个模型实例里可以依次激活单 adapter 和组合 adapter,避免反复加载基础模型。
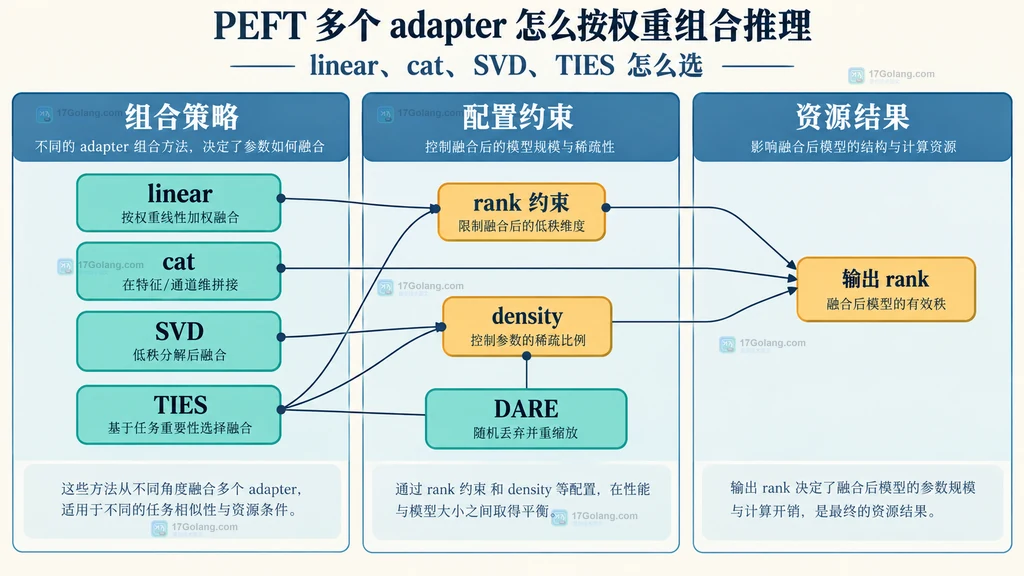
linear、cat、SVD、TIES 怎么选
| 组合类型 | 主要特点 | 关键约束或代价 |
|---|---|---|
linear | 计算开销低,适合快速做权重网格实验 | 来源 rank 要一致;官方实现说明它是较粗的近似 |
cat | 通过拼接保留各 adapter 分量,来源 rank 可不同 | 输出 rank 等于来源 rank 之和,显存和计算可能明显增加 |
svd | 先组合再通过 SVD 得到指定 rank | 需要选择 svd_rank;官方文档提示半精度和 bfloat16 不支持该组合路径 |
ties | 裁剪冗余、解决符号冲突,再合并一致方向 | 需要 density,来源 rank 要兼容 |
dare_ties | 先 Drop And REscale,再做 TIES | 同样需要 density,随机稀疏会改变组合特性 |
如果两个 adapter rank 不同,cat 是容易理解的选择,但输出 rank 会相加;想限制输出 rank,可以考虑 svd 并在 float32 条件下执行。若多个任务方向冲突明显,可从 ties 或 dare_ties 开始,并把 density 纳入实验记录。
# TIES 通过 density 指定保留参数的比例。
model.add_weighted_adapter(
    adapters=["style", "domain"],
    weights=[1.0, 1.0],
    adapter_name="style-domain-ties-v1",
    combination_type="ties",
    density=0.2,
)

# 显式激活新的 TIES 组合,再进入推理阶段。
model.set_adapter("style-domain-ties-v1")
PEFT 官方合并指南对 TIES/DARE 给出的起点是每个权重使用 1.0,并指出大于 1.0 有时更利于保持尺度。这说明 LoRA 的 weights 不必机械归一化为和等于 1;真正标准应是验证集表现和基础能力保持情况。IA³ 的线性组合是另一套接口语义,官方则建议其权重和为 1。
权重怎样调才有意义
把权重理解成“能力强度旋钮”比理解成概率更接近实际,但它仍不是线性可解释的产品参数。两个 adapter 在相同层上修改同一方向时可能叠加,在相反方向时可能抵消;不同组合算法又会改变这种相互作用。
我通常先做一个小网格,而不是直接猜出最终值:
| 组合 | style 权重 | domain 权重 | 用途 |
|---|---|---|---|
| 基线 | 0 | 0 | 确认基础模型原始能力 |
| 单项 A | 1.0 | 0 | 测风格收益和副作用 |
| 单项 B | 0 | 1.0 | 测领域准确性 |
| 均衡 | 0.5 | 0.5 | 观察简单折中 |
| 领域优先 | 0.3 | 0.7 | 保护专业任务指标 |
每组都使用同一批提示词、解码参数和随机种子,至少记录任务准确性、格式遵循率、拒答或幻觉率、输出长度和吞吐。只凭几条“看起来更好”的样例调权重,很容易把风格变化错当成能力提升。
激活组合并完成推理
prompt = "请用三条要点解释领域概念,并给出一个边界条件。"

# 使用和训练体系一致的模板,避免把模板差异误判为 adapter 差异。
inputs = tokenizer(prompt, return_tensors="pt")
inputs = {name: tensor.to(model.device) for name, tensor in inputs.items()}

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=160,
        do_sample=False,  # 固定解码方式,便于比较不同组合。
    )

text = tokenizer.decode(output_ids[0], skip_special_tokens=True)
print(text)
如果要切换回单 adapter,只需 model.set_adapter("style") 或 model.set_adapter("domain")。如果要看纯基础模型,可以使用 PEFT 提供的 adapter 禁用上下文。这样可以在同一套输入上完成四组对照,而无需把组合权重永久写入基础模型。
最常见的失败路径
报 adapter 不存在
检查 from_pretrained 和 load_adapter 传入的 adapter_name,并确保 add_weighted_adapter 中使用的是名称而不是仓库路径。
linear 或 ties 提示 rank 不一致
这类策略要求来源 rank 兼容。可以换成 cat,或选择 svd 并显式设置输出 rank;不要通过改配置文件伪装成相同 rank。
cat 后显存突然增加
cat 的输出 rank 是来源 rank 之和。adapter 越多,新增矩阵越大。组合前先估算目标层数量与总 rank,不要把它当作零成本叠加。
SVD 在半精度模型上失败
官方 LoRA 文档指出 SVD 组合不支持 torch.float16 或 torch.bfloat16。可以在 float32 模型上创建组合,再根据部署需求处理后续精度和保存流程。
组合后格式很好,但领域答案退化
这通常不是 API 错误,而是能力干扰。降低风格 adapter 权重、提高领域权重,或尝试 TIES/DARE,并回到固定验证集比较。没有对照指标时,不应仅凭主观样例继续叠加 adapter。
发布前检查清单
- 所有 adapter 是否来自兼容的基础模型、tokenizer 和目标模块?
- 来源名称、权重、组合名称、combination_type、density 和 svd_rank 是否进入实验记录?
- 组合名称是否唯一,是否在推理前显式调用 set_adapter?
- 是否比较基础模型、每个单 adapter 与组合 adapter?
- 是否同时检查目标任务收益、基础能力回退、显存和延迟?
- 是否保留来源 adapter,避免在结果未评测前永久写入基础模型?
结论
PEFT 多 adapter 加权推理的稳定做法是:在同一 PeftModel 中给来源 adapter 命名加载,用 add_weighted_adapter() 创建独立组合,再通过 set_adapter() 激活。linear 适合快速实验,cat 能容纳不同 rank 但会增大输出 rank,SVD 用于压缩,TIES 和 DARE 更适合处理参数冲突。权重只是实验变量,最终选择必须由固定验证集和资源指标决定。
技术依据:https://huggingface.co/docs/peft/developer_guides/model_merging、https://huggingface.co/docs/peft/package_reference/lora、https://huggingface.co/docs/peft/package_reference/peft_model。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
358 收藏
-
328 收藏
-
科技周边 · 人工智能 | 7小时前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size470 收藏
-
308 收藏
-
309 收藏
-
175 收藏
-
359 收藏
-
499 收藏
-
164 收藏
-
291 收藏
-
372 收藏
-
314 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习