
模糊测试只跑到少量路径,怎样改善种子语料质量
来源:17golang原创
时间:2026-10-07 11:03:12 313浏览 收藏
Go 模糊测试只跑到少量路径,通常不是简单地把 -fuzztime 调大就能解决。先看 baseline coverage 和 new interesting 的变化:如果初始种子只覆盖正常输入,变异器就缺少进入深层分支的起点;如果目标函数提前丢弃输入或依赖全局状态,运行再久也可能只在浅层打转。
官方资料:https://go.dev/doc/security/fuzz/
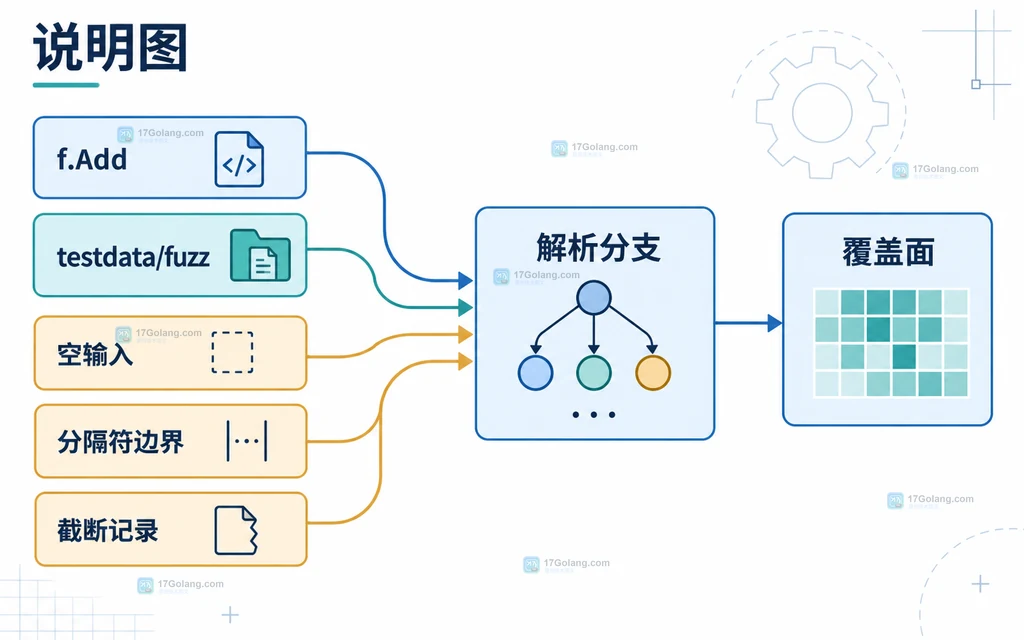
- 种子要覆盖输入边界和结构分区,不是随意堆几个字符串。
f.Add与testdata/fuzz/FuzzXxx的参数类型和顺序必须匹配 fuzz target。- 用短时对照观察
new interesting,再决定补种子还是延长运行。
先判断是种子覆盖少,还是模糊运行时间太短
启动 fuzz 后,Go 会先执行已有种子并收集 baseline coverage,然后才进入变异阶段。输出里的 gathering baseline coverage 反映初始语料的执行情况;后续 new interesting 表示找到能扩大覆盖面的输入。它不是“发现了多少条业务路径”的直接计数,但很适合做趋势信号。
| 现象 | 优先检查 | 判断 |
|---|---|---|
| baseline 很快结束,new interesting 长时间为 0 | 种子是否只有正常值、目标是否过早 return | 先补输入分区 |
| new interesting 初期增加,随后很快停住 | 深层分支是否需要特殊格式或更长预算 | 补结构样本后再对照 |
| 普通 go test 已经失败 | 失败种子和回归用例 | 先修复或隔离已知失败 |
按输入边界补齐 f.Add 种子
种子设计应围绕被测函数的输入语义,而不是只按长度随机取样。以解析请求头为例,可以准备空字符串、只有键、带重复分隔符、合法键值、截断转义和非 UTF-8 字节等分区。每个样本都要对应一个可能改变分支判断的特征。
func FuzzParseHeader(f *testing.F) {
	// 每个种子代表一种会改变解析分支的输入边界。
	f.Add("content-type: text/plain")
	f.Add("") // 空输入用于覆盖缺失字段分支
	f.Add("x--value") // 连续分隔符用于覆盖格式异常分支
	f.Add("name: value\\ntruncated") // 截断内容用于覆盖不完整记录分支

	f.Fuzz(func(t *testing.T, input string) {
		// 断言关注解析结果的安全边界,不要求所有输入都解析成功。
		_, err := parseHeader(input)
		if err != nil && strings.Contains(err.Error(), "panic") {
			t.Fatalf("解析错误不应暴露 panic: %v", err)
		}
	})
}
f.Add 的类型和顺序必须与 f.Fuzz 的参数完全一致。若目标函数接收 []byte, int,种子就不能用 string, int 替代;类型不匹配会让种子阶段直接失败,而不是“少覆盖一点”。
用 testdata/fuzz 保存真实结构样本
当输入是较大的 JSON、协议帧或二进制文件时,把内容全部写进 f.Add 会降低可读性。可以把 Go 识别的 corpus 文件放在 testdata/fuzz/FuzzParseHeader 下,让它和代码中的小型边界样本一起作为 seed corpus。
# 先创建与 fuzz 函数同名的 corpus 目录,避免样本落错位置。
mkdir -p testdata/fuzz/FuzzParseHeader

# 运行普通测试,确认所有 seed 都能被执行并且失败可复现。
go test -run=FuzzParseHeader ./...
每个 corpus 文件使用 go test fuzz v1 开头,后续值的编码和类型仍须匹配 fuzz 参数。真实样本适合保留嵌套结构、边界长度和协议组合,但不要把与当前目标无关的巨大文件一股脑加入;语料越大,baseline 阶段越慢,定位新增覆盖来源也越困难。
让 fuzz target 保持确定且可达
Go fuzz target 会被多个 worker 以不确定顺序调用。不要依赖上一次输入留下的全局变量,也不要在进入核心解析前用过宽的过滤条件把大多数变异值丢掉。可以做必要的长度上限和资源保护,但过滤规则必须服务于被测协议,而不是把输入空间压缩成一个固定样本。
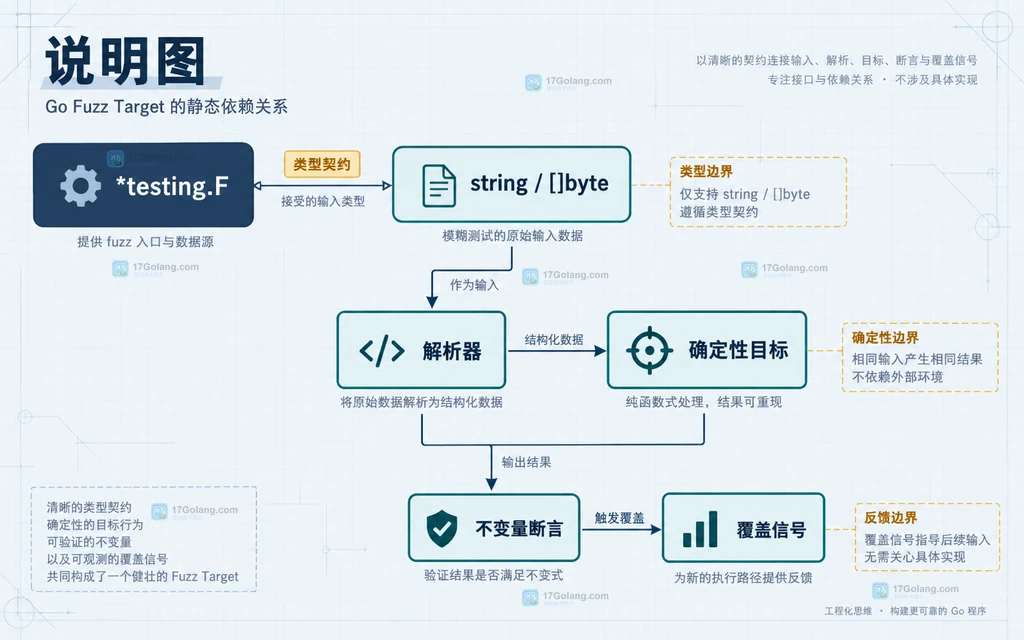
一个实用检查是:同一输入重复执行,解析结果和错误分类应保持一致;如果测试需要时间、随机数或外部服务,把这些因素替换为稳定的本地依赖。断言也要针对不变量,例如“不能 panic”“成功结果满足范围”“错误类型可分类”,而不是只断言某个样本必须返回固定字符串。
用分阶段命令观察 new interesting 的变化
先让普通测试跑完所有 seed,再做短时 fuzz 对照。下面的命令把目标函数限定为单个 fuzz test,并用固定时长避免一次运行占满机器。
# 先跑 seed corpus,尽早发现已有样本的回归失败。
go test -run=FuzzParseHeader ./...

# 用固定预算观察新增有趣输入的增长,不把时长当成覆盖率保证。
go test -fuzz=FuzzParseHeader -fuzztime=30s ./...
如果前几秒 new interesting 增长明显,随后趋于平稳,下一步优先补能打开新格式分支的种子;如果一直为零,先排查目标函数是否在输入归一化、长度限制或错误处理处提前结束。覆盖引导目前依赖支持覆盖插桩的平台,官方文档特别提醒 AMD64 和 ARM64 才能获得有意义的覆盖引导。
不要把 $GOCACHE/fuzz 中的生成语料误当成项目的 seed corpus。需要长期回归的失败输入应回收到项目的 testdata/fuzz/FuzzParseHeader,并和修复后的普通测试一起保留。
相关问题
种子越多,覆盖率一定越高吗?
不一定。重复触发同一分支只会增加 baseline 成本,优先选择能改变解析状态、长度边界或错误分类的样本。
为什么 fuzztime 加长后 new interesting 仍然不变?
常见原因是输入被过早过滤、目标函数不确定,或深层分支需要结构化样本。先用短时日志定位停滞位置,再补种子。
失败输入要不要直接删掉?
不要。失败输入是回归语料,先确认修复后能稳定重现,再决定是否把它归入长期的 testdata corpus。
-
400 收藏
-
341 收藏
-
183 收藏
-
195 收藏
-
366 收藏
-
205 收藏
-
351 收藏
-
235 收藏
-
325 收藏
-
227 收藏
-
Golang · Go问答 | 4小时前 | golang · Context · 并发编程 · 超时控制 WithTimeout WithCancel Go context 取消传播 WithoutCancel202 收藏
-
Golang · Go问答 | 4小时前 | goroutine · Context · 并发编程 · 故障排查 · Go问答 · channel WaitGroup Go context ctx.Done 阻塞排查 context.Canceled144 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习