
生成器管道处理大文件:背压、关闭与异常传播
来源:17golang原创
时间:2026-10-07 12:14:50 126浏览 收藏
我第一次把几十 GB 的 NDJSON 导入改成生成器管道时,内存曲线确实平了,但新的问题很快冒出来:消费端只取前一百条就停止后,文件句柄还留着;某一行 JSON 损坏时,日志只剩一个解码错误;后来有人为了“提速”加了 list(),管道又把数据全部装进内存。
这三个现象分别对应背压、关闭和异常传播。同步生成器不会自动解决所有资源问题,但它能提供一个很清楚的基础契约:下游每调用一次 next(),上游才继续到下一个 yield;提前结束时显式关闭顶层生成器;每个持有上游的中间层在 finally 中把关闭继续传下去。
Python 3.14 官方文档:https://docs.python.org/3.14/
- 纯同步生成器链是按需拉取,不等于异步队列,也不需要额外“背压开关”。
- 任何
list()、sorted()、全量读取或无界预取都会破坏常量级在途数据。 - 文件应在源生成器内部用
with open(...)持有;消费端提前停止时要确定性调用顶层close()。 - 解析异常应在原处补充行号并用
raise ... from exc保留原因链,不能静默跳过。
先看现象:内存稳定不代表管道已经正确
生成器最容易让人产生的错觉是:既然没有把文件一次读完,方案就已经安全。实际排查时,我会先把症状分成三层。
| 现象 | 优先证据 | 常见根因 |
|---|---|---|
| 数据量一大,内存仍持续上涨 | 搜索 list、sorted、read、队列和批量缓存 | 某个阶段把惰性迭代器物化,或引入无界预取 |
| 消费端提前 break 后文件仍占用 | 确认谁创建生成器、谁负责 close | 只等待垃圾回收,没有确定性关闭顶层管道 |
| 坏数据只有 JSONDecodeError | 检查异常是否带路径、行号和原因链 | 中间层重新抛错时丢掉上下文,或直接吞错 |
这三层不要混在一起处理。限制批量大小不能补上关闭契约,添加 try/except 也不会恢复被 list() 破坏的惰性。先找证据,再改对应边界,通常比给整条管道套一个大而宽的异常捕获更可靠。
第一层检查:背压是不是被某个阶段破坏了
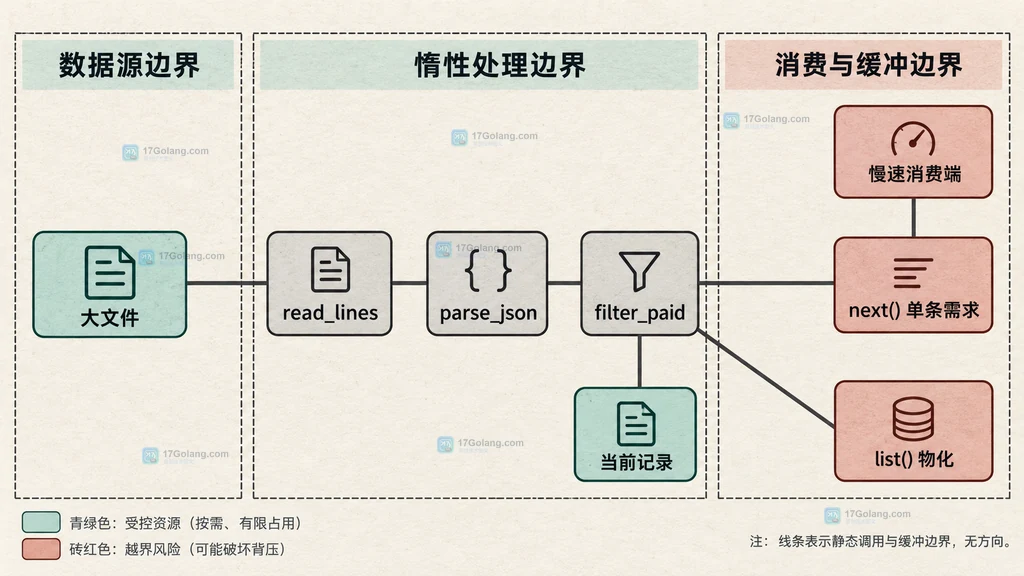
在同步生成器链中,消费端掌握推进节奏。for 循环内部会调用迭代器的 __next__();当前生成器继续执行,直到产出下一个值或结束。中间层也是同样的拉取关系,所以慢速消费端自然会让上游停在某个 yield 上。
这是一种“按需拉取”的背压,不是带容量统计的消息队列背压。它能保证没有显式预取时,管道通常只保留当前记录以及各层少量局部状态;它不能约束你主动创建的列表、排序缓存、批量聚合或后台线程队列。
def filter_paid(rows):
    # 每次只检查当前记录,不建立全量结果列表。
    for line_number, record in rows:
        if record.get("status") == "paid":
            yield line_number, record


def first_batch(rows, limit):
    # 消费端每推进一次,管道才向上游再索取一条。
    for index, item in enumerate(rows):
        if index == limit:
            break
        yield item
排查时重点找这些边界:list(rows) 会把剩余记录全部读完;sorted(rows) 必须先收集才能排序;"".join(rows) 会聚合全部文本;生产者线程向无界队列持续写入,则已经脱离同步拉取模型。需要排序或分组时,应明确采用有界批次、外部排序或磁盘临时结构,而不是继续称它为“纯流式”。
第二层检查:提前停止能不能关闭整条管道
文件生命周期最好由产生文件记录的源生成器拥有。把 open() 放在生成器外部,会让调用方同时管理文件和迭代器,责任容易分裂;把它放进生成器内部,第一次迭代时才会打开文件,正常耗尽、异常退出或收到关闭信号时都能离开 with。
from collections.abc import Iterator
from pathlib import Path


def read_lines(path: Path) -> Iterator[tuple[int, str]]:
    # 文件由源生成器拥有,编码也在资源边界内固定。
    with path.open("r", encoding="utf-8") as source:
        for line_number, line in enumerate(source, start=1):
            yield line_number, line
正常把生成器迭代完时,函数离开 with,文件自然关闭。麻烦出在下游提前 break:for 循环退出本身不会替你调用任意迭代器的 close()。依赖对象何时被回收,在不同实现、作用域和引用关系下都不够直观,因此我更愿意把关闭写进消费边界。
contextlib.closing() 会在离开 with 时调用对象的 close(),即使块内发生异常也一样。生成器的 close() 会在暂停的 yield 位置抛入 GeneratorExit;生成器应结束或继续抛出该异常,不能在响应关闭时再次 yield,否则会得到 RuntimeError。
第三层检查:关闭有没有穿过每个中间层
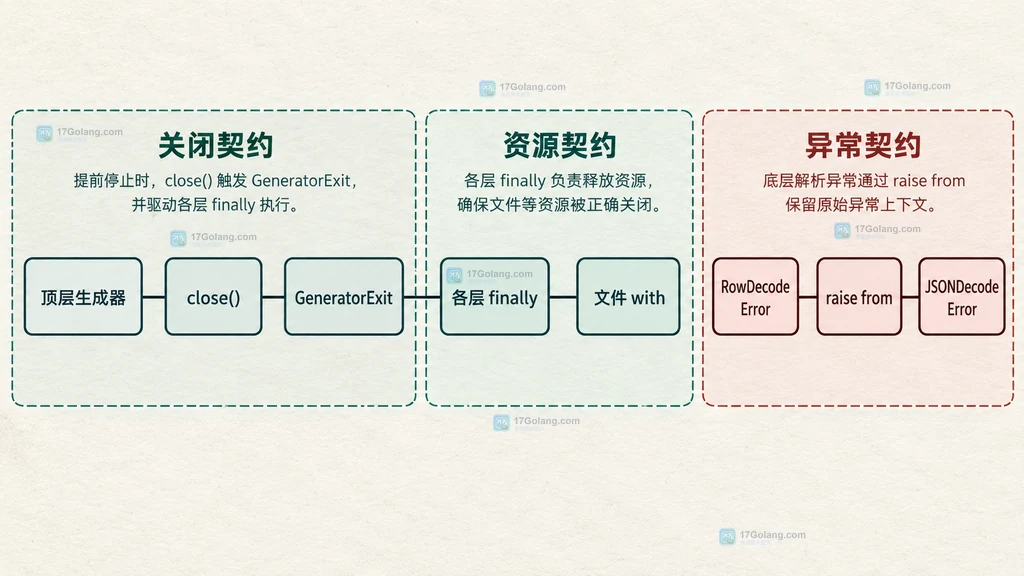
仅关闭最外层还不够。普通 for item in upstream 不会自动承诺在当前生成器关闭时也关闭 upstream。每个中间层既然保存了上游引用,就应在 finally 里传递关闭。下面的小工具把这条规则集中起来:
from collections.abc import Iterator
from typing import Any


def close_if_possible(iterator: object) -> None:
    # 只对声明了 close 的上游传递关闭,不猜测其他清理协议。
    close = getattr(iterator, "close", None)
    if close is not None:
        close()


def filter_paid(
    rows: Iterator[tuple[int, dict[str, Any]]],
) -> Iterator[tuple[int, dict[str, Any]]]:
    try:
        for line_number, record in rows:
            if record.get("status") == "paid":
                yield line_number, record
    finally:
        # 顶层关闭时,把资源释放责任继续交给上游。
        close_if_possible(rows)
这段写法最重要的不是辅助函数,而是所有层都遵守同一所有权规则:创建或持有上游的层负责关闭它。若团队选择 yield from 做委托,Python 会把 send()、throw() 和可用的关闭能力传给子迭代器;但带过滤、转换和错误包装的业务层通常仍需要显式循环,所以 finally 更容易让评审者看清资源边界。
第四层检查:解析异常有没有保留行号和原始原因
大文件最难处理的不是第一行就失败,而是几百万行后遇到一条坏记录。直接把 JSONDecodeError 抛给调用方,往往只有列号和字符位置,没有业务文件的行号;捕获后重新抛一个普通字符串错误,又会丢掉原始异常。比较实用的方式是定义领域异常并保留原因链。
import json
from collections.abc import Iterator
from typing import Any


class RowDecodeError(ValueError):
    # 领域异常固定携带文件行号,便于定位原始记录。
    def __init__(self, line_number: int, message: str) -> None:
        super().__init__(f"第 {line_number} 行 JSON 无法解析:{message}")
        self.line_number = line_number


def parse_json(
    rows: Iterator[tuple[int, str]],
) -> Iterator[tuple[int, dict[str, Any]]]:
    try:
        for line_number, line in rows:
            try:
                yield line_number, json.loads(line)
            except json.JSONDecodeError as exc:
                # 补充业务行号,同时保留 JSONDecodeError 原因链。
                raise RowDecodeError(line_number, exc.msg) from exc
    finally:
        # 无论正常结束、解析失败还是收到 close,都关闭源生成器。
        close_if_possible(rows)
不要默认“遇到坏行就继续”。静默跳过会让输入条数、输出条数和业务账目失去对应。如果业务允许容错,应把坏记录写入有界的隔离输出,记录文件标识、行号和失败原因,并为跳过数量设置明确上限;这是一项业务策略,不是生成器应该暗中决定的行为。
把消费端写成确定性关闭边界
完整组合时,消费端只需要持有最外层生成器。退出 with closing(...) 后,顶层 close() 触发其 finally,再逐层关闭到 read_lines,最终离开文件的 with。
from contextlib import closing
from pathlib import Path


def load_paid_orders(path: Path, limit: int) -> None:
    # 管道从源到顶层保持惰性,不在中间创建全量容器。
    pipeline = filter_paid(parse_json(read_lines(path)))

    # closing 保证提前 break 或消费异常时都会关闭顶层生成器。
    with closing(pipeline) as paid_orders:
        for index, (line_number, order) in enumerate(paid_orders):
            save_order(order, source_line=line_number)
            if index + 1 >= limit:
                break
这里的 save_order() 越慢,上游被拉取的频率就越低,这正是同步背压的效果。它也意味着整条链占用同一个调用线程:如果读取、解析和写入需要并行吞吐,就应明确改成有界队列或异步管道,并重新定义容量、取消和错误汇聚,而不是偷偷在线程里无限预取。
反向验证:从消费端检查三份证据
这类管道不需要依赖“文件很大所以应该没问题”的直觉。评审或测试时可以从三个契约反向确认:
- 慢消费证据:中间层没有
list()、全量排序或无界队列;消费端不调用next()时,上游不会自行推进。 - 提前关闭证据:消费端用
closing()或等价的try/finally;每个中间生成器都在finally中关闭上游;源生成器用with拥有文件。 - 坏数据证据:异常包含行号,
__cause__保留原始JSONDecodeError;策略不允许时不会静默跳过。
还要留意一个边界:如果生成器从未开始迭代,它的函数体尚未执行,文件也尚未打开;关闭这样一个尚未启动的生成器不会产生资源泄漏。真正需要保证的是,一旦源生成器已经进入文件 with 并暂停在 yield,提前结束就必须让关闭信号抵达它。
上线前清单
- 源生成器是否在内部打开文件,并显式指定编码?
- 每个转换层是否只保留当前记录或明确大小的批次?
- 是否出现
list()、sorted()、全量read()或无界队列? - 消费端提前
break时,谁负责调用顶层close()? - 每个持有上游的中间层是否在
finally中传递关闭? - 是否错误捕获了
BaseException,从而连GeneratorExit也一起吞掉? - 解析异常是否带文件行号,并用
raise from保留原因? - 若确实需要并行预取,队列容量、取消策略和失败处理是否另有明确设计?
常见问题
生成器管道一定是常量内存吗?
不一定。纯逐项转换通常只有少量在途状态,但任何阶段都可以主动累计数据。分组、排序、去重集合、批量缓存和队列都会改变内存上界,必须单独计算。
只在源生成器里写 with open 还不够吗?
正常耗尽或异常穿过源生成器时通常够用;消费端提前停止却继续持有管道引用时,源生成器可能仍暂停在 yield。确定性做法是关闭顶层,并让各中间层把关闭传到源头。
为什么不直接捕获 Exception 后继续下一行?
因为解析失败可能意味着文件截断、编码错误或上游格式变更。默认继续会掩盖数据缺口。只有业务明确允许隔离坏记录时,才应记录行号、原因和数量上限后继续。
同步生成器背压能代替异步队列吗?
不能。同步生成器靠调用栈按需拉取,没有独立生产者,也没有队列容量和并发吞吐。需要跨线程或异步并发时,应采用有界缓冲并重新设计取消与异常汇聚。
对我来说,生成器真正有价值的地方不是“把 list 改成 yield”,而是把需求、资源和失败三种边界暴露出来:消费端决定何时拉取,持有者决定如何关闭,出错点决定补充什么上下文。只要这三份责任都写进代码,大文件管道才能在提前停止、坏数据和慢下游面前保持可解释。
-
225 收藏
-
389 收藏
-
250 收藏
-
137 收藏
-
190 收藏
-
427 收藏
-
132 收藏
-
文章 · python教程 | 7小时前 | 并发 · 异常处理 · python · asyncio · CancelledError 结构化并发 ExceptionGroup Python asyncio TaskGroup asyncio gather246 收藏
-
337 收藏
-
359 收藏
-
325 收藏
-
176 收藏
-
130 收藏
-
437 收藏
-
487 收藏
-
104 收藏
-
307 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习