
Web Worker 配合 SharedArrayBuffer 共享高频数据
来源:17golang原创
时间:2026-10-10 14:21:05 301浏览 收藏
我曾经把 Worker 每次计算出的几百个采样点都用 postMessage() 发回主线程。计算确实离开了 UI 线程,但消息创建、结构化克隆和垃圾回收又形成了新的抖动。换成 SharedArrayBuffer 后,主线程与 Worker 可以读取同一块底层数据,不再为每批样本重新复制缓冲区。
不过,共享内存并不是“更快的 postMessage”。它更像一块由两个线程共同维护的数据平面:你要先配置跨源隔离,再定义内存布局、同步协议和过载策略。对低频消息,我仍然优先使用普通 postMessage();只有连续采样、音视频分析、实时图表或 WebAssembly 线程这类高频数值负载,才值得承担共享内存的复杂度。
官方参考:https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/SharedArrayBuffer
先判断负载是否真的需要共享内存
Worker 与主线程交换数据有三种常见模型。它们没有绝对优劣,关键是所有权和更新频率。
| 方案 | 数据语义 | 适合负载 | 主要代价 |
|---|---|---|---|
| 结构化克隆 | 接收端得到副本 | 低频配置、结果对象、控制消息 | 大对象频繁复制和分配 |
| 转移 ArrayBuffer | 底层资源移交,发送端缓冲区失效 | 一批数据只交给一方继续处理 | 不能由双方同时访问 |
| SharedArrayBuffer | 对象各自独立,底层数据块共享 | 高频数值流、持续生产消费 | 跨源隔离、并发协议和背压 |
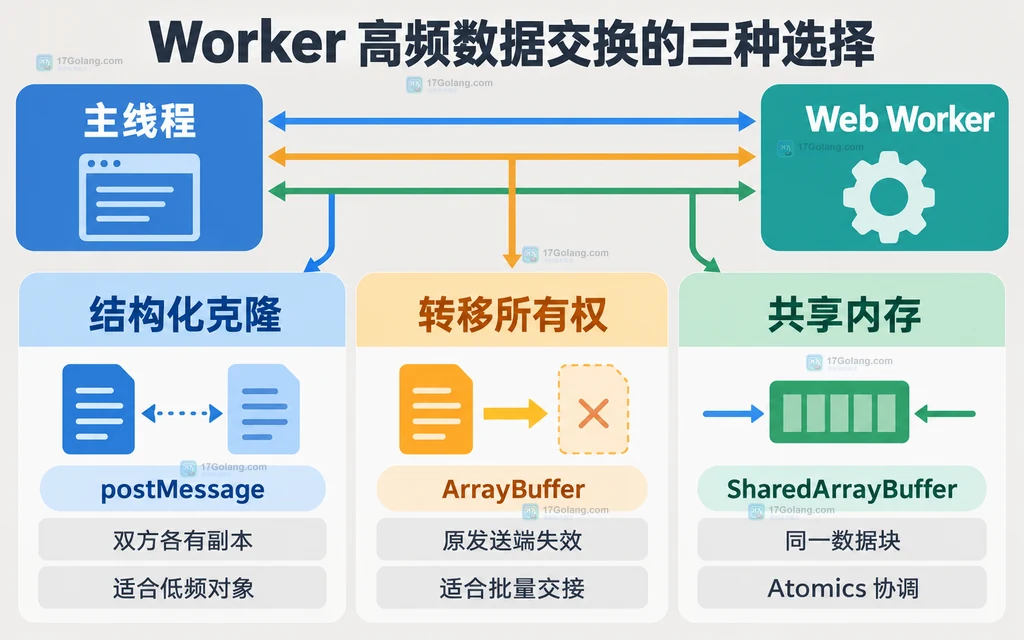
一个容易误解的点是:SharedArrayBuffer 不是 transferable。通过 postMessage() 发送后,Worker 会得到新的 SharedArrayBuffer 对象,但它引用的底层共享数据块和主线程相同。任何一方写入后,另一方最终都能看到变化;要建立可靠的先后关系,必须用 Atomics。
跨源隔离是第一条部署约束
浏览器把 SharedArrayBuffer 视为需要额外安全边界的能力。页面通常要同时返回 COOP 和 COEP 响应头,使 crossOriginIsolated 为 true。常见配置如下:
# 将顶层页面放入同源浏览上下文组
add_header Cross-Origin-Opener-Policy "same-origin" always;

# 只允许明确授权的跨源资源进入页面
add_header Cross-Origin-Embedder-Policy "require-corp" always;
require-corp 会影响跨域脚本、图片、字体、iframe 和 Worker 脚本。第三方资源需要正确的 CORS 或 Cross-Origin-Resource-Policy 响应头,否则可能被浏览器阻止。依赖 OAuth、支付弹窗或广告脚本的页面,更应该先评估隔离对 window.opener 和跨域资源的影响。
初始化时不要只判断构造函数是否存在,而要检查隔离状态并准备降级:
// 只有隔离成功时才启用共享内存通道
const canShare = self.crossOriginIsolated &&
  typeof SharedArrayBuffer === "function";

if (!canShare) {
  // 降级为普通消息批处理,避免页面直接崩溃
  console.info("共享内存不可用,改用 postMessage 批处理");
}
共享布局比 API 本身更重要
我更愿意从最简单的单生产者、单消费者模型开始:Worker 只写,主线程只读。共享区分成两部分:
- 控制区使用
Int32Array,保存writeIndex、readIndex和丢弃计数。 - 数据区使用
Float64Array,保存循环复用的数值样本。 - 索引通过
Atomics.load/store/add访问,样本槽位只由其当前所有者读写。 - 缓冲区满时不覆盖未读数据,而是增加 dropped 计数。
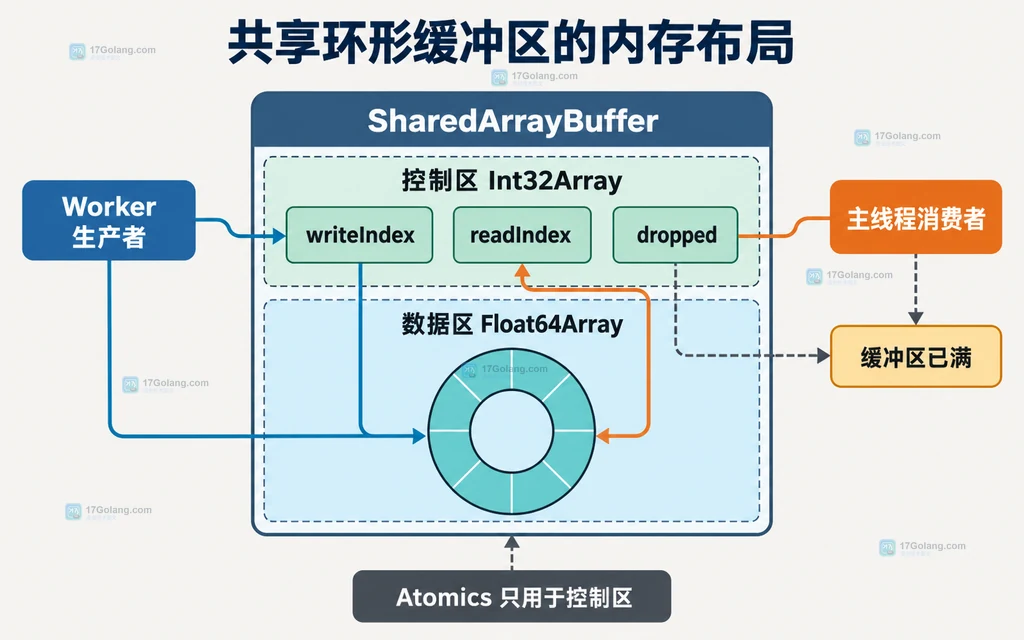
下面把控制区固定为 16 字节,使 Float64 数据区从 16 字节偏移开始,保持 8 字节对齐:
// main.js:创建共享区并把同一数据块交给 Worker
const CAPACITY = 1024;
const CONTROL_BYTES = 16;
const sab = new SharedArrayBuffer(
  CONTROL_BYTES + CAPACITY * Float64Array.BYTES_PER_ELEMENT,
);

const control = new Int32Array(sab, 0, 4);
const samples = new Float64Array(sab, CONTROL_BYTES, CAPACITY);
const worker = new Worker(new URL("./producer.js", import.meta.url), {
  type: "module",
});

// SharedArrayBuffer 不放入 transfer 列表,双方继续共享底层数据块
worker.postMessage({ sab, capacity: CAPACITY, controlBytes: CONTROL_BYTES });

function consumeFrame() {
  let read = Atomics.load(control, 1);
  const write = Atomics.load(control, 0);

  // 只消费已由 Worker 发布的槽位,避免读到半写入样本
  while (read !== write) {
    drawSample(samples[read]);
    read = (read + 1) % CAPACITY;
  }

  // 发布新的读位置,让生产者知道哪些槽位可以复用
  Atomics.store(control, 1, read);
  requestAnimationFrame(consumeFrame);
}

requestAnimationFrame(consumeFrame);
Worker 写入时明确过载策略
Worker 写样本时先计算下一个写位置。如果它追上 readIndex,说明环形缓冲区已满。实时图表通常更关心主线程保持响应,因此我选择丢弃新样本并记数;遥测归档则可能要改成扩大批次、落盘或让生产者等待。
// producer.js:Worker 是唯一生产者,避免多个写方争抢同一槽位
self.onmessage = ({ data }) => {
  const { sab, capacity, controlBytes } = data;
  const control = new Int32Array(sab, 0, 4);
  const samples = new Float64Array(sab, controlBytes, capacity);

  setInterval(() => {
    const write = Atomics.load(control, 0);
    const read = Atomics.load(control, 1);
    const next = (write + 1) % capacity;

    if (next === read) {
      // 缓冲区满时记录丢弃数,不覆盖主线程尚未读取的数据
      Atomics.add(control, 2, 1);
      return;
    }

    // 先写数据,再用原子 store 发布新索引
    samples[write] = collectSample();
    Atomics.store(control, 0, next);
  }, 2);
};
这个例子故意没有在主线程使用 Atomics.wait()。多数浏览器不允许在主线程阻塞等待,而且即使允许,阻塞 UI 也违背使用 Worker 的初衷。主线程按动画帧消费即可;如果消费者也在 Worker 中,可以再评估 Atomics.wait()、notify() 或 waitAsync()。
风险和代价不能省略
- 数据竞争:不要让两个线程无协议地写同一槽位。先保持单生产者、单消费者。
- 索引发布顺序:样本写完后再原子更新 writeIndex;消费者读完后再更新 readIndex。
- 背压:明确满缓冲区时是丢新数据、丢旧数据、扩容还是暂停生产,不能默默覆盖。
- 部署兼容:COEP 可能阻断缺少 CORS/CORP 授权的第三方资源,COOP 也会改变弹窗关系。
- 可观测性:记录 dropped、最大积压和每帧消费量,证明共享内存解决了真实瓶颈。
- 生命周期:页面离开时终止 Worker,停止定时器,避免后台继续生产。
上线前的选择清单
我会在满足以下条件时选择 SharedArrayBuffer:数据以数值型 TypedArray 为主;生产频率高到复制和分配已经成为可测瓶颈;页面能稳定部署 COOP/COEP;团队愿意维护并发协议和降级路径。
如果数据只是每秒几次的对象消息,普通 postMessage() 更清楚;如果是一批大数据交给 Worker 后主线程不再使用,转移 ArrayBuffer 更简单;只有双方需要长期同时访问同一块高频数据时,共享内存才真正匹配问题。
相关问题
SharedArrayBuffer 发送后原对象会失效吗?
不会。它不是 transferable。发送与接收端拥有不同的 SharedArrayBuffer 对象,但引用同一底层共享数据块。
为什么本地开发能运行,部署后 SharedArrayBuffer 却不可用?
通常是生产响应缺少 COOP/COEP,或 Permissions-Policy、跨域子资源和 Worker 脚本破坏了跨源隔离。以 self.crossOriginIsolated 的结果作为能力判断。
普通数组读写也能看到变化,为什么还要 Atomics?
普通共享内存访问没有可靠的跨线程顺序保证。Atomics 用于发布索引和状态,使双方对哪些数据已经写完、哪些槽位可以复用达成一致。
对我来说,SharedArrayBuffer 的最大价值不是省掉一次复制,而是把高频数据通道变成固定容量、固定布局、可测量背压的结构。也正因为如此,它应该在性能数据证明必要之后采用,而不是作为 Worker 通信的默认答案。
-
310 收藏
-
286 收藏
-
418 收藏
-
239 收藏
-
文章 · 前端 | 22小时前 | javascript · AbortController AbortSignal.any AbortError TimeoutError AbortSignal reason447 收藏
-
110 收藏
-
120 收藏
-
202 收藏
-
257 收藏
-
315 收藏
-
356 收藏
-
158 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习