
如果只是想找“文本分类”“文本生成”或“图像到文本”这类特定任务的模型,不必先把整个模型列表拉回本地再筛选。huggingface_hub 提供的 HfApi.list_models() 可以直接接收 pipeline_tag,再配合排序和数量上限返回一个可控的候选集合。
官方地址:https://huggingface.co/docs/huggingface_hub/package_reference/hf_api
最小可用组合是:用pipeline_tag限定任务,用sort和direction决定候选顺序,用limit控制返回数量,最后从每个ModelInfo中保留模型身份和必要元数据。
先理解 pipeline_tag 筛选的边界
pipeline_tag 是模型在 Hugging Face Hub 上的任务标签。它回答的是“这个模型适合哪类 pipeline 任务”,例如 text-classification 或 summarization。它不是推理质量排名,也不代表某个提供商一定支持该模型。
因此,筛选阶段只负责缩小模型候选范围。下载权重、验证许可证、判断推理后端和比较实际效果,应放在后续阶段。把这几个边界分开,查询结果才不会被误读成最终选型结论。
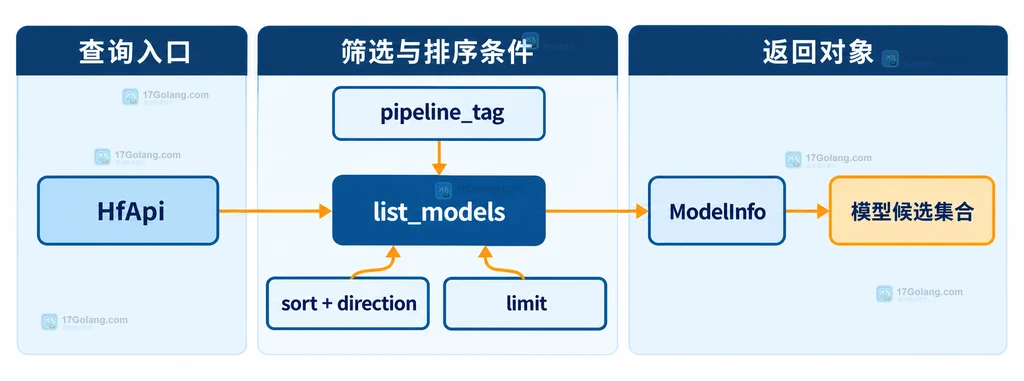
用 HfApi.list_models 组合查询条件
先安装客户端并建立 HfApi 对象。公开模型列表通常可以直接读取;如果工作区需要访问受限仓库,再按 Hugging Face 的认证方式提供令牌,不要把令牌硬编码进文章示例或提交到代码仓库。
from huggingface_hub import HfApi

# 只把查询条件传给 Hub,避免先拉取无边界的模型全集。
api = HfApi()

# 按任务标签筛选,并按下载量降序保留有限候选。
models = api.list_models(
    pipeline_tag="text-classification",
    sort="downloads",
    direction=-1,
    limit=20,
    expand=["pipeline_tag", "library_name", "downloads", "lastModified"],
)

for model in models:
    # modelId 是后续记录和再次查询时最稳定的身份字段。
    print(model.modelId, model.pipeline_tag, model.downloads)
这里的 direction=-1 表示按降序查看排序结果,limit=20 把候选规模锁在 20 个以内。实际使用时,排序字段要和筛选目标匹配:想找使用更广的模型可以看 downloads,想追踪近期更新则可以看 lastModified。
从 ModelInfo 中提取真正有用的字段
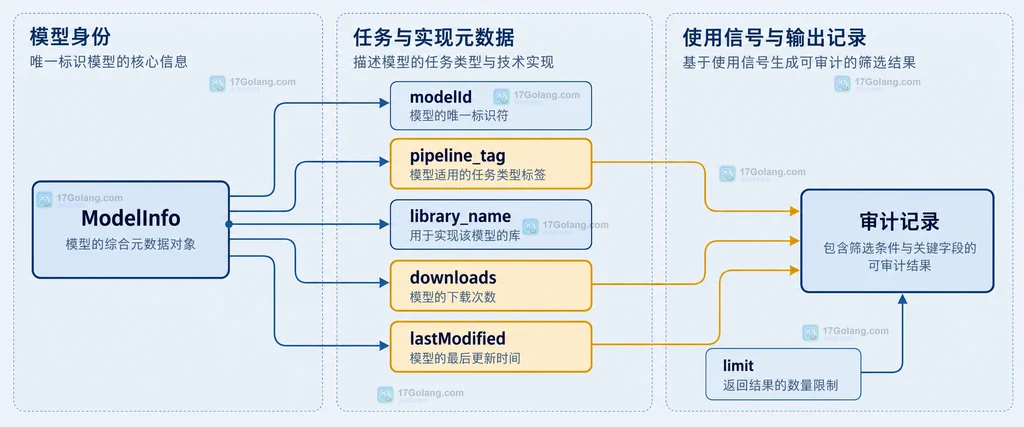
返回项是模型信息对象,不要把它直接当成推理结果。对模型发现任务来说,通常保留五类信息就够了:modelId 识别仓库,pipeline_tag 说明任务,library_name 提示常用库,downloads 反映公开使用信号,lastModified 帮助判断记录是否需要更新。
字段可能为空,尤其是标签和库名并不应被视为绝对的兼容性证明。写入自己的候选表时,建议把空值原样保存为 null,不要用默认文字掩盖缺失信息。
def model_record(model):
    # 统一输出为普通字典,方便写入 JSON 或数据库。
    return {
        "model_id": model.modelId,
        "pipeline_tag": getattr(model, "pipeline_tag", None),
        "library_name": getattr(model, "library_name", None),
        "downloads": getattr(model, "downloads", None),
        "last_modified": getattr(model, "lastModified", None),
    }

# 先限制输入规模,再生成可审计的候选清单。
records = [model_record(model) for model in models]
for record in records:
    print(record["model_id"], record["pipeline_tag"])
用 limit 和 expand 控制查询规模
模型目录会持续变化,查询脚本不应默认把所有结果读进内存。limit 是最直接的规模控制;如果还要保留字段,就用 expand 明确需要的属性,避免为了几个字段请求一整套模型信息。
当候选太多时,可以分成几次不同排序的查询,例如一次按下载量取前 20 个,另一次按更新时间取前 20 个,再按 modelId 去重。这样比单次拉取大列表更容易记录来源,也方便在后续评估中解释候选为什么进入清单。
| 参数或字段 | 作用 | 使用边界 |
|---|---|---|
pipeline_tag | 按任务类型缩小模型范围 | 不是效果、许可证或推理后端保证 |
sort / direction | 控制候选展示顺序 | 排序指标不等于最终质量 |
limit | 限制返回条数 | 应根据后续评估预算设置 |
expand | 指定需要展开的元数据 | 只保留后续决策确实会用到的字段 |
把筛选结果变成可追踪记录
如果脚本只是打印模型名,下一次运行很难解释候选为何变化。建议至少记录查询条件、抓取时间和每个模型的关键字段。这样即使下载量或更新时间发生变化,也能区分“查询条件变了”和“模型元数据变了”。
from datetime import datetime, timezone

# 查询条件和观察时间与模型字段一起保存,便于后续复盘。
query_log = {
    "pipeline_tag": "text-classification",
    "sort": "downloads",
    "direction": -1,
    "limit": 20,
    "observed_at": datetime.now(timezone.utc).isoformat(),
    "models": records,
}

# 这里可以继续交给 json.dump 写入文件;不要把访问令牌写入日志。
print(query_log["observed_at"], len(query_log["models"]))
记录本身也要保持最小化:模型身份、任务标签、关键元数据和查询条件足够支撑下一步评估。不要把访问令牌、私有路径或与选型无关的用户信息写进候选文件。
常见问题
pipeline_tag 能直接证明模型一定能调用吗?
不能。它主要是任务分类标签,调用前还要确认模型访问权限、客户端任务支持、模型所需输入格式和实际后端能力。
为什么 limit 不能替代排序?
limit 只限制返回数量,不决定哪些模型排在前面。想要稳定的候选顺序,需要同时指定合适的 sort 和 direction。
字段为空时要不要过滤掉模型?
不要一概过滤。先保留 modelId,把缺失标签记录下来,再在需要强约束的后续环节决定是否淘汰。空值本身也是元数据质量信号。
小结
HfApi 的核心用法是把筛选边界前移:用 pipeline_tag 表达任务,用 sort 和 direction 组织顺序,用 limit 控制规模,再将 ModelInfo 的关键字段和查询条件一并记录。这样得到的是可解释、可复查的模型候选集合,而不是未经验证的推理质量结论。




