
AI Prompt 前缀缓存 怎样处理
来源:17golang原创
时间:2026-10-22 07:09:52 429浏览 收藏
AI Prompt 前缀缓存要处理好,核心不是把完整请求保存起来,而是让重复的 token 前缀保持稳定,把用户问题、当前检索结果和一次性参数放到后缀。推理服务可以复用前缀对应的 KV cache,减少重复的 prefill 计算;如果模型、路由、提示词版本或租户边界变了,就应该主动视为另一个缓存域。
Hugging Face 缓存资料地址:https://huggingface.co/docs/huggingface_hub/guides/manage-cache
vLLM 前缀缓存资料地址:https://docs.vllm.ai/en/latest/design/prefix_caching/
先记住一个判断:前缀缓存命中依赖“前面的一段输入在 token 和缓存条件上可复现”,不是依赖两次请求的文字看起来相似。Hugging Face Hub 的文件缓存解决的是模型或数据文件避免重复下载;本文讨论的是推理阶段的 KV 前缀复用。
- 适合放前面:版本化系统规则、公共文档、稳定工具描述。
- 适合放后面:用户问题、临时检索片段、当前时间和一次性参数。
- 必须单独记录:模型、提供商、LoRA、多模态输入、租户隔离和提示词版本。
先区分两种 Prompt 缓存
Hugging Face Hub 的缓存主要面向文件下载:模型、数据集或 Space 的文件会按仓库和 revision 组织,重复请求可以复用本地文件。它并不会自动让一次推理请求复用另一条请求已经算好的注意力状态。
推理阶段的前缀缓存则保存已处理输入对应的 KV cache。vLLM 的 Automatic Prefix Caching(APC)会寻找与新请求相同的前缀,让新请求跳过共享部分的 prefill。它更像“重复计算结果的复用”,不是“把完整回答缓存后直接返回”。因此同一个问题只要前缀变化,仍可能需要重新计算。
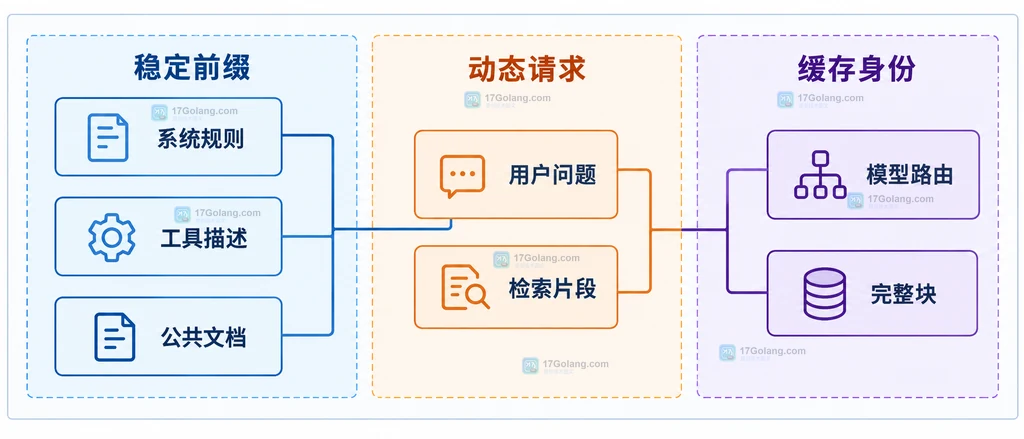
把稳定内容排在动态内容之前
最容易见效的调整是固定消息排列:先放系统规则、工具 schema 和公共文档,再拼接用户问题与本次检索结果。不要在稳定前缀中插入当前时间、随机请求 ID、每次变化的 trace 字段或未排序的对象序列化结果。空格、换行、字段顺序和文档版本只要改变了 token,就可能让共享前缀缩短。
可以把请求想成两个区域:
| 区域 | 适合放入的内容 | 变化策略 |
|---|---|---|
| 稳定前缀 | 系统指令、工具描述、公共规则、固定文档 | 版本化、规范化、变更时换缓存域 |
| 动态后缀 | 用户问题、检索片段、当前时间、临时参数 | 每次请求生成,不污染公共前缀 |
注意,前缀缓存通常按块保存。vLLM 官方设计说明明确写着只缓存完整块,所以稳定前缀即使只差几个 token,也可能少复用一整块;不要把“字符长度接近”当成命中条件。
为什么看起来一样却没有命中
先查输入本身,再查推理环境。第一层是 token 化后的内容:标点、换行、工具顺序、公共文档版本是否一致。第二层是缓存身份:vLLM 的块标识除了父块和块内 token,还可以包含 LoRA ID、多模态输入哈希等附加信息。相同文字配上不同图片,不能默认复用同一段多模态状态。
第三层是模型和路由:模型、提供商、端点或部署实例改变后,缓存空间可能不同。第四层是生命周期:容量回收、服务重启、提示词版本升级或 TTL 到期都会造成回源。APC 的收益也有边界,它只减少 prefill,不会减少生成新 token 的 decode 时间;如果响应本身很长,整体耗时不一定明显下降。
对于自托管 vLLM,可以按部署版本使用前缀缓存配置。下面的示例只表达配置意图,不代表在本文任务中实际运行:
from vllm import LLM

# 开启推理阶段的前缀 KV 缓存,让重复前缀有机会复用 prefill 结果。
llm = LLM(
    model="your-model-id",
    enable_prefix_caching=True,
)

# 真实命中仍取决于 token 前缀、完整块边界和模型运行条件。
print({"prefix_cache": "enabled", "model": "your-model-id"})
把版本和租户隔离写进缓存契约
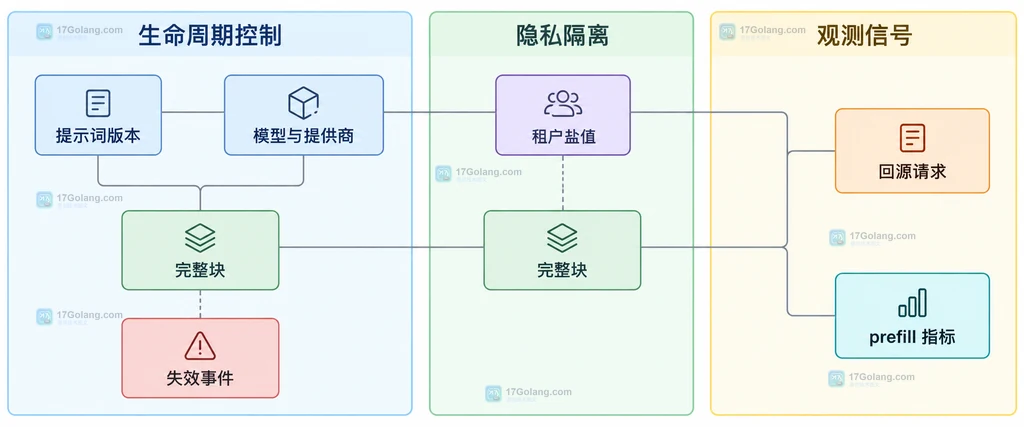
公共规则升级时,直接更换提示词版本比等待旧缓存自然淘汰更容易解释。建议把提示词版本、模型与提供商、稳定前缀摘要和租户范围当成一个契约;用户问题和私有检索正文不要进入跨租户共享的公共键。
vLLM 官方设计文档还提供了 cache_salt 思路:把盐值加入首个块的身份,使只有使用相同盐值的请求才能复用缓存。它适合把缓存共享限制在明确的信任组内,但不能替代权限检查,也不能把租户名称本身当作安全证明。
上线前只记录最小的可观察信号
日志不必保存完整提示词。可以记录前缀版本、规范化后的 token 数、模型与 provider 标识、租户范围的不可逆摘要、复用 token 数、prefill 耗时、状态和失效原因。状态至少区分 hit、miss、bypass 和 stale;如果服务商没有明确的命中字段,就标记为未知,不要仅凭一次延迟下降宣布命中。
最小验证可以用两组请求对照:第一组保持系统规则、工具描述、模型和路由不变,只改变用户问题;第二组故意改变提示词版本或租户盐值。观察前缀复用信号与 prefill 时间是否按预期变化即可。这个对照只能帮助定位缓存边界,不应被写成某个服务商对所有模型都保证固定命中率。
| 现象 | 优先检查 | 处理动作 |
|---|---|---|
| 每次都是 miss | 动态字段是否混入前缀,路由是否漂移 | 固定消息顺序并记录模型、provider 和版本 |
| 偶尔 miss | 完整块边界、容量回收、重启和 TTL | 延长稳定前缀,接受容量不足时回源 |
| 跨租户复用担忧 | 缓存盐值和共享域是否按权限划分 | 扩大隔离键,必要时停止公共复用 |
| 整体延迟没下降 | 耗时是否主要在 decode 或后端排队 | 分别观察 prefill、decode 和排队时间 |
相关问题
把整个历史对话都放进前缀缓存是不是更好?
不一定。历史对话变化频繁,越靠前的内容越容易让共享前缀变短。更稳的组织方式是把版本化规则和公共上下文固定在前面,把当前会话放在后面。
前缀缓存命中后会直接返回旧答案吗?
不会。它复用的是输入处理阶段的 KV 状态,后续仍会根据当前问题和采样设置生成新内容;它不是完整响应缓存。
只改 TTL 能解决命中率低吗?
不能优先这么做。先排查 token 顺序、动态字段、完整块边界、模型路由和租户隔离,确认前缀稳定后再结合容量和隐私要求调整生命周期。
参考资料:https://huggingface.co/docs/huggingface_hub/guides/manage-cache、https://docs.vllm.ai/en/latest/design/prefix_caching/、https://docs.vllm.ai/en/v0.30.0/features/automatic_prefix_caching/。
-
467 收藏
-
485 收藏
-
214 收藏
-
470 收藏
-
223 收藏
-
科技周边 · 人工智能 | 1小时前 | python · 人工智能 · 结构化输出 · AI Hugging Face 结构化输出 JSON Schema TGI Inference Providers grammar response_format339 收藏
-
219 收藏
-
476 收藏
-
349 收藏
-
科技周边 · 人工智能 | 1小时前 | python · 数据处理 · 人工智能 · AI Hugging Face Datasets select_columns remove_columns DatasetDict 数据集字段373 收藏
-
科技周边 · 人工智能 | 1小时前 | python · 人工智能 · AI 文本分类 pipeline padding Transformers 批量推理 truncation batch_size379 收藏
-
180 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习