
OpenAI API prompt caching 怎样判断缓存命中边界
来源:17golang原创
时间:2026-10-23 05:36:32 150浏览 收藏
我排查 prompt caching 时,最容易误判的一点是:两次请求“意思差不多”,并不等于缓存命中。OpenAI API 复用的是请求开头的精确前缀,真正要看的证据在响应的 usage.input_tokens_details,而不是体感延迟。把稳定的开发者指令、工具定义放在前面,再把变化的用户内容放到后面,才能得到可解释的结果。
官方地址:https://developers.openai.com/api/docs/guides/prompt-caching
cached_tokens大于 0,说明本次输入有前缀被复用;cache_write_tokens表示有新前缀被写入。- 模型、工具、输入顺序、输出设置等变化都可能让原本共享的前缀失效。
- GPT-5.6 及更新模型可用显式 breakpoint 把稳定上下文截在动态内容之前。
一、先把“缓存边界”理解成可复用前缀
缓存不是全文相似度搜索。服务会从请求开头寻找可用的最长匹配前缀;前缀中的 token、模型和相关请求设置需要保持兼容。只改了最后一句用户问题,通常仍有机会复用前面的上下文;但如果在开头插入时间戳、随机请求号,后面的内容即使完全不变,也可能整体变成新前缀。
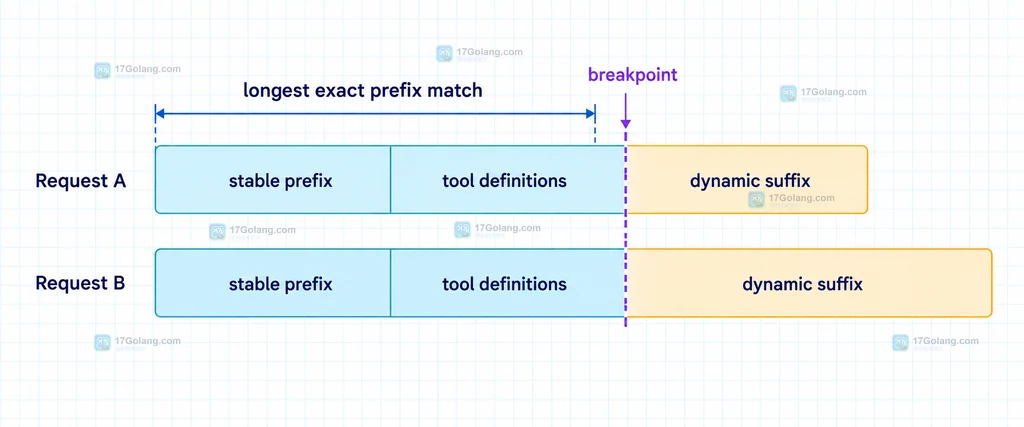
实际组织请求时,可以按“稳定块在前、变化块在后”处理。Responses API 使用显式模式时,把 prompt_cache_breakpoint 放在稳定的 input_text 内容块末尾;动态用户问题留在 breakpoint 之后。这样做的价值是:即使后缀每次都变,也不会把它当成想长期写入缓存的共享上下文。
二、用 usage 和诊断信息确认到底命中了什么
不要只看首 token 速度。请求完成后先记录 usage,再和上一条相同工作流的响应比较。下面是一个最小的读取示例:
# 读取 Responses API 的缓存计数,区分命中与新写入
usage = response.usage
details = usage.input_tokens_details

cached = details.cached_tokens or 0
written = details.cache_write_tokens or 0

if cached > 0:
    print(f"命中缓存前缀:{cached} tokens")  # 只表示有前缀复用,不代表整条请求都命中
elif written > 0:
    print(f"本次写入缓存:{written} tokens")  # 首次请求或新边界可能走写入
else:
    print("没有可报告的缓存复用或写入")  # 还要结合模型、长度和请求设置继续排查
一次请求同时出现命中和写入并不矛盾:前面较长的一段可能被复用,后面新增的部分又被写入。判断时要看计数覆盖了哪一段,而不是把“有 cached_tokens”简单等同于“100%命中”。
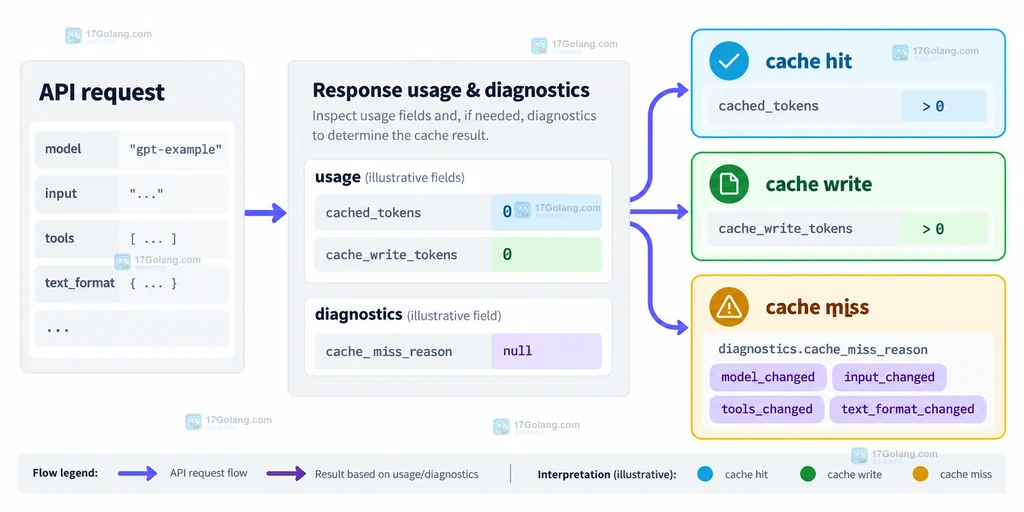
三、缓存未命中时按这张清单定位
| 观察到的现象 | 先检查什么 | 处理方向 |
|---|---|---|
| cached_tokens 为 0 | 模型、输入顺序、前缀长度 | 移除前缀中的动态值,确认达到该模型的最小可缓存长度 |
| 命中量比预期短 | breakpoint 是否落在稳定块末尾 | 把动态消息移到 breakpoint 之后,并保留原有消息结构 |
| 相邻请求突然 miss | tools、text.format、verbosity、reasoning 等设置 | 逐项对比请求配置,不要先重试同一份输入 |
| 原因仍不清楚 | Responses API 的 diagnostics | 对比最近一次响应,查看 model_changed 或 input_changed 等原因 |
诊断接口提供的是排查线索,不会替你修改请求。尤其要注意:重写历史消息、压缩上下文、改变工具顺序,都会改变可匹配的前缀。多轮应用尽量追加新消息,不要在每轮把旧消息重新拼接成略有差异的文本。
四、把命中判断纳入上线前检查
我会用两条相邻请求做小样本验证:第一条记录 cache_write_tokens,第二条只替换动态问题,再看 cached_tokens 是否覆盖预期的稳定前缀。若要长期复用,还要记录模型、TTL、工具版本和输入 token 数;缓存命中仍受生命周期和服务端可用性影响,不能当作永久存储。
最终结论可以收敛成一句话:先确认“前缀是否逐 token 稳定”,再用 cached_tokens 量化复用范围,最后用 diagnostics 解释差异。这样既能判断缓存命中边界,也能避免为了追求命中率把动态内容错误地塞进共享缓存。
相关问题
只有 cached_tokens,没有 cache_write_tokens,说明什么?
通常表示本次请求复用了已有缓存,且没有新的可报告写入;仍需结合输入长度和模型支持情况解释。
prompt_cache_key 能保证命中吗?
不能。它用于缓存路由或分组管理,命中仍要求请求拥有兼容且精确匹配的前缀。
改变用户问题会清空整段缓存吗?
不一定。只要变化发生在稳定前缀之后,前面的匹配部分仍可能命中;如果变化发生在前缀内部,命中边界会提前结束。
-
491 收藏
-
114 收藏
-
319 收藏
-
456 收藏
-
395 收藏
-
260 收藏
-
321 收藏
-
263 收藏
-
378 收藏
-
290 收藏
-
科技周边 · 人工智能 | 1小时前 | JSON · API · python · 人工智能 · 结构化输出 · 结构化输出 JSON Schema Gemini API response_schema response_mime_type additionalProperties145 收藏
-
467 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习