
Batch API 怎样提交离线任务
来源:17golang原创
时间:2026-10-25 12:04:26 126浏览 收藏
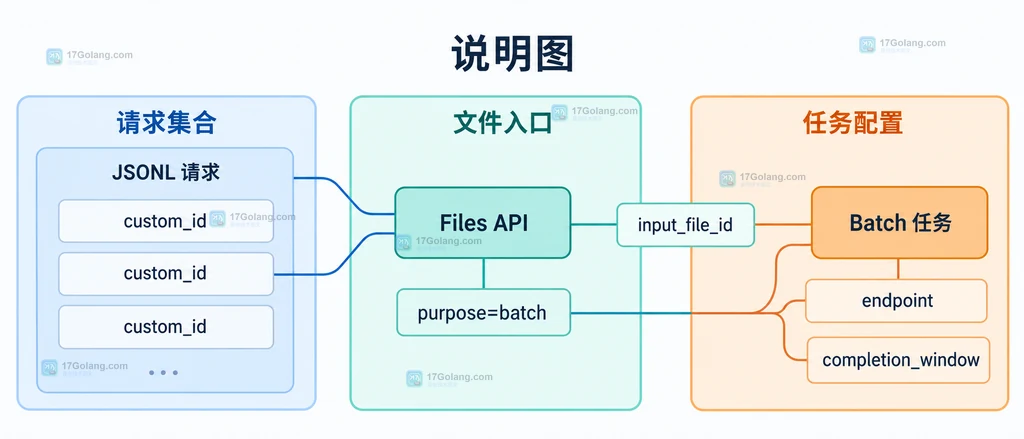
我第一次把一批不需要即时返回的文本任务从同步接口改成 Batch API 时,真正容易出错的不是“异步”两个字,而是把请求集合、输入文件和 Batch 任务混成了一个对象。正确做法是:先按 JSONL 每行一个请求准备输入文件,再用 Files API 上传,最后用返回的文件 ID 创建 Batch。
官方地址:https://platform.openai.com/docs/guides/batch
Batch API 适合评测、批量分类、批量生成嵌入等不要求立即返回的任务。它的入口顺序固定为“JSONL → purpose=batch 文件 → Batch → output_file_id”,不要把它当成一次普通的同步请求。
先看清这次能力变化
Batch API 把一组请求放进一个 JSONL 文件,任务提交后在后台处理。官方文档当前列出的 endpoint 包括 Responses、Chat Completions、Embeddings、Completions、Moderations,以及图像生成和编辑接口;同一个输入文件中的请求应面向同一个模型。它提供独立的批处理限额,完成窗口当前使用 24h,适合能容忍延迟的工作。
这和同步调用的关键差别是返回时机,而不是请求体被“批量改写”。每行的 body 仍然使用对应 endpoint 的参数,custom_id 则负责把最终结果认回原始任务。
准备 JSONL:一行就是一个请求
先写一个 batchinput.jsonl。下面只放两个 Chat Completions 请求,字段保持严格 JSON,不在其中加入注释;custom_id 要在这份文件里唯一,后续处理输出时就用它做关联键。
{"custom_id":"summary-001","method":"POST","url":"/v1/chat/completions","body":{"model":"gpt-6-sol","messages":[{"role":"user","content":"把这段会议纪要整理成三条要点"}],"max_tokens":300}}
{"custom_id":"summary-002","method":"POST","url":"/v1/chat/completions","body":{"model":"gpt-6-sol","messages":[{"role":"user","content":"把这段产品反馈归纳成问题清单"}],"max_tokens":300}}
每行包含四个核心部分:唯一标识 custom_id、请求方法 method、目标 url 和透传给目标接口的 body。如果你的任务换成 Embeddings,就让每行的 url 和 body 都切换到 Embeddings 的形态,不要在同一个输入文件里混用不同模型。
上传文件,再创建离线任务
上传阶段的目的不是立即执行请求,而是取得可供 Batch 引用的文件对象。Python SDK 的最小骨架如下;示例中的文件关闭交给 with,异常则交给调用方处理,避免把一个失败的上传误判成任务已创建。
from openai import OpenAI

client = OpenAI()

with open("batchinput.jsonl", "rb") as batch_file:
    # purpose=batch 表示该文件会作为 Batch API 的输入。
    input_file = client.files.create(file=batch_file, purpose="batch")

# 只把上传返回的文件 ID 交给 Batch,不把本地路径当作 input_file_id。
batch = client.batches.create(
    input_file_id=input_file.id,
    endpoint="/v1/chat/completions",
    completion_window="24h",
)

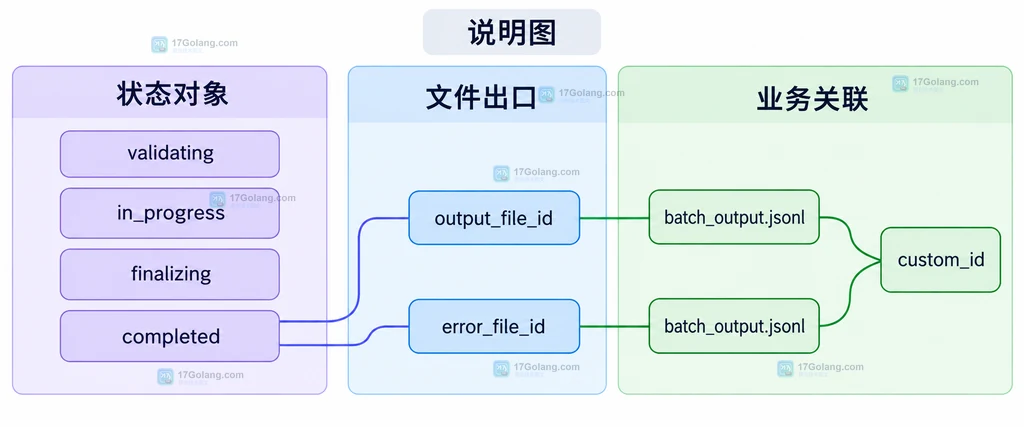
print(batch.id)这里最容易写错的是三个值:input_file_id 必须使用上传结果里的 ID;endpoint 必须和 JSONL 每行的 url 对应;completion_window 当前按官方接口使用 24h。创建成功后,状态通常会从 validating 开始。
状态完成后,按文件 ID 取结果
提交后不要用创建接口的返回值猜测最终答案,而是根据任务状态处理。validating 表示输入还在校验,in_progress 表示正在执行,finalizing 表示结果整理中,completed 才表示结果文件可取。若状态为 failed、expired 或 cancelled,先读取任务对象中的错误信息或错误文件,再决定如何修复输入。
from openai import OpenAI

client = OpenAI()
batch = client.batches.retrieve("batch_abc123")

if batch.status == "completed":
    # output_file_id 指向结果文件,不能拿 input_file_id 代替。
    result_file = client.files.content(batch.output_file_id)
    with open("batch_output.jsonl", "wb") as output:
        # 结果文件按行保存,后续用 custom_id 关联业务记录。
        output.write(result_file.read())
else:
    print(f"当前状态:{batch.status}")
结果行不保证按输入文件的原顺序返回,所以业务层应读取每行的 custom_id,再写回自己的任务表。这样即使输入顺序和完成顺序不同,也不会把一个客户的结果写到另一个任务上。
我的最小迁移清单
- 能延迟返回的任务才放入 Batch;需要用户马上看到结果的请求继续使用同步接口。
- 每个
custom_id都绑定一条业务记录,输出处理不要依赖行号。 - 创建前确认 JSONL 的
url、body.model与 Batch 的endpoint一致。 - 把
failed、expired和单行错误分开记录,不要只保存一个“批次失败”字符串。
相关问题
Batch API 能不能混用多个模型? 同一个输入文件按官方说明只面向一个模型;需要不同模型时拆成不同输入文件和 Batch。
为什么创建后还没有 output_file_id? 任务仍处于校验、执行或整理阶段,等状态变为 completed 再取结果。
离线任务过期怎么办? 读取错误文件定位未完成的 custom_id,缩小任务或修正输入后重新提交新的批次。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
439 收藏
-
241 收藏
-
208 收藏
-
420 收藏
-
418 收藏
-
313 收藏
-
101 收藏
-
418 收藏
-
185 收藏
-
307 收藏
-
250 收藏
-
397 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习