
Moderation 怎样组合多类别判断
来源:17golang原创
时间:2026-10-25 12:07:00 101浏览 收藏
Moderation 返回的重点不只是 flagged。如果业务要同时关心仇恨、骚扰、自残或暴力等多个类别,比较稳妥的做法是把 categories、category_scores 和 category_applied_input_types 分开处理,再把它们汇总成自己的业务动作。这样既能知道“命中了什么”,也能为不同类别保留不同阈值。
官方文档:https://developers.openai.com/api/docs/guides/moderation
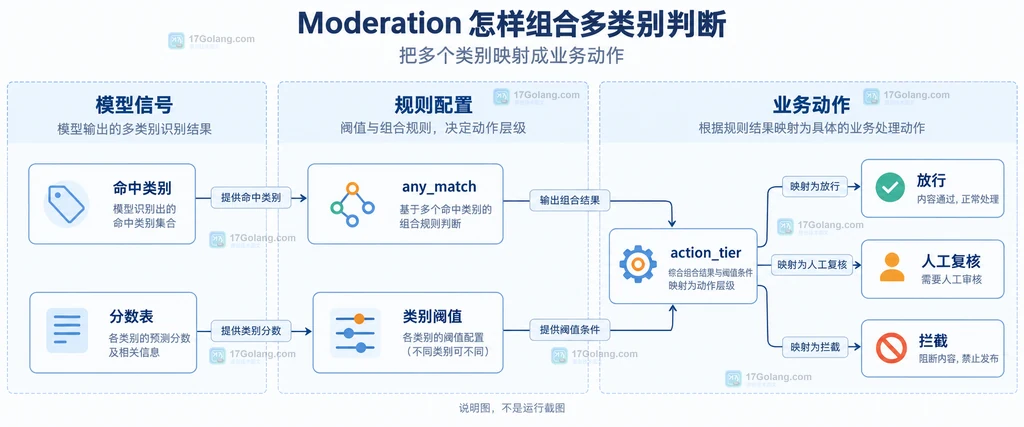
组合多类别判断的核心是:先收集类别信号,再按类别应用规则,最后统一映射为放行、人工复核或拦截。不要把所有场景都压缩成一个固定分数。
- 用
categories判断模型是否标记了某个类别。 - 用
category_scores做类别级别的置信度分层。 - 用
category_applied_input_types确认分数适用于文本、图片还是两者。
先分清三个结果字段
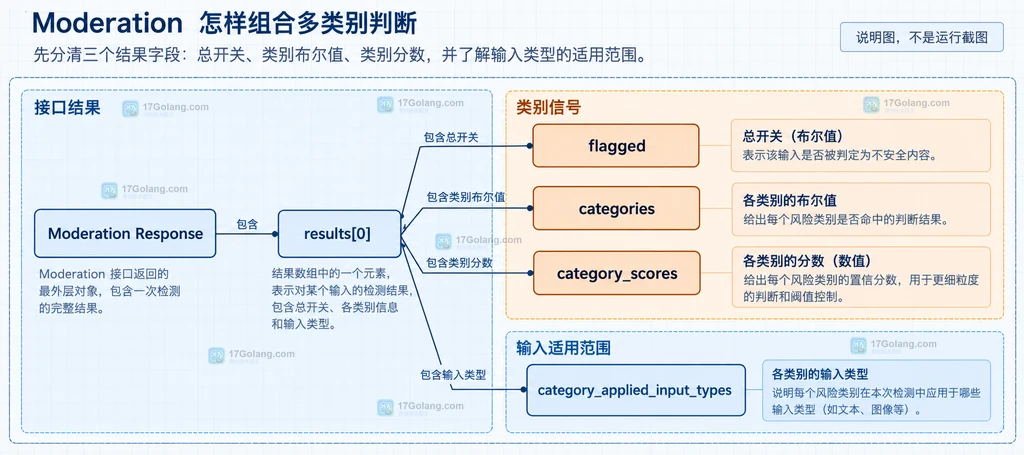
一次 Moderation 结果通常位于 response.results[0]。flagged 是整体提示,categories 是逐类别的布尔值,category_scores 是逐类别分数。三者用途不同:整体提示适合做快速分支,类别布尔值适合记录命中原因,分数适合做更细的策略分层。
另外要注意,分类项并不一定对每种输入都适用。官方返回的 category_applied_input_types 会说明某个类别的分数对应哪些输入类型。处理图片和文字混合请求时,不能只看分数高低,还要把这个适用范围带进日志或规则判断。
把多个类别收集成稳定标签
不要在业务代码里连续写很多层 if result.categories.xxx。可以先把值为真的类别收集成列表,同时从分数表取出对应分数,后面的策略层只处理统一的数据结构。
from openai import OpenAI

client = OpenAI()

def classify_text(text: str) -> dict:
    # 使用官方的多模态审核模型,输入这里只放一段文本。
    response = client.moderations.create(
        model="omni-moderation-latest",
        input=text,
    )
    # 先取第一条结果,避免把 SDK 对象直接散落到策略层。
    result = response.results[0]
    categories = result.categories
    scores = result.category_scores

    # 只收集被标记的类别,保留原始类别名以便记录和追踪。
    hits = [name for name, marked in categories.model_dump().items() if marked]
    score_map = scores.model_dump()
    return {
        "flagged": result.flagged,
        "hits": hits,
        "scores": {name: score_map.get(name, 0.0) for name in hits},
    }
这里的 hits 是“模型已经标记的类别”,不是业务最终结论。比如一个输入同时命中两个类别,列表会保留两个原因;即使整体 flagged 为真,也不应该丢掉类别信息。
为不同类别配置不同阈值
多类别判断的难点在于:类别的风险含义和业务处置不一样。可以把类别阈值放在配置里,而不是写死在函数分支中。高风险类别可以直接进入拦截,普通类别在中间区间交给人工复核,低于阈值再放行。阈值只是应用策略,不能把某个示例数字当成所有产品的通用标准。
POLICY = {
    # 高风险类别的分数达到阈值时,直接交给拦截策略。
    "violence": {"review": 0.35, "block": 0.75},
    # 普通类别保留更宽的人工复核区间。
    "harassment": {"review": 0.55, "block": 0.90},
    "hate": {"review": 0.55, "block": 0.90},
}

def decide(result: dict) -> dict:
    # 没有命中类别时,不需要进入逐类别阈值判断。
    if not result["hits"]:
        return {"action": "allow", "reasons": []}

    reasons = []
    action = "allow"
    for category in result["hits"]:
        # 未配置的类别保留为人工复核,避免静默放行未知信号。
        rule = POLICY.get(category)
        if rule is None:
            return {"action": "review", "reasons": [category]}
        score = result["scores"].get(category, 0.0)
        reasons.append({"category": category, "score": score})
        if score >= rule["block"]:
            action = "block"
        elif score >= rule["review"] and action == "allow":
            action = "review"
    return {"action": action, "reasons": reasons}
示例采用“拦截优先于复核,复核优先于放行”的组合规则。实际产品还可以按用户年龄、内容类型、地区或人工队列容量做二次分层,但这些因素应作为单独的业务字段,不要混进模型分数。
把组合结果接到小项目的验收点
从零接入时可以把流程拆成三个模块:请求模块只负责调用 Moderation,归一化模块负责生成 hits 和 scores,策略模块负责输出 allow、review 或 block。这样换模型或调整类别阈值时,不会影响调用代码。
验收时至少准备四种输入:没有命中的文本、只命中一个类别的文本、同时命中多个类别的文本,以及命中类别但分数处于复核区间的文本。每条记录应包含类别名、分数、输入类型和最终动作;不要只记录一个无法解释原因的 flagged=true。
如果请求返回错误,策略层不能把“没有结果”当成“安全”。应把错误交给重试或人工处理分支,并明确记录请求失败原因。官方文档也提示,生成式请求中的 moderation 结果可能是错误对象,读取分数前要先判断结果类型。
相关问题
只看 flagged 可以吗?可以作为最简单的总开关,但无法说明命中了哪个类别,也不适合做差异化处置。
category_scores 能直接当风险概率吗?不建议这样理解。它是模型对类别的置信度,具体阈值应结合业务样本和处置成本校准。
多个类别同时命中时先处理哪个?先定义优先级,通常让拦截优先于人工复核,再优先于放行,同时保留全部命中原因。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
439 收藏
-
241 收藏
-
208 收藏
-
420 收藏
-
418 收藏
-
313 收藏
-
126 收藏
-
418 收藏
-
185 收藏
-
307 收藏
-
250 收藏
-
397 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习