
Hugging Face Datasets ClassLabel 怎样固定分类标签映射
来源:17golang原创
时间:2026-10-27 10:22:34 447浏览 收藏
如果训练集把 cat 编成 0,而验证集又按自己的出现顺序把 dog 编成 0,模型看到的数字就失去了统一含义。Hugging Face Datasets 的正确做法是先确定一份稳定的类别名称顺序,再用同一个 ClassLabel 描述所有数据切片。
官方地址:https://huggingface.co/docs/datasets/en/package_reference/main_classes
ClassLabel(names=[...]) 中列表的位置就是整数标签:第一个名称对应 0,第二个对应 1。不要从当前分片的类别出现顺序临时生成这个列表;把它保存为版本化配置,并让 train、validation、test 和推理代码共同读取。先把 names 顺序定成唯一映射源
ClassLabel 的底层标签按整数保存,names 列表的顺序会被保留。比如下面的映射中,negative 永远是 0,neutral 永远是 1,positive 永远是 2;它不会因为某个数据切片恰好没有出现 negative 就重新编号。
from datasets import ClassLabel

# 这份顺序是数据契约,训练、评估和推理必须共用。
LABEL_NAMES = ["negative", "neutral", "positive"]
label_feature = ClassLabel(names=LABEL_NAMES)

# 位置决定整数值:0=negative,1=neutral,2=positive。
print(label_feature.names)
print(label_feature.num_classes)
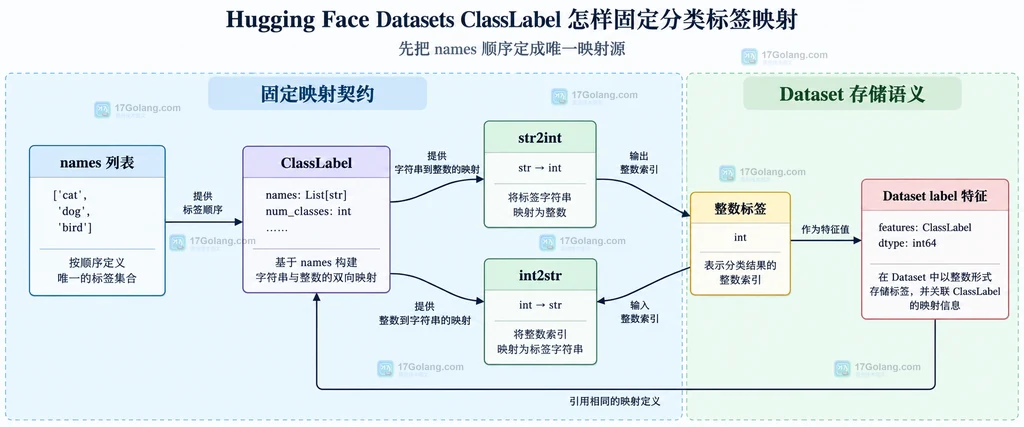
只传 num_classes=3 只能声明标签范围是 0 到 2,并不能表达 0、1、2 分别代表什么。需要固定业务含义时,应优先提供 names,而不是让类别名称留在脚本外部。
字符串标签先 map,再声明 ClassLabel
原始数据如果把标签写成字符串,最稳妥的边界是先用同一个 ClassLabel 做名称到整数的转换,再把列标成对应特征。官方文档也提示,字符串和 ClassLabel 之间的非平凡转换应使用 map() 更新数据。
from datasets import ClassLabel, Dataset

label_names = ["negative", "neutral", "positive"]
label_feature = ClassLabel(names=label_names)
raw = Dataset.from_dict({
    "text": ["很差", "一般", "很好"],
    "label": ["negative", "neutral", "positive"],
})

def encode_labels(batch):
    # 只从固定 names 查编号,不按本批数据重新排序。
    return {"label": [label_feature.str2int(name) for name in batch["label"]]}

encoded = raw.map(encode_labels, batched=True)
# 整数已经写入后,再把列的语义声明为 ClassLabel。
encoded = encoded.cast_column("label", label_feature)

print(encoded.features["label"].names)
print(encoded["label"])
这里的 map 负责改变每一行的值,cast_column 负责让特征描述与该列的语义一致。不要把二者混成“自动从字符串猜类别”的一步;映射源仍然是你显式维护的 label_names。
多个 split 必须复用同一份顺序
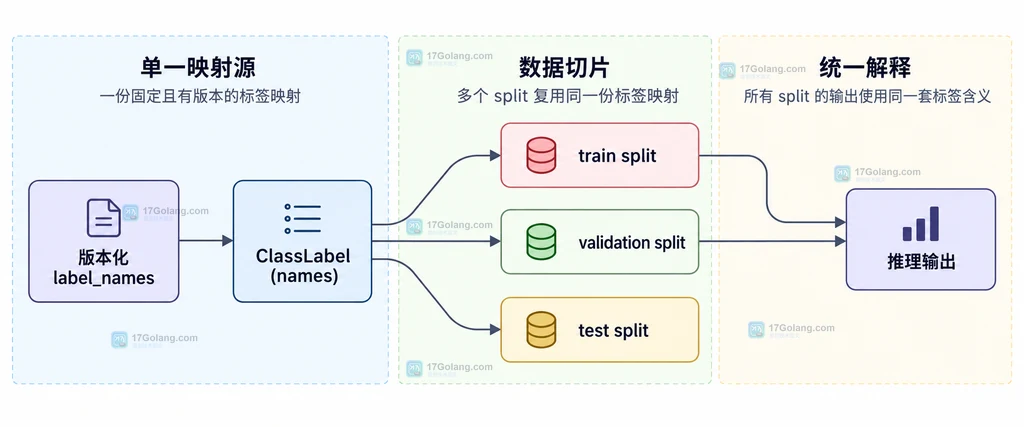
训练、验证和测试集可以分别加载,但不能分别从各自数据中推断 names。最简单的规则是把 label_names 放进项目配置或数据版本目录,创建每个 split 时都传入同一列表。
from datasets import ClassLabel

# 训练、验证和测试集都只引用这一个顺序。
LABEL_NAMES = ["negative", "neutral", "positive"]

def label_feature_for_split():
    # 每个 split 可创建自己的特征对象,但内容必须相同。
    return ClassLabel(names=list(LABEL_NAMES))

train_label = label_feature_for_split()
valid_label = label_feature_for_split()

# 用名称查询时,两个 split 得到相同的整数。
assert train_label.str2int("positive") == valid_label.str2int("positive")
验证集缺少某个类别并不代表应该删除它。完整映射描述的是任务空间,而不是当前分片的统计结果。这样评估输出的类别名称、混淆矩阵列顺序和推理结果才会保持一致。
用 names_file 把映射放进可审计文件
类别较多或需要多人协作时,可以把每行一个名称写入固定文件,再使用 names_file。文件本身就是数据契约的一部分,应该和数据版本或代码提交一起保存,不要在每次加载时按目录内容动态拼接。
from datasets import ClassLabel

# label_names.txt 每行一个名称,文件顺序就是整数顺序。
label_feature = ClassLabel(names_file="label_names.txt")

# 读取反向名称时,仍然使用 ClassLabel 提供的接口。
print(label_feature.int2str(0))
如果文件内容发生变化,即使类别总数没有变化,数字含义也可能变化。因此更换标签顺序应视为数据契约变更,不能只把它当成普通清理。
反向查询和未知标签的边界
得到整数后,可以用 int2str 恢复类别名称;已有名称则可用 str2int 查询编号。名称不在固定列表时不要静默创建新编号,应在数据整理阶段明确处理,否则同一任务会出现未登记的类别。
from datasets import ClassLabel

label_feature = ClassLabel(names=["negative", "neutral", "positive"])

# 这些转换依赖同一份固定顺序。
positive_id = label_feature.str2int("positive")
positive_name = label_feature.int2str(positive_id)
print(positive_id, positive_name)

# 负数可表示未知或缺失标签,但不能拿它做 int2str 的正常类别查询。
unknown_id = -1
官方参考说明,负整数可以用于表示未知或缺失标签,但向 int2str 传入负数会抛出 ValueError。这类值要在业务逻辑中单独处理,不能把它当作 names 中的一个普通类别。
常见误区速查
| 误区 | 真实边界 | 处理方式 |
|---|---|---|
| 每个 split 都根据出现顺序生成 names | 缺失类别会改变数字含义 | 所有 split 复用同一份映射文件 |
| 只写 num_classes 就完成语义映射 | 它只定义 0 到 n-1 的范围 | 固定业务类别时显式写 names |
| cast_column 会自动猜字符串类别 | 字符串到 ClassLabel 的非平凡转换应先 map | 先 str2int,再 cast_column |
| 把未知标签直接传给 int2str | 负整数查询会触发 ValueError | 先分离未知/缺失值,再做反向查询 |
发布前只检查这份映射契约
- 确认
names或names_file的顺序由项目明确维护,而不是从当前样本推断。 - 确认字符串标签经过
str2int转换后,列特征再声明为ClassLabel。 - 确认 train、validation、test 和推理代码读取同一份类别列表。
- 确认未知或缺失标签没有被误传给正常的
int2str查询。
把规则压缩成一句话:ClassLabel 不是替你发现类别顺序的工具,而是把你已经确定的类别顺序写进 Dataset 特征的契约。映射只要跨 split、跨版本或跨推理流程使用,就应显式保存并统一复用。
相关问题
ClassLabel 的第一个 names 一定对应 0 吗?
是。名称列表的位置就是整数标签的顺序,因此列表第一个元素对应 0,后续元素依次递增。
可以只使用 num_classes 不写 names 吗?
可以表示一个整数范围,但无法表达每个数字的业务名称。需要稳定分类语义时,应提供 names 或 names_file。
验证集少一个类别,要不要缩短 names?
不要。验证集仍应使用完整任务映射,缺失类别只是该分片没有样本,不是映射发生变化。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
491 收藏
-
110 收藏
-
208 收藏
-
344 收藏
-
285 收藏
-
科技周边 · 人工智能 | 8小时前 | 人工智能 · 工具调用 · 自定义函数 OpenAI Responses API Function Calling function_call_output strict function_call223 收藏
-
234 收藏
-
292 收藏
-
378 收藏
-
455 收藏
-
科技周边 · 人工智能 | 13小时前 | python · 人工智能 · snapshot_download Hugging Face Hub HF_HUB_CACHE HF_HOME 模型缓存 huggingface_hub247 收藏
-
113 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习