
ONNX Runtime IOBinding 怎样预绑定推理输入输出内存
来源:17golang原创
时间:2026-10-27 11:14:04 352浏览 收藏
一次 GPU 推理排查里,模型本身没有变慢,耗时却集中在执行前后的数据搬运:输入先在 CPU,输出又被默认取回 CPU,设备计算之间夹着看不见的拷贝。要把输入和输出固定在目标设备的预分配内存上,Python 侧应创建 IOBinding,用 OrtValue 描述设备数据,再调用 run_with_iobinding()。固定形状输出可以预先分配;动态形状则让 ONNX Runtime 分配后再取回。
官方地址:https://onnxruntime.ai/docs/api/python/api_summary.html
run()适合普通 feed/fetch,设备内存边界要明确时改用run_with_iobinding()。- 固定输出用
bind_ortvalue_output()绑定预分配缓冲区,动态输出可用bind_output(name, "cuda")。 get_outputs()取得设备侧 OrtValue,copy_outputs_to_cpu()才是显式回读。
一、症状先出现:推理能跑,设备拷贝拖慢边界
常见症状不是报错,而是 GPU 执行正常、端到端延迟却不稳定。时间线通常是:输入数组在 CPU;普通 session.run() 接收 feed;执行提供者把数据送到设备;输出生成后又按默认路径回到 CPU。只看模型算子,很容易把这段搬运误判成计算耗时。
触发条件是输入本来就在 CUDA 内存,或者服务需要连续复用同一块输出缓冲区,但代码仍把 NumPy 数组交给普通 run()。这时要先确认输入输出设备和 shape,再决定是否采用 IOBinding,而不是盲目调整线程数。
二、根因是输入输出没有固定在同一设备内存
IOBinding 的职责是描述“哪个名字绑定到哪类设备内存”。它不是新的模型执行器,也不会自动替你修正 dtype、shape 或 provider。输入可以先由 NumPy 创建,再用 OrtValue.ortvalue_from_numpy(x, "cuda", 0) 放到 CUDA 设备;固定形状输出则用 ortvalue_from_shape_and_type 预留空间。
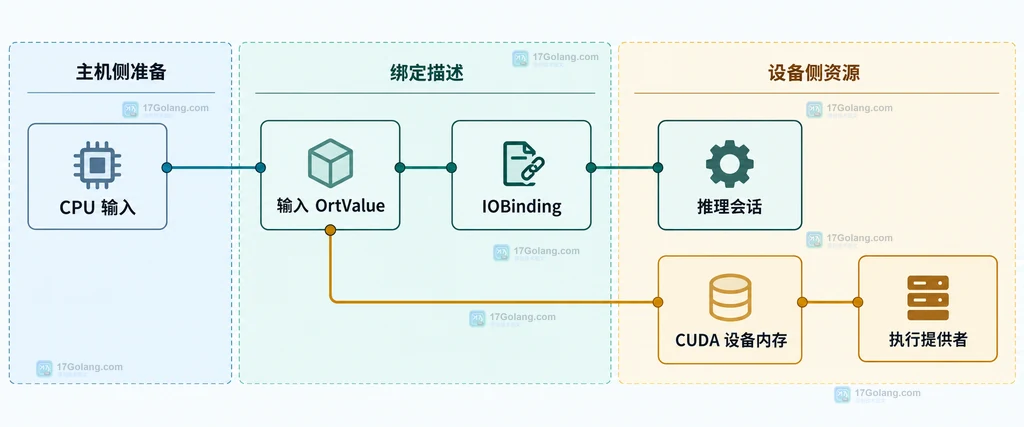
三、修复动作:绑定输入和固定形状输出
下面的代码只展示绑定契约。示例假定模型输入名为 input、输出名为 output,并且输出 shape 已由模型约定为 (1, 1000);实际项目必须以模型元数据为准。
import numpy as np
import onnxruntime as ort

# 输入必须保持连续、dtype 与模型输入契约一致。
x = np.zeros((1, 3, 224, 224), dtype=np.float32)
x_device = ort.OrtValue.ortvalue_from_numpy(x, "cuda", 0)

# 固定形状输出预先占用 CUDA 内存;shape 不能凭空猜测。
y_device = ort.OrtValue.ortvalue_from_shape_and_type(
    [1, 1000], np.float32, "cuda", 0
)

# provider 顺序决定可用的执行设备,CPU 作为回退 provider。
session = ort.InferenceSession(
    "model.onnx",
    providers=["CUDAExecutionProvider", "CPUExecutionProvider"],
)
binding = session.io_binding()

# 绑定输入输出后,用同一个 binding 执行推理。
binding.bind_ortvalue_input("input", x_device)
binding.bind_ortvalue_output("output", y_device)
session.run_with_iobinding(binding)

# 设备侧结果仍由 y_device 持有;需要 NumPy 时再显式回读。
y_cpu = binding.copy_outputs_to_cpu()[0]
这里的修复点有两个:输入不再只以 CPU feed 的形式出现,输出也不再交给运行时临时决定位置。若服务循环复用缓冲区,必须保证上一次推理完成后再覆盖内存;不能把 Python 对象释放、复用或改变 shape 当成无关细节。
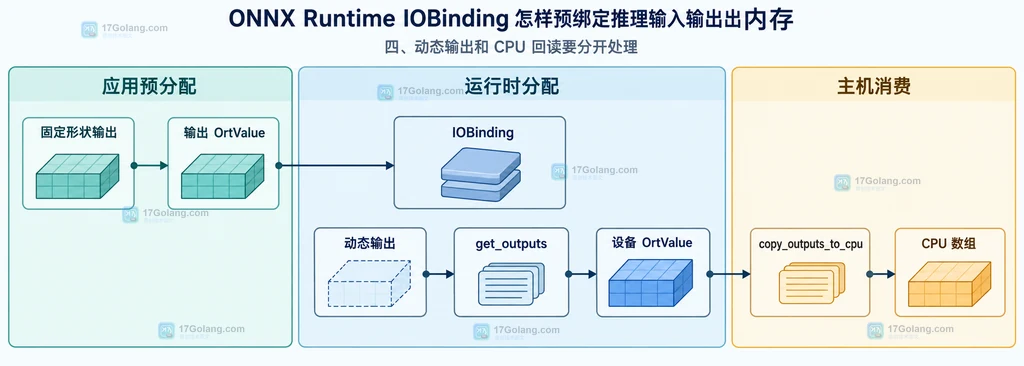
四、动态输出和 CPU 回读要分开处理
有些模型的输出 shape 由输入或数据内容决定,无法提前准备精确的输出缓冲区。这时可以把输出绑定到目标设备,让 ORT 负责分配,再通过 get_outputs() 取得设备侧 OrtValue。只有下游确实需要 NumPy 时,才调用 copy_outputs_to_cpu()。
binding = session.io_binding()

# 输入仍可绑定到设备 OrtValue,避免每轮重新描述数据位置。
binding.bind_ortvalue_input("input", x_device)

# 动态输出由 ORT 在 CUDA 侧分配,不能把未知 shape 写死。
binding.bind_output("output", "cuda", 0)
session.run_with_iobinding(binding)

# 这里拿到的是设备侧 OrtValue;只有跨到 CPU 才产生回读。
output_ortvalue = binding.get_outputs()[0]
output_cpu = binding.copy_outputs_to_cpu()[0]
get_outputs() 和 copy_outputs_to_cpu() 不是同一个动作:前者保留设备侧对象,后者把内容复制成 CPU 可消费的结果。若后续算子也在 CUDA 上,优先沿用设备对象;若要交给 NumPy、序列化或 CPU 后处理,再明确回读位置。
五、防复发:上线前核对四个边界
| 核对项 | 要确认的事实 | 常见后果 |
|---|---|---|
| Provider | CUDA provider 已注册且顺序符合预期 | 实际落回 CPU,绑定收益消失 |
| Shape 与 dtype | OrtValue 和模型输入输出契约一致 | 绑定失败或结果解释错误 |
| 内存生命周期 | 推理完成前不释放、不覆盖设备缓冲区 | 复用时出现难定位的数据问题 |
| 回读边界 | 只有 CPU 下游才调用 copy_outputs_to_cpu() | 设备流水线被额外拷贝打断 |
如果输出是固定 shape,优先使用应用侧预分配的 OrtValue;如果输出 shape 动态,就让 ORT 分配并把设备对象交给下游。IOBinding 解决的是数据位置和绑定关系,不等于模型一定更快,最终仍需在目标 provider、真实 batch 和完整业务链路上单独测量。
相关问题
IOBinding 会自动把 CPU 输入变成 CUDA 输入吗?
使用 bind_cpu_input() 时,运行时仍可能在执行阶段把数据拷贝到目标设备;若要明确复用设备内存,应创建设备 OrtValue 或使用设备指针绑定。
动态输出为什么不直接预分配?
因为真实 shape 可能由输入决定。预分配 shape 不准确时会破坏绑定契约,动态场景更适合让 ORT 分配,再通过 get_outputs() 取得结果。
什么时候必须调用 copy_outputs_to_cpu?
当下游接口只接受 NumPy 或 CPU 数据时调用;如果下游仍在 CUDA 上,先保留设备侧 OrtValue,避免无目的的跨设备复制。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
491 收藏
-
110 收藏
-
208 收藏
-
447 收藏
-
344 收藏
-
285 收藏
-
科技周边 · 人工智能 | 9小时前 | 人工智能 · 工具调用 · 自定义函数 OpenAI Responses API Function Calling function_call_output strict function_call223 收藏
-
234 收藏
-
292 收藏
-
378 收藏
-
455 收藏
-
科技周边 · 人工智能 | 14小时前 | python · 人工智能 · snapshot_download Hugging Face Hub HF_HUB_CACHE HF_HOME 模型缓存 huggingface_hub247 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习