
Diffusers attention slicing 为什么可能与高效注意力重复优化
来源:17golang原创
时间:2026-10-27 15:46:10 240浏览 收藏
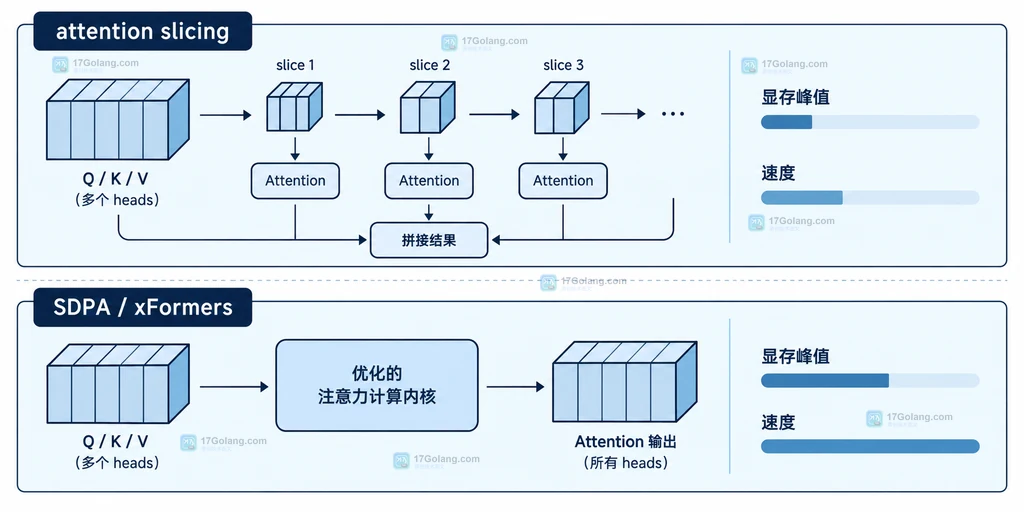
如果 Diffusers 管线已经使用 PyTorch 2.0 及以上的 SDPA,或者已经启用 xFormers 等 memory-efficient attention 后端,就不要再把 enable_attention_slicing() 当作第二层显存优化。attention slicing 会把注意力输入拆成多个片段,依次计算来降低峰值显存;而高效注意力后端本身已经在内核或实现层面处理了显存效率。两者同时打开时,可能增加串行计算和调度开销,结果是推理变慢。
官方地址:https://huggingface.co/docs/diffusers/en/optimization/memory
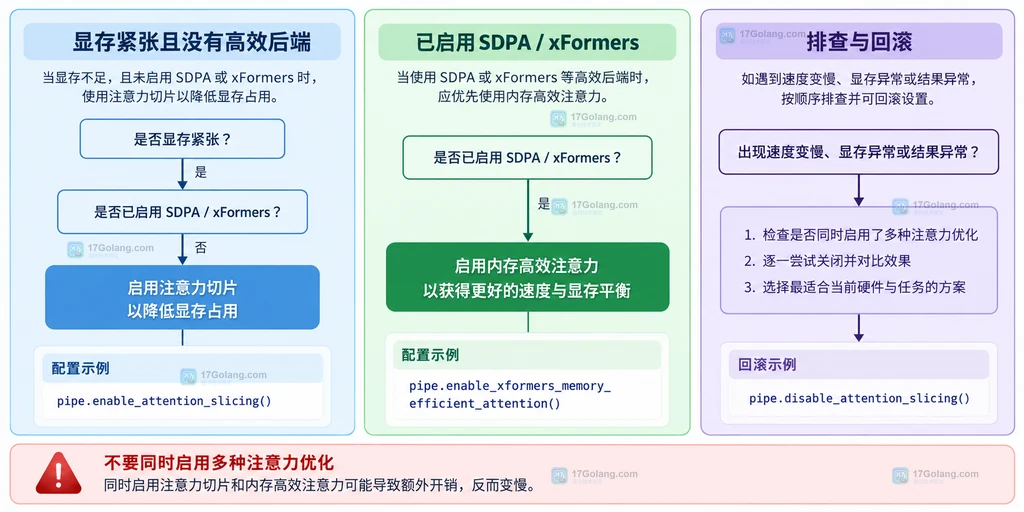
排查顺序很简单:先确认管线是否走 SDPA 或 xFormers;已经有高效后端时优先关闭 attention slicing。只有在没有合适高效后端、且确实受到显存峰值限制时,才把 slicing 作为保守的降峰值方案。
一、先把 attention slicing 和高效注意力分开理解
attention slicing 的思路是把一次注意力计算拆成多个 slice,再按顺序处理。它的收益是降低单次计算需要保留的中间张量规模,代价是需要更多轮次的计算与调度。Diffusers 的接口是 enable_attention_slicing(slice_size="auto"),默认的 auto 会把注意力头输入分成较少的片段;使用 max 可以进一步压低显存,但通常会牺牲更多速度。
SDPA、xFormers、FlashAttention 等高效注意力后端解决的是另一层问题:用更高效的实现执行注意力计算,减少不必要的中间结果或改善内存访问。它们不是简单地把同一段输入切成小块,而是替换或选择更适合硬件的计算路径。因此,不要把“slicing”和“memory-efficient”理解成可以无限叠加的两个档位。
二、为什么同时开启可能让推理更慢
当高效注意力后端已经接管注意力计算时,额外的 slicing 可能会把调用拆得更碎:一方面,串行处理降低了并行度;另一方面,多个 slice 会带来更多循环和调度。官方 API 文档明确提醒,如果已经使用 PyTorch 2.0 以上的 scaled_dot_product_attention 或 xFormers,再启用 attention slicing 可能导致严重变慢。
这不是说两者一定会同时执行两套完全独立的注意力算法。以 xFormers 路径为例,官方文档说明 memory-efficient attention 在两者同时开启时具有优先级。但“最终没有按你预想的方式叠加”并不等于“开关可以全部保留”:多余的状态设置会让配置难以解释,也可能在不同 pipeline、组件或版本组合下产生不同的性能表现。
因此,看到显存下降但吞吐明显变差时,优先检查是否同时保留了 enable_attention_slicing() 和高效注意力后端,而不是马上把 slice 调得更小。
三、没有高效后端时,如何使用 slicing
如果当前环境没有可用的 SDPA、xFormers 或其他高效注意力实现,而且首要问题是显存峰值,可以从默认的 auto 开始。下面的示例只打开一个保守开关,并把设备、精度和推理参数写清楚,方便之后对照耗时。
import torch
from diffusers import StableDiffusionPipeline

# 使用半精度减少模型权重占用;实际设备按部署环境选择
pipe = StableDiffusionPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    torch_dtype=torch.float16,
    use_safetensors=True,
).to("cuda")

# 没有可用高效注意力后端时,用分片计算压低注意力峰值显存
pipe.enable_attention_slicing("auto")

# 固定推理参数,便于比较显存峰值与单次耗时
result = pipe(
    "a small observatory above the clouds",
    num_inference_steps=20,
)
image = result.images[0]
image.save("attention-slicing-output.png")  # 保存结果,避免只比较日志而遗漏输出
auto 不是“越省显存越好”的开关。如果仍然 OOM,再考虑更激进的 max,但要把它视为速度与显存之间的交换,而不是默认配置。
四、已经使用 SDPA 或 xFormers 时,如何去掉重复设置
高效后端已经生效时,配置应当保持单一职责:让高效后端承担注意力实现,让 pipeline 的其他内存优化按实际瓶颈单独配置。若代码中以前调用过 slicing,可以显式关闭它。
import torch
from diffusers import StableDiffusionPipeline

# 先创建管线,再由当前环境选择注意力后端
pipe = StableDiffusionPipeline.from_pretrained(
    "stable-diffusion-v1-5/stable-diffusion-v1-5",
    torch_dtype=torch.float16,
    use_safetensors=True,
).to("cuda")

# 如果初始化流程曾经打开 slicing,先撤销这个额外状态
pipe.disable_attention_slicing()

# 仅在依赖已安装且硬件支持时启用 xFormers;失败应直接暴露,避免悄悄误判路径
pipe.enable_xformers_memory_efficient_attention()

result = pipe(
    "a small observatory above the clouds",
    num_inference_steps=20,
)
image = result.images[0]
image.save("efficient-attention-output.png")  # 用固定参数保存对照结果
如果项目使用的是 PyTorch 的 SDPA,则不必额外加上 slicing。具体后端选择仍取决于模型、硬件和 Diffusers 版本;不要把某一台机器上的最快路径当成所有部署环境的结论。
五、用三个信号判断是否选错了路径
| 观察信号 | 更可能的原因 | 处理建议 |
|---|---|---|
| 显存不足,但没有高效后端 | 注意力中间结果的峰值过高 | 先尝试 auto slicing,再按需调整 |
| 显存下降,耗时明显增加 | slice 过细,或与高效后端重复设置 | 关闭 slicing,或恢复较宽的 slice |
| 启用 xFormers 后速度没有预期变化 | 实际路径、组件支持或依赖状态不符合预期 | 先确认后端能否工作,再比较同一批参数 |
| 更换模型后表现反转 | UNet 与 transformer 架构对优化收益不同 | 按当前模型重新测量,不复制旧配置 |
测量时至少固定提示词、分辨率、批量、推理步数和精度;分别记录单次耗时与显存峰值。这样才能判断是优化真正带来了收益,还是只是把 OOM 换成了更慢的推理。
六、保留清晰的回滚路径
线上配置不要把多个注意力开关散落在不同模块。可以把选择集中到一个函数中,并在切换时只保留一条主路径。发生回归时,先回到“关闭 slicing、保留高效后端”的基线;如果基线仍然 OOM,再回退到没有高效后端但启用 slicing 的方案。
def configure_attention(pipe, use_efficient_backend: bool, use_slicing: bool):
    # 先清掉历史状态,避免同一实例残留上一轮的 slicing 配置
    pipe.disable_attention_slicing()

    if use_efficient_backend:
        # 高效后端与 slicing 二选一,避免把速度问题误归因于模型本身
        pipe.enable_xformers_memory_efficient_attention()
    elif use_slicing:
        # 只有没有高效后端时,才把 slicing 作为显存兜底
        pipe.enable_attention_slicing("auto")

    return pipe
这个函数不保证每种 pipeline 都支持相同的后端接口,但它表达了一个重要原则:每次只保留可解释的选择。对于已经启用 hooks 或其他状态化内存策略的管线,切换前应按对应文档完成实例重建或清理,不要在同一实例上无序叠加状态。
总结
Diffusers attention slicing 适合在缺少更高效注意力后端、且显存峰值确实成为瓶颈时使用。SDPA、xFormers 等后端已经针对注意力的内存效率做过优化;此时继续打开 slicing 可能降低并行度或引入额外调度,出现“更省显存但更慢”的结果。实际排查时先识别后端,再选择一条最小配置,并用固定参数比较显存与耗时。
常见问题
1. attention slicing 会改变生成内容吗?
它主要改变注意力计算的分片方式,文章讨论的直接影响是显存和速度。若结果出现差异,应固定随机种子、精度和后端后再单独比较,不能仅凭一次输出下结论。
2. xFormers 和 slicing 同时写在代码里会立刻报错吗?
不一定。官方文档说明高效注意力在同时启用时可能具有优先级,但这不代表多余的 slicing 没有性能代价。更稳妥的做法是删除不需要的开关或显式关闭。
3. 显存仍然不够,只能继续把 slice 调小吗?
不一定。还应检查分辨率、批量、精度、VAE slicing、VAE tiling、模型或 CPU offload 等独立因素。不要把所有内存问题都归结为 attention slicing。
-
398 收藏
-
175 收藏
-
309 收藏
-
338 收藏
-
158 收藏
-
351 收藏
-
252 收藏
-
149 收藏
-
325 收藏
-
132 收藏
-
352 收藏
-
491 收藏
-
110 收藏
-
208 收藏
-
447 收藏
-
344 收藏
-
285 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习