
Sentence Transformers 怎样用 CrossEncoder 对候选文档重排
来源:17golang原创
时间:2026-10-29 16:44:01 224浏览 收藏
对已有候选文档做重排,可以把同一个查询和每段候选文本交给 CrossEncoder.rank(query, documents),再按返回的 corpus_id 找回业务文档。它返回按相关性分数排序的列表;top_k 控制保留条数,return_documents=True 可以一并返回文本。
官方地址:https://www.sbert.net/
重排接入后“第一条还是不对”,未必是调用失败。先看答案是否进入候选,再看模型适用语言,最后核对返回结果的文档映射。以下以一个英文客户端超时知识库为例,代码是供读者使用的完整示例,未在本文环境执行,不展示虚构的模型输出。
排序不理想时,先确认候选里有没有答案
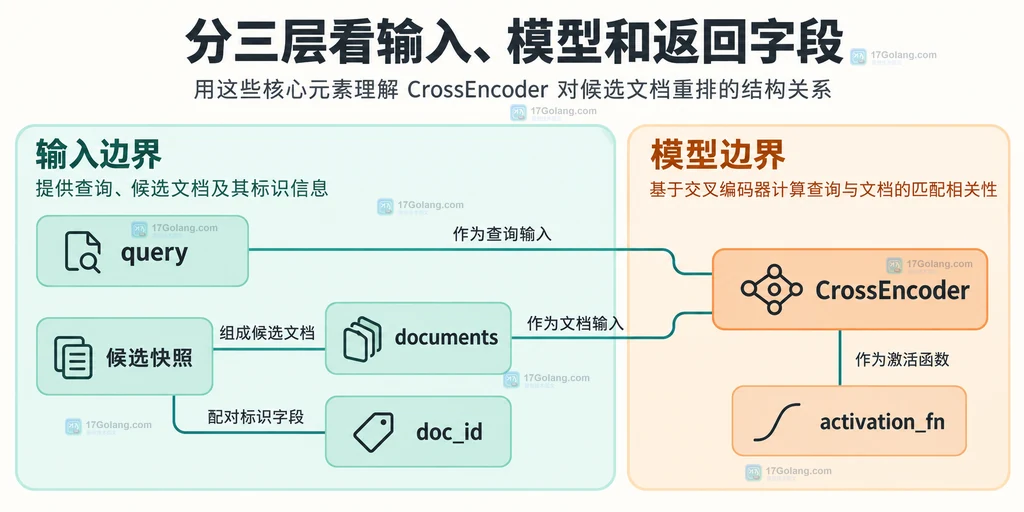
CrossEncoder联合处理查询与候选文本,为每个配对计算相关性。它不会从整个知识库自动找出新文档,也不提供可预先存储、用于向量索引的单条文本嵌入。通常由关键词检索或向量检索先给出较小候选集,再对这些候选重排。官方用法对这一定位有明确说明。CrossEncoder 使用文档
例如查询“客户端怎样避免一直等待慢服务”,候选里只有缓存和日志说明,重排器再准确也无法返回未被召回的超时文档。候选召回覆盖不足时应修正检索、过滤条件或切分策略;候选已包含目标段落却排得很靠后,才继续分析配对打分。
分三层看输入、模型和返回字段
| 层次 | 需要关注的对象 | 容易混淆的地方 |
|---|---|---|
| 输入 | query、documents、候选快照 | 模型读的是文本内容,业务ID必须由应用另行保留 |
| 模型 | CrossEncoder、activation_fn | 模型任务、语言、分数转换共同影响含义 |
| 输出 | corpus_id、score、可选text | 排序位置不是原候选位置,corpus_id也不是数据库ID |
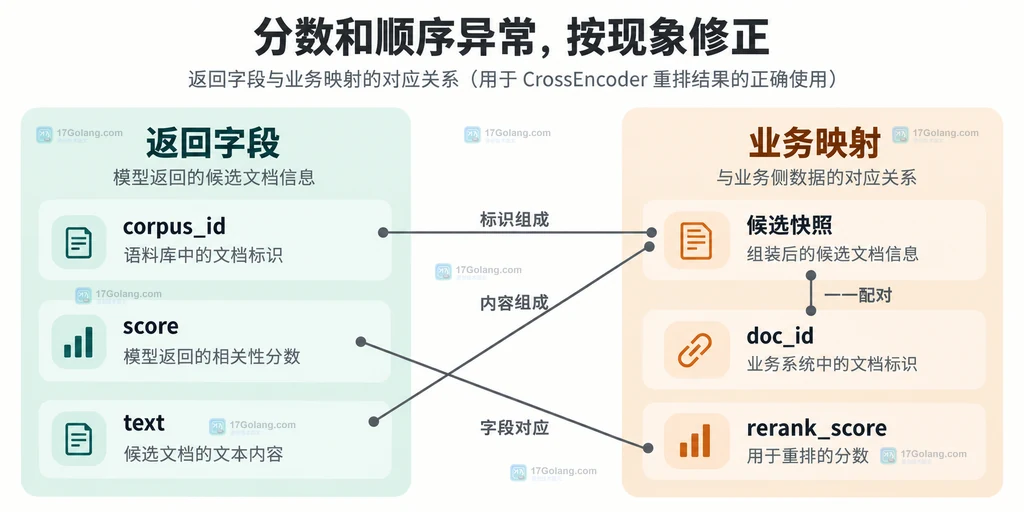
corpus_id 是传给本次 rank 的 documents 列表下标。若返回列表第一项的 corpus_id 为某个下标,只能据此映射回该次输入,不能据名次取候选第一项。return_documents=True 返回的 text 方便观察,但重复文本仍要依靠原始位置找回不同业务记录。字段和参数含义见官方 CrossEncoder API。
用完整示例保留文档身份
先在自己的 Python 环境安装依赖,再保存下方代码。首次加载模型需要能够取得模型文件;生产服务可在初始化时加载并复用模型,不要在每次请求函数里重复构造。
# 在当前Python环境安装Sentence Transformers及其依赖
python -m pip install sentence-transformers
from sentence_transformers import CrossEncoder
import torch

# 固定本次候选快照,位置索引与业务文档编号分别保留
candidates = [
    {"doc_id": "guide-timeout", "text": "Set a request timeout so a slow service cannot block the client forever."},
    {"doc_id": "guide-cache", "text": "Cache frequently requested records to reduce repeated database reads."},
    {"doc_id": "guide-backoff", "text": "For temporary request failures, retry with a limited exponential backoff."},
]
query = "How can a client avoid waiting forever for a slow service?"

# 英文段落重排示例;明确返回原始logit,模型仅加载一次
model = CrossEncoder(
    "cross-encoder/ms-marco-MiniLM-L6-v2",
    activation_fn=torch.nn.Identity(),
)

def rerank(query, candidates, limit=2):
    if not query.strip():
        raise ValueError("查询文本不能为空")
    if limit
这里的 batch_size=8 是示例配置,不是性能最佳值。top_k=2 只限制输出为两个候选,不代表只评估输入列表前两条,也不应把它当作减少初始召回规模的参数。例子明确使用 torch.nn.Identity(),避免把激活函数的默认约定误当成业务概率。
代码保留了候选快照顺序,只对模型结果进行映射,返回独立的 rerank_score。如果原系统还有向量相似度,应使用不同字段保存,避免把不同模型、不同刻度的分数直接相加。示例没有吞掉模型加载或推理异常;服务接入时可在外层记录失败并按产品约定退回原召回顺序,但必须区分“降级结果”和“重排成功”。
分数和顺序异常,按现象修正
选用的 cross-encoder/ms-marco-MiniLM-L6-v2 是英语段落排序模型,模型卡标注 English,并说明其训练任务为 MS MARCO Passage Ranking。中文界面不影响 Python 调用,但不能据此推断该模型在中文业务语料上的排序能力。中文或跨语言任务应另选有对应语言能力说明的重排模型,并根据该模型的输入约定接入。官方模型卡
| 现象 | 证据指向 | 修复动作 |
|---|---|---|
| score小于0或大于1 | 示例返回原始logit,数值范围不受0到1限制 | 按相对大小排序,不当成异常值丢弃 |
| 文本和业务ID对不上 | 按排名位置或变动后的候选列表映射 | 用同一候选快照的corpus_id映射 |
| 短段落合理、长文档不理想 | 输入可能超出模型长度而被截断 | 按模型长度预算切分段落,保留父文档ID和片段ID |
| 英文示例可用,中文材料表现不佳 | 模型语言或领域不匹配 | 更换适配模型,保留同样的ID映射约定 |
| 候选增多后延迟上升 | 需要处理的查询与候选配对变多 | 先合理限制召回量,再结合设备和文本长度调整批量 |
Sigmoid可以把logit单调映射到0到1区间,单纯这一变换不改变排序;映射后的数也不自动成为经过校准的“回答正确概率”。不要套用统一的0.5相关阈值,更不要跨查询、跨模型直接比较分数。若换成输出多个类别的分类模型,也不能把任意一列或分类向量直接沿用为本示例的单分数重排协议。
怎样确认改动针对了正确问题
排查应从反面提问:目标文本不在候选里,换重排模型能否补回来?不能,问题在召回。目标在候选里且分数合理,但展示的是另一篇文档,问题更可能在ID映射。只改Sigmoid却希望名次翻转,方向也不对,因为单调变换保留相对次序。这些判断能避免把展示错误、召回缺失都归结为模型效果。
- 保存查询对应的候选快照,明确候选是文档还是片段。
- 确认模型支持业务语言和任务,长输入按模型限制处理。
- 用corpus_id映射业务ID,不把排序位置当原始下标。
- 独立保存rerank_score,明确是否做过激活变换。
- top_k控制返回量,候选规模控制需要参与重排的数据范围。
- 对降级保留明确状态,不能将原始检索结果标为重排结果。
predict和rank有什么区别?
predict 接收文本对并返回对应分数;应用需要自行保留配对顺序并排序。rank 面向一个查询和一组文档,提供已排序结果及原候选下标。只做候选重排时,后者能减少手写排序和索引映射的代码。
同一文档分成多个片段后怎么办?
把业务文档ID和片段ID一起保存在候选快照中,先重排片段,再按产品目标决定是否合并父文档。多个片段来自同一篇文章,不能仅凭text去重后再沿用旧corpus_id。
所有候选都不相关,也会返回前几条吗?
会。top_k表达的是相对排序和返回数量,不是相关性合格承诺。系统是否允许空结果、采用什么拒答条件,需要另以业务数据制定,不能从“排在第一”推导出“足以回答”。
-
295 收藏
-
195 收藏
-
482 收藏
-
229 收藏
-
171 收藏
-
483 收藏
-
185 收藏
-
420 收藏
-
415 收藏
-
150 收藏
-
269 收藏
-
372 收藏
-
298 收藏
-
472 收藏
-
350 收藏
-
科技周边 · 人工智能 | 2小时前 | 性能优化 · Hugging Face Datasets IterableDataset flatten_indices indices mapping Arrow222 收藏
-
326 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习