
NLTK Tree 的叶节点位置与树节点位置有什么区别
来源:17golang原创
时间:2026-10-31 06:43:14 197浏览 收藏
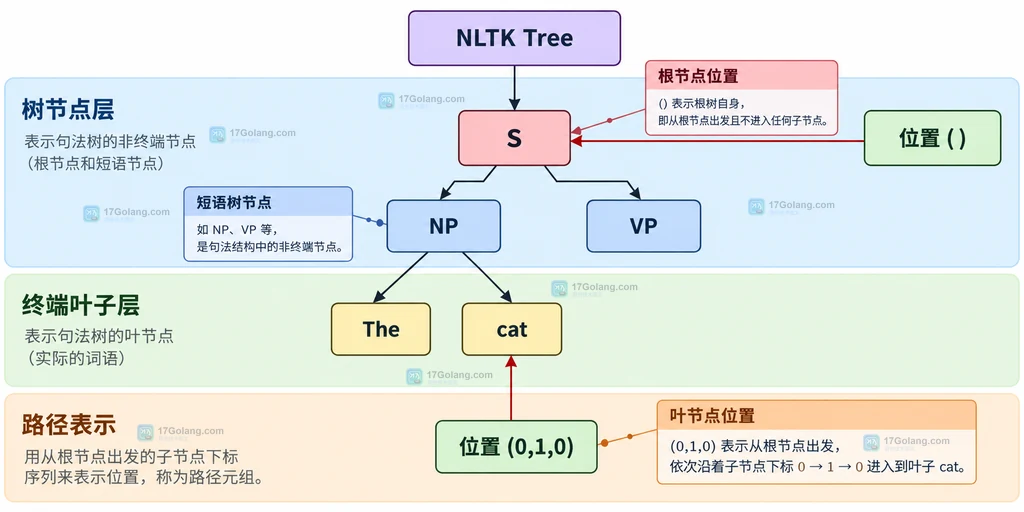
在 NLTK 的句法树处理中,叶节点位置和树节点位置都用元组表示,但它们回答的不是同一个问题:叶节点位置要定位某个具体词,树节点位置则可以定位根节点、短语节点或叶子。最容易混淆的地方是,treepositions() 默认会返回整棵树的所有位置,而 treepositions('leaves') 才只返回叶子位置。
官方地址:https://www.nltk.org/api/nltk.tree.html
()表示当前Tree自身;(0, 1)表示从当前树依次进入第 0 个和第 1 个子节点。treepositions()默认遍历内部节点与叶子,treepositions('leaves')只保留叶子路径。leaf_treeposition(i)连接叶子线性序号与树路径;连续短语则用treeposition_spanning_leaves()。
一、先把“位置”看成从根节点出发的路径
可以用一棵很小的句法树来统一术语:
from nltk.tree import Tree

# 用括号结构创建一棵句法树;叶子是最终的词语字符串
tree = Tree.fromstring("(S (NP (DT The) (NN cat)) (VP (VBD slept)))")

# 空元组指向根树 S;元组中的整数是当前层的子节点下标
root = ()
subject = (0,)
subject_word = (0, 1, 0)

print(tree[root].label())
print(tree[subject].label())
print(tree[subject_word])
这里的 () 指向根 S,(0,) 指向第一个子树 NP,(0, 1, 0) 则依次进入 NP、NN 和它的第一个孩子,最终到达叶子 cat。因此,“树节点位置”不是只能指内部节点,它是一个更宽的路径概念;叶节点位置是其中专门落在叶子上的一部分。
二、treepositions() 与 treepositions('leaves') 返回范围不同
treepositions() 默认使用前序遍历,会把根、内部树节点和叶子都列出来;传入 'leaves' 后,返回值只保留能走到叶子的路径。两者的返回顺序仍然与树的层级结构相关,不是按字符串长度排序。
# 默认结果包含根、短语节点和叶子位置
all_positions = tree.treepositions()

# 叶子位置的顺序与 tree.leaves() 一致
leaf_positions = tree.treepositions(order="leaves")

print(tree.leaves())
print(leaf_positions)

# 只有叶子路径才能直接取出词语;内部节点取出的是 Tree 对象
for position in leaf_positions:
    print(position, tree[position])
判断一个位置属于哪一类时,不要只看元组长度:深层内部节点可能和浅层叶子拥有相同的路径长度。更稳妥的区分方式是查看 tree[position] 是否仍然是 Tree;如果不是,就已经到达叶子值。
| 方法或表达式 | 定位对象 | 适合的任务 |
|---|---|---|
tree.treepositions() | 全部树位置和叶子位置 | 遍历整棵树或统计层级 |
tree.treepositions('leaves') | 只有叶子路径 | 按词序处理终端符号 |
tree.leaves() | 叶子值列表 | 获取线性词序,不关心路径 |
tree[position] | 路径对应的节点或叶子值 | 读取或修改指定位置 |
三、leaf_treeposition() 解决“第几个叶子在哪里”
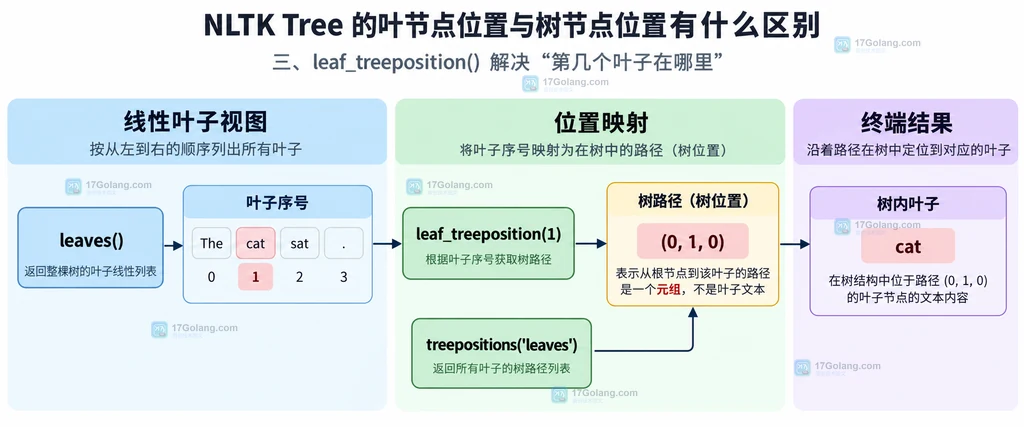
leaves() 给出的是扁平列表,适合按词序编号;leaf_treeposition(index) 则把这个编号映射回原始树路径。官方定义的关键关系是:返回路径后,用 tree[path] 取到的值就是 tree.leaves()[index]。
# 线性编号从 0 开始;先拿到第二个叶子的树内路径
index = 1
position = tree.leaf_treeposition(index)

# 用同一个路径回到树中,结果应对应 leaves()[1]
leaf_from_tree = tree[position]
leaf_from_list = tree.leaves()[index]
print(position, leaf_from_tree, leaf_from_list)

# 负数或超出叶子数量的索引会触发 IndexError
try:
    tree.leaf_treeposition(-1)
except IndexError:
    # 调用方可以把非法叶子序号转换成自己的参数错误
    print("leaf index must be non-negative")
这个方法很适合“先在分词结果里定位第几个词,再回到句法树找它的父节点”的场景。相反,如果你已经知道的是 (0, 1, 0) 这样的路径,就直接用下标访问,不需要先经过叶子序号。
四、连续叶子范围要找覆盖它们的树节点
当任务从“找一个词”变成“找一段连续短语”时,叶子位置仍然不够。treeposition_spanning_leaves(start, end) 接收半开区间 [start, end),返回能够覆盖这段叶子的最低后代节点的位置。比如要覆盖 cat 及其后面的动词,需要先确认叶子序号,再把范围交给该方法。
# 选择叶子序号 [0, 2),即 The 和 cat 这一段
span_position = tree.treeposition_spanning_leaves(0, 2)
span_tree = tree[span_position]

# 结果是覆盖这段叶子的最低节点,而不是任意一个祖先
print(span_position, span_tree.label())
范围的 end 必须大于 start。要提取单个叶子,用 leaf_treeposition() 更直观;要找能够包住一组叶子的短语,使用 spanning 方法更贴合语义。
常见问题
为什么 treepositions() 的第一个结果通常是 ()?
因为空元组代表当前 Tree 自身,而默认遍历会从根节点开始。它不是“没有位置”,而是根节点相对于自己不需要再经过任何子节点。
叶子位置可以直接用来访问短语节点吗?
不可以。叶子位置最终指向字符串等终端值;短语节点的位置应停留在对应的 Tree 层。需要覆盖一段叶子时,用 treeposition_spanning_leaves() 找到对应的最低树节点。
速查:按问题选择方法
- 只要词语顺序:用
leaves()。 - 要所有节点路径:用
treepositions()。 - 要所有叶子路径:用
treepositions('leaves')。 - 已知第几个叶子:用
leaf_treeposition(index)。 - 已知连续叶子范围:用
treeposition_spanning_leaves(start, end)。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
203 收藏
-
356 收藏
-
210 收藏
-
467 收藏
-
444 收藏
-
306 收藏
-
484 收藏
-
136 收藏
-
131 收藏
-
230 收藏
-
413 收藏
-
392 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习