
vLLM continuous batching 的请求调度观察点
来源:17golang原创
时间:2026-11-01 03:28:44 211浏览 收藏
观察 vLLM continuous batching,先把等待请求、正在运行的请求、每轮处理的 token、KV 缓存占用和延迟放在同一时间窗口里看。单独看到 Running 增多或吞吐上升,不能证明调度更合理;还要确认首 token 等待和持续输出是否满足业务目标。
官方地址:https://docs.vllm.ai/
以下面向单实例在线生成服务,重点是升级前后如何保留指标含义。latest 文档会继续变化,部署时应保存实际版本、镜像标识和启动参数;本文不指定一个所有版本通用的最优参数,也不提供实测性能结论。
先限定调度观察的版本与服务范围
continuous batching 可以把不同请求的计算组织到持续变化的批次中。请求长度不同,完成时刻不同,因此一个服务的并发请求数并不是固定的“批大小”。观察时至少记录模型、输入长度分布、输出上限、请求到达速率、并行配置和前缀缓存状态,避免把工作负载变化误认为升级效果。
先在一个明确的实例上建立视图,再比较副本。集群总量适合看容量,实例视图适合发现负载倾斜:总等待量一样,集中在一台实例和均匀分布的处理办法可能完全不同。下面用 instance 区分 Prometheus 抓取目标;它是采集侧标签,不是所有环境都会自动具有的 vLLM 标签。
把旧监控表达式迁移为四组观察点
| 观察组 | 当前文档中的指标 | 读数含义及限制 |
|---|---|---|
| 请求状态 | vllm:num_requests_running、vllm:num_requests_waiting | 区分执行批次中的请求与等待处理的请求;不是所有 HTTP 连接数量。 |
| 缓存压力 | vllm:kv_cache_usage_perc | KV 缓存使用比例,1 表示全部使用;不是 GPU 总显存利用率。 |
| 调度工作量 | vllm:iteration_tokens_total | 每个 engine step 的 token 数直方图;不能按名称中的 total 当成普通计数器。 |
| 用户等待 | vllm:time_to_first_token_seconds、vllm:request_queue_time_seconds | 分别观察首 token 与排队时间分布,不能把前者全部归因于队列。 |
旧版设计资料可见 gpu_cache_usage_perc 和 time_per_output_token_seconds 等名称。迁移时应逐条对照部署版本的指标说明,不要全局字符串替换后就认为统计口径一致。当前设计文档还区分流式输出事件之间的 ITL 和每请求统计的 TPOT;一个输出事件含多个 token 时,两者尤其不能直接互换。
这些名称和口径来自 官方生产指标说明、当前指标设计与旧版设计资料。不存在的时间序列不能用补零伪装成“没有等待”。
避免把请求数和 token 预算混为一谈
max_num_seqs 与 max_num_batched_tokens 约束的对象不同:前者限制单轮的序列数量,后者限制单轮的 token 数量。KV 缓存又是另一项资源条件。即使请求数量没有达到上限,也不能据此断言还有充足的调度余量。
在支持并启用 chunked prefill 的 V1 场景,官方调优说明描述了优先安排 decode、用剩余 token 预算安排 prefill 的策略;放不下的 prefill 可以分块。因此,同样数量的请求,长输入和短输入的调度压力不同。图中三个分组只表达约束归属,不代表执行顺序。
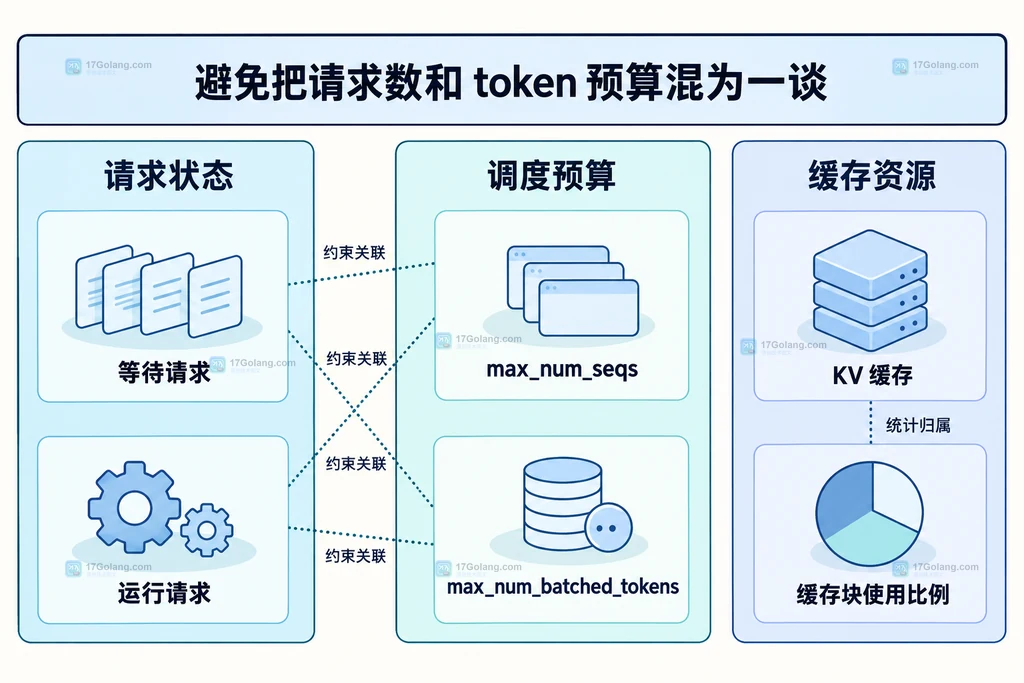
该策略及参数取舍参见 vLLM 官方调优说明。具体能力仍取决于引擎、模型及部署配置,不能把文档中的典型策略当成所有扩展调度器的实现承诺。
用最小指标查询保留实例和直方图语义
下面是给已有 Prometheus 服务使用的查询示例,未在本文环境执行。把 job 名替换为实际采集任务;五分钟窗口只是起点,需结合抓取间隔和业务流量调整。
# 按实例观察等待请求,保留负载倾斜信息
sum by (instance) (vllm:num_requests_waiting{job="vllm"})

# 对累计桶先求速率,并保留 le,得到各实例首 token 的 P95
histogram_quantile(
  0.95,
  sum by (instance, le) (
    rate(vllm:time_to_first_token_seconds_bucket{job="vllm"}[5m])
  )
)

# 迭代 token 直方图的和除以次数,表示每轮平均 token 数
sum by (instance) (
  rate(vllm:iteration_tokens_total_sum{job="vllm"}[5m])
)
/
sum by (instance) (
  rate(vllm:iteration_tokens_total_count{job="vllm"}[5m])
)
最后一个表达式的分母是迭代次数速率,不是请求数速率,所以结果不能称为“每请求输出 token”。空闲时分母可能为零,应显示无有效样本。短时间尖峰也可能被抓取间隔或平均窗口平滑掉,不能从一张平稳曲线推断逐轮调度完全平稳。
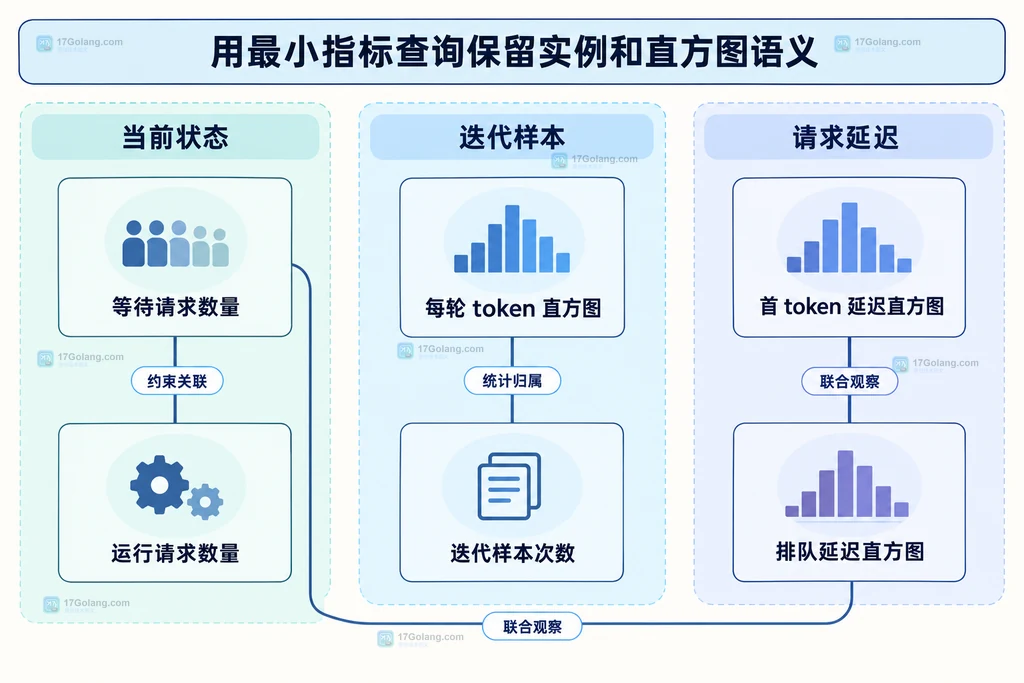
对照工作负载解释参数取舍
假设升级后输出吞吐上升,但首 token P95 变差。先比较输入长度和到达速率是否一致,再把排队时间、运行请求和缓存比例并排观察。若排队也明显增加,容量不足或分配不均值得继续调查;若排队变化小而长输入增多,则不能只靠扩大并发来解释或修复。这是排查假设,不是单凭指标即可成立的因果结论。
在 chunked prefill 下,缩小 token 预算通常有利于减少 prefill 对 decode 的干扰,扩大预算则给 prefill 更多空间;官方说明将其与 ITL、TTFT 的取舍联系起来。实际选择应由交互体验目标决定:聊天关注持续输出,长文档问答也关注长输入后的首 token 等待。
如果缓存占用高且抢占增加,应把缓存压力纳入判断;官方 V1 调优资料说明默认抢占使用 RECOMPUTE。不要沿用旧面板上的 SWAP 解释所有暂停,也不要只提高序列上限。每次只改变一个参数,并保留同一负载下的延迟、错误和吞吐记录,才能判断收益是否伴随代价。
迁移清单与常见问题
- 保留旧版本、旧启动参数和旧指标定义,给新面板标注适用部署。
- 检查指标名称、单位、类型和标签;缺失序列与真实零值分别处理。
- 保留实例维度,在同一窗口观察队列、缓存、迭代工作量与延迟。
- 固定请求分布后比较调整效果,不把示例参数当成生产最优值。
等待请求多,一定是 GPU 算力不够吗?不能这样判断。还应调查单实例倾斜、token 预算、KV 资源及额外调度约束;指标提供线索,最终原因需要对应配置和请求记录。
running 越多越好吗?更多请求同时参与计算可能提高吞吐,也可能延长单请求输出间隔。应同时满足业务延迟目标,不能把 running 设成单独的优化终点。
集群 P95 能平均各实例 P95 吗?不能。应在桶边界一致的条件下聚合直方图桶后再求分位数;同时保留各实例视图。使用不同桶定义的版本混跑时,先解决口径兼容,再进行聚合比较。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
248 收藏
-
253 收藏
-
165 收藏
-
424 收藏
-
435 收藏
-
265 收藏
-
249 收藏
-
471 收藏
-
329 收藏
-
120 收藏
-
422 收藏
-
284 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习