
Gemini API 内置 URL Context 怎样处理网页资料
来源:17golang原创
时间:2026-11-03 07:09:47 204浏览 收藏
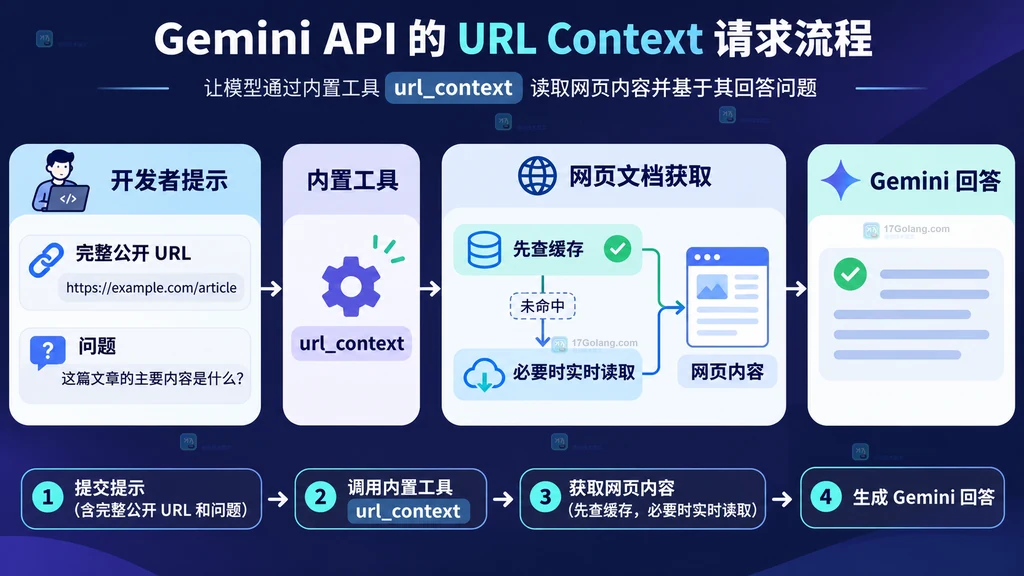
如果问题依赖某个网页、文档或 PDF,单把 URL 粘进普通提示词并不等于模型一定读取了它。Gemini API 的内置 URL Context 用来把指定地址作为上下文交给模型:请求中开启 url_context,再在问题里写入完整的公开 URL,Gemini 会尝试读取页面并基于返回内容回答。
官方地址:https://ai.google.dev/gemini-api/docs/url-context
这篇只解决一个问题:怎样把网页资料交给 URL Context,以及如何判断它拿到了什么、哪些地址不能用。它不把 URL Context 当成通用搜索引擎,也不把模型回答当成网页内容的原样转录。
URL Context 解决的是什么问题
URL Context 适合“我已经知道要看哪几页”的任务,例如比较两份公开文档、从产品说明页提取字段、根据 API 文档解释一个参数,或把多页资料合并成一份摘要。它和 Google Search 的分工不同:搜索更适合先发现网页,URL Context 更适合深读请求中明确给出的地址。
它属于 Gemini API 管理的内置工具。应用只需在一次请求中声明工具并写出问题,工具的读取过程由服务端完成,应用不需要自己先下载网页再拼进提示词。
请求中怎样启用 url_context
下面用 REST 展示最小结构。关键点有两个:工具列表中出现 {"type":"url_context"},问题中使用带协议的完整 URL。示例中的地址是公开文档地址,实际项目应换成自己的公开资料页。
# 用完整 URL 让内置工具读取指定文档,再让模型提炼两个实践要点
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "阅读 https://ai.google.dev/gemini-api/docs/url-context,列出 URL Context 的两个使用边界。",
    "tools": [{"type": "url_context"}]
  }'
不要省略 https://,也不要只写域名。提示词最好明确“从哪些地址提取什么”,这样回答目标和 URL 内容之间的关系更清楚。
用 Python 读取回答和来源信息
如果需要在应用里展示来源,不能只打印最终文本。官方示例中的响应会包含模型输出文本及其标注;URL Context 还会给出每个地址的检索结果元数据。下面保留最重要的分支,避免把元数据当成正文拼接。
from google import genai

# 客户端从环境变量读取 GEMINI_API_KEY;不要把密钥写进代码或文章配置。
client = genai.Client()

result = client.interactions.create(
    model="gemini-3.8-flash",
    input=(
        "阅读 https://ai.google.dev/gemini-api/docs/url-context,"
        "用三句话说明它的输入限制,并保留来源引用。"
    ),
    tools=[{"type": "url_context"}],
)

for step in result.steps:
    # 只展示模型文本;引用标注应交给应用的来源组件处理。
    if step.type == "model_output":
        for block in step.content:
            if block.type == "text":
                print(block.text)
                for annotation in block.annotations or []:
                    # url_citation 连接回答片段和实际来源地址。
                    if annotation.type == "url_citation":
                        print("来源:", annotation.url)
    elif step.type == "url_context_result":
        # 检索状态用于区分成功、不可访问或安全检查未通过。
        print("检索元数据:", step)
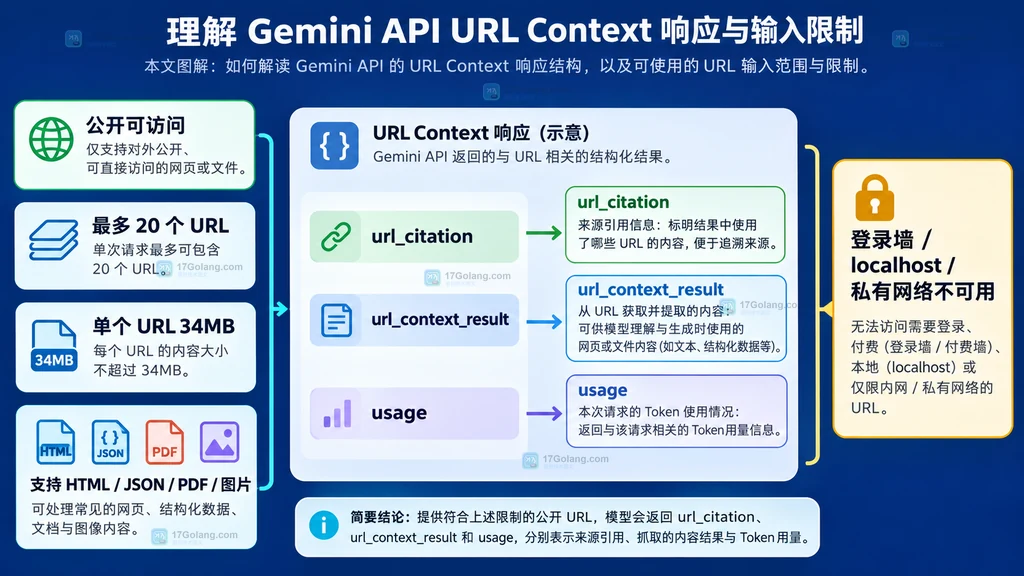
不同 SDK 版本的对象字段可能略有差异,集成时以当前 SDK 类型定义为准。这里最值得保留的逻辑是:文本负责回答,url_citation 负责把回答片段连回来源,url_context_result 负责解释一次 URL 读取尝试的状态。
如何理解“它处理了网页资料”
URL Context 的读取大致可以分成三段:
- 输入:请求提供一个或多个完整 URL,并在问题中定义提取、比较或总结任务。
- 检索:服务先尝试使用内部索引缓存;如果地址不在索引中,例如刚发布的新页面,再回退到实时读取。
- 回答:模型把获取到的内容作为上下文生成回答,并在文本中附带 URL 引用;响应还可以提供检索 URL 和状态。
因此,“请求成功”与“网页内容完整符合预期”不是同一个概念。应用应该保留引用和检索状态,让用户知道回答依据了哪个地址;对于重要资料,还应在业务侧决定是否需要人工复核原文。
哪些 URL 可以读取,哪些会失败
先用下面的表格筛选输入,能减少“模型没有读到页面”这种模糊问题。
| 检查项 | 可用方向 | 常见边界 |
|---|---|---|
| 可访问性 | 公开访问、无需登录或付费墙 | localhost、127.0.0.1、私有网络、隧道地址不支持 |
| 数量 | 一次请求最多提供 20 个 URL | 更多地址应拆分任务或先筛选 |
| 大小 | 单个 URL 的内容最多 34MB | 过大的文档不适合直接塞进一次请求 |
| 内容类型 | HTML、JSON、纯文本、XML、CSV、PDF 和常见图片 | YouTube 视频、音频和 Google Workspace 文件不在支持范围 |
地址完整且公开只是前提,不代表页面中的每个动态区域都一定会被提取。把任务限定为页面正文、表格字段或文档章节,并让应用记录检索状态,比笼统地要求“读懂这个网站”更容易得到稳定结果。
什么时候组合 Google Search
如果你只有一个主题,还不知道应该阅读哪些页面,可以同时启用 Google Search 和 URL Context:先让搜索发现相关页面,再让 URL Context 对选中的页面做更深入的读取。两者的职责仍然要分开:搜索负责扩大候选范围,URL Context 负责读取请求中明确的地址。
{
  "tools": [
    {"type": "google_search"},
    {"type": "url_context"}
  ]
}
上面是请求结构片段,不是可独立发送的完整 JSON。严格 JSON 不支持注释,所以字段含义放在代码块外说明:google_search 用于发现信息,url_context 用于读取指定页面;实际请求仍需补充模型、问题、认证头等字段。
常见问题
只把 URL 写进提示词,为什么还要声明工具?
URL 是输入内容,url_context 是允许模型调用的内置能力。没有工具声明时,模型可能只把 URL 当作普通文本,不应把“看起来像引用了地址”理解为已经读取网页。
URL Context 是不是搜索引擎?
不是。它主要读取请求提供的指定地址;需要从未知网页中发现资料时,再考虑组合 Google Search。
能不能读取公司内网地址?
不能把 localhost、私有网络或依赖登录的地址当成可用输入。需要分析私有资料时,应改用适合企业文档的授权数据接入或文件检索方案。
如何知道 URL 读取失败了?
同时看模型文本中的 URL 引用和响应里的 URL 检索元数据。状态显示错误、付费墙或不安全时,不要继续把回答当成该页面的可靠摘要。
小结
使用 Gemini API URL Context 的最短路径是:启用 url_context、提交带协议的公开 URL、提出明确任务,再从文本引用和检索元数据判断来源状态。它适合定向阅读和多页资料合并,不适合绕过登录、读取内网或代替完整网页抓取系统。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
486 收藏
-
322 收藏
-
250 收藏
-
167 收藏
-
392 收藏
-
科技周边 · 人工智能 | 1小时前 | 人工智能 · Transformers bitsandbytes 4-bit量化 BitsAndBytesConfig bnb_4bit_compute_dtype347 收藏
-
393 收藏
-
476 收藏
-
172 收藏
-
348 收藏
-
187 收藏
-
265 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习