
Transformers BitsAndBytesConfig 怎样设置 4-bit 计算类型
来源:17golang原创
时间:2026-11-03 07:22:06 347浏览 收藏
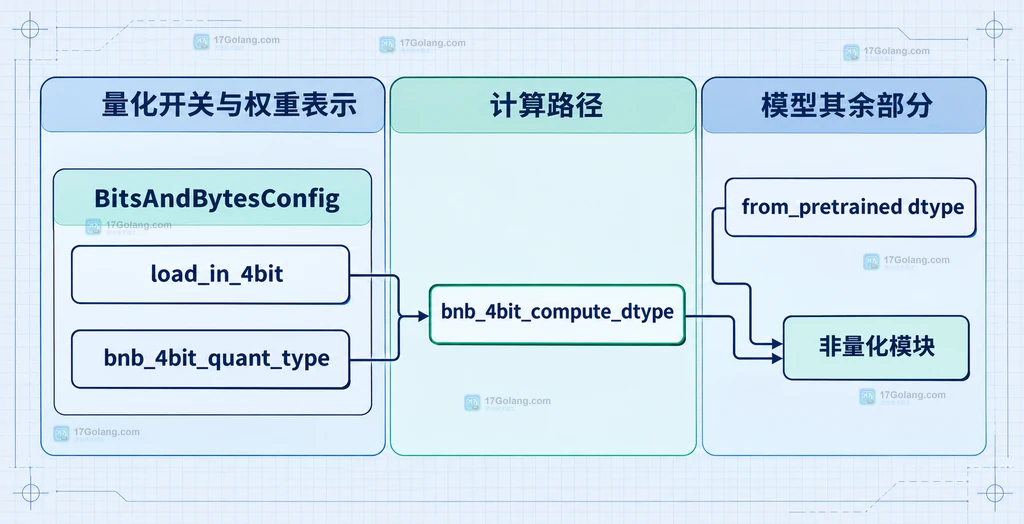
如果你只是想让 Transformers 用 4-bit 量化加载模型,最容易混淆的是三个类型参数:bnb_4bit_quant_type 决定量化权重使用 FP4 还是 NF4,bnb_4bit_compute_dtype 决定计算时使用什么类型,而 from_pretrained() 的 dtype 更多是控制没有被 4-bit 替换的其它模块。它们不是同一个开关。
官方文档:https://huggingface.co/docs/transformers/en/quantization/bitsandbytes
常用的 4-bit 推理起点是 load_in_4bit=True,再根据硬件把计算类型设为 torch.bfloat16 或保守地保留 torch.float32。下面按配置边界、加载入口和排查顺序拆开说明。
三个配置项不要混为一谈
BitsAndBytesConfig 里至少有三组概念需要分开看:
| 配置 | 它控制什么 | 常见选择 |
|---|---|---|
load_in_4bit | 是否启用 4-bit 量化路径 | True |
bnb_4bit_quant_type | 4-bit 量化线性层使用的权重表示 | "fp4" 或 "nf4" |
bnb_4bit_compute_dtype | 量化层参与计算时使用的计算类型 | torch.float32 或 torch.bfloat16 |
dtype | 没有被量化替换的其它模块采用的类型 | "auto" 或明确的 PyTorch dtype |
官方配置说明中,bnb_4bit_compute_dtype 默认是 torch.float32,但它可以和输入类型不同。例如输入仍是 fp32,计算可以改为 bf16。这个参数改变的是计算路径,不等于把权重存储格式改成 bf16。
先用最小配置打开 4-bit
如果目标是先确认配置结构,建议从下面这段开始。示例把计算类型明确写出来,便于后续排查,而不是把所有量化参数一次性堆进去。
import torch
from transformers import BitsAndBytesConfig

# 打开 4-bit 量化;计算类型按硬件能力选择,bf16 不支持时可改回 float32
quantization_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# 需要更保守的兼容性时,使用默认计算类型或显式指定 float32
safe_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.float32,
)
这两份配置的核心区别只有计算类型。bfloat16 是否适合,取决于运行设备、驱动和 PyTorch 对应后端的支持;如果设备不支持,直接把参数改成 bf16 并不能凭空获得加速。
NF4 和计算类型分别怎么选
bnb_4bit_quant_type 影响的是 4-bit 权重表示,官方文档列出的选择包括 fp4 和 nf4。NF4 是为正态分布初始化的权重设计的 4-bit 类型,常见于 QLoRA 场景;它和 bnb_4bit_compute_dtype 是两个独立参数。
import torch
from transformers import BitsAndBytesConfig

# 用 NF4 表示 4-bit 权重,同时让计算使用 bf16
# 这里不包含训练代码,重点是区分 quant_type 和 compute_dtype
nf4_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# 若要复现更保守的默认路径,只替换计算类型即可
fp4_float_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="fp4",
    bnb_4bit_compute_dtype=torch.float32,
)
不要把“NF4 更适合某类权重”理解为“NF4 就等于 bf16”。前者是量化表示,后者是计算类型;一份配置可以是 NF4 + bf16,也可以是 FP4 + float32。
把配置交给 from_pretrained
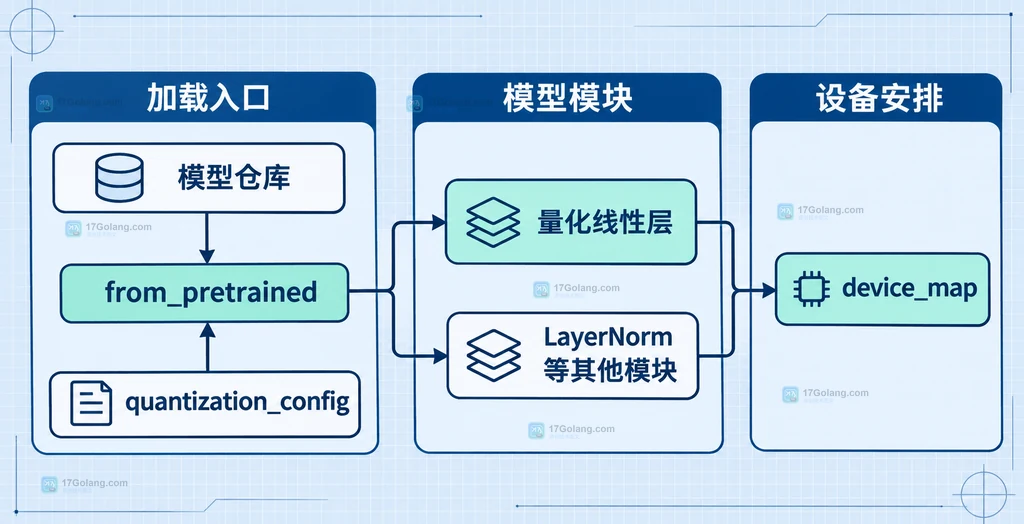
量化配置要通过 quantization_config 传给模型加载入口。对于推理场景,文档示例常用 device_map="auto" 让模型在可用设备间安排;训练时不要机械照搬这个选项,应根据训练框架和设备布局单独决定。
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

model_id = "your-org/your-model"

# 量化层使用 NF4 权重表示,并用 bf16 做计算
quantization_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

# dtype="auto" 让未被量化替换的模块读取模型配置中的 dtype
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quantization_config,
    dtype="auto",
    device_map="auto",  # 这里只讨论推理加载;训练时按训练框架安排设备
)

# 用官方提供的接口查看模型的内存占用信息
print(model.get_memory_footprint())
这里的重点是参数分工:quantization_config 决定量化路径,dtype="auto" 处理模型配置中定义的其它模块类型,device_map 处理设备安排。不要用一个参数去代替另两个参数。
出现显存或速度问题时先查哪一项
可以按下面的顺序判断,避免同时改动多个变量:
- 显存仍然偏高:先确认是否真的打开了
load_in_4bit=True,再看模型是不是还包含较大的未量化模块。 - 速度没有提升:检查计算类型和硬件后端是否匹配。
bfloat16不是所有设备都能有效执行;必要时先回到float32,保证路径清晰。 - 结果与预期不同:区分是权重表示改变,还是计算 dtype 改变,不要只修改
bnb_4bit_quant_type就下结论。 - 加载阶段报参数错误:检查 Transformers、bitsandbytes 和 Accelerate 的组合是否满足当前文档的调用方式,并确认传参名称没有写成旧接口。
官方文档还提供了 get_memory_footprint() 用于查看模型内存信息。它适合帮助定位配置是否达到预期,但不能替代针对真实输入长度和并发量的完整压测。
一张表记住选择边界
| 目标 | 优先关注 | 不要误解 |
|---|---|---|
| 打开 4-bit | load_in_4bit=True | 只设置 dtype 不会自动打开 4-bit |
| 选择权重表示 | bnb_4bit_quant_type | NF4/FP4 不是计算 dtype |
| 调整计算路径 | bnb_4bit_compute_dtype | bf16 是否有效取决于设备支持 |
| 处理其他模块 | from_pretrained(dtype="auto") | 它不等于量化层的计算类型 |
| 安排推理设备 | device_map | 推理示例不能直接当作训练布局 |
最终可以把配置收敛成一句话:先用 load_in_4bit=True 打开路径,再单独选择权重表示和计算类型,最后用 dtype 与设备映射处理模型加载的其它边界。这样遇到问题时,每次只改一个维度,定位会比反复更换模型更快。
常见追问
bnb_4bit_compute_dtype 不写时是什么?
官方配置定义的默认值是 torch.float32。如果你需要使用 bf16,应显式写入并确认运行设备能够支持对应计算。
NF4 和 bfloat16 能同时使用吗?
可以,它们分别描述权重的 4-bit 表示和计算类型,正是常见的组合方式之一。
dtype="auto" 会把所有模块都变成 4-bit 吗?
不会。它主要让未被量化替换的模块采用模型配置中定义的 dtype,4-bit 路径仍由 quantization_config 控制。
device_map="auto" 适合训练吗?
不要直接照搬。官方示例将它用于推理场景,训练时应按训练框架、显卡布局和优化器需求安排设备。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
486 收藏
-
322 收藏
-
250 收藏
-
167 收藏
-
392 收藏
-
393 收藏
-
476 收藏
-
172 收藏
-
348 收藏
-
204 收藏
-
187 收藏
-
265 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习