
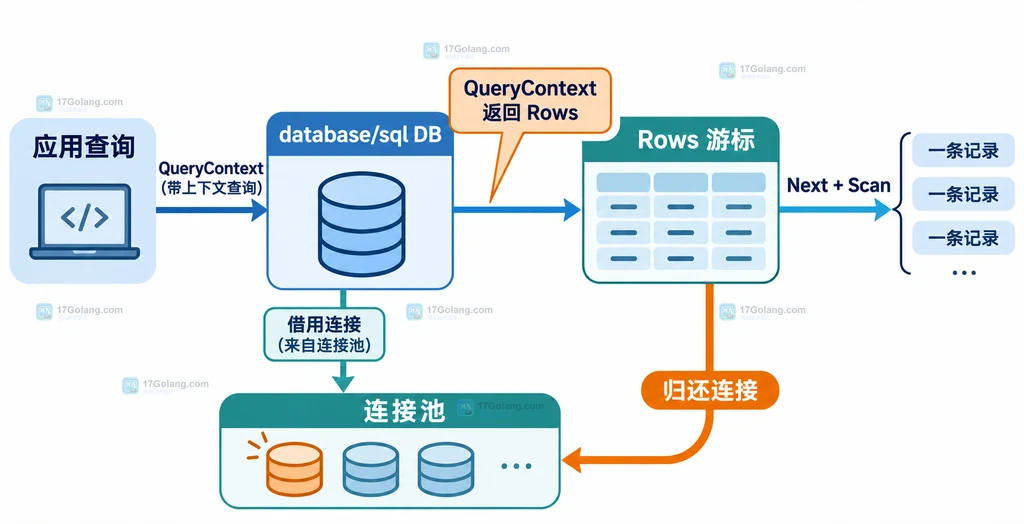
用 Go 读取数据库查询结果时,database/sql 不会把全部记录一次性变成切片。QueryContext 返回一个 *sql.Rows,调用方需要通过 Next 移动到下一行,再用 Scan 把当前行写入变量。
可靠的写法是:查询成功后立刻安排Rows.Close,循环里只在Next返回 true 时调用Scan,循环结束再检查Rows.Err。这样既能处理逐行读取,也能覆盖提前返回和迭代失败,避免结果集长期占用连接池资源。
官方资料:https://pkg.go.dev/database/sql
先分清 DB、Rows 和连接池的职责
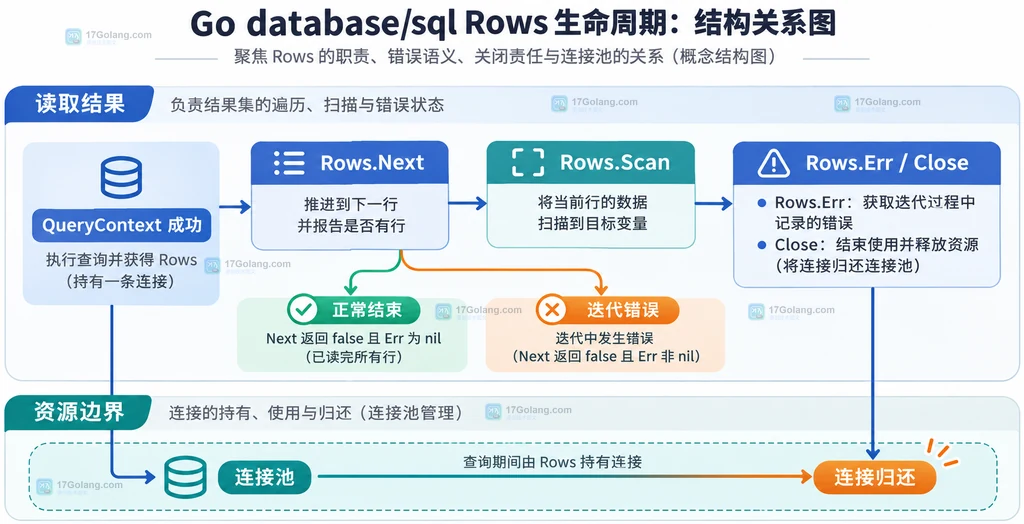
*sql.DB 是可长期共享的数据库句柄,内部负责管理连接池;它不是某一条固定连接。执行查询后得到的 *sql.Rows 则代表本次结果集的读取状态,调用方必须负责把它读完或关闭。
因此,代码里最重要的生命周期边界不是“函数最后有没有 return”,而是“拿到 Rows 后是否有一条必达的 Close 路径”。自然读完时 Rows 会自动关闭,但显式安排 Close 仍然能覆盖扫描失败、业务筛选后提前返回等分支。
用 Next 和 Scan 逐行读取
每次调用 Next,Rows 都会准备一行数据;只有返回 true 时,下一步的 Scan 才有当前行可读。Scan 的目标参数数量和类型要能接住查询列,否则应立即返回错误。
package data

import (
	"context"
	"database/sql"
)

type User struct {
	ID   int64
	Name string
}

func readUsers(ctx context.Context, db *sql.DB) ([]User, error) {
	// 使用请求上下文,让取消或超时可以传递给数据库查询。
	rows, err := db.QueryContext(ctx, `SELECT id, name FROM users ORDER BY id`)
	if err != nil {
		return nil, err
	}
	// 任何提前 return 的分支都要关闭结果集,释放它持有的资源。
	defer rows.Close()

	users := make([]User, 0, 16)
	for rows.Next() {
		var user User
		// Scan 只读取 Next 已定位的当前行,失败时停止继续消费。
		if err := rows.Scan(&user.ID, &user.Name); err != nil {
			return nil, err
		}
		users = append(users, user)
	}
	// Next=false 可能是正常读完,也可能是迭代期间发生了错误。
	if err := rows.Err(); err != nil {
		return nil, err
	}
	return users, nil
}
这里的容量预估只是示例,不代表查询结果一定只有 16 行。真正需要记住的是调用顺序:先判断查询错误,再安排关闭;循环里先 Next 后 Scan;循环外再看 Err。
用 Close 覆盖提前退出路径
有些业务并不需要把全部结果读完,例如找到首个匹配项后就返回,或者发现一行数据不符合转换规则时立即终止。此时循环不会自然走到结果集末尾,defer rows.Close() 就是兜底路径。
Close 可以重复调用;自然结束后再执行一次延迟关闭不会因为重复关闭而破坏已经记录的 Rows.Err。如果应用特别关心多语句查询或驱动在关闭阶段报告的错误,可以把关闭错误合并到返回值,而不是无条件覆盖更早发生的扫描错误。
func findFirstUser(ctx context.Context, db *sql.DB, prefix string) (user User, err error) {
	// 查询参数通过占位符传入,避免把输入拼接进 SQL 文本。
	rows, err := db.QueryContext(ctx,
		`SELECT id, name FROM users WHERE name LIKE ? ORDER BY id`, prefix+"%")
	if err != nil {
		return User{}, err
	}
	// 即使找到第一行就返回,也要执行 Close。
	defer func() {
		if closeErr := rows.Close(); err == nil && closeErr != nil {
			err = closeErr
		}
	}()

	if rows.Next() {
		// 只取第一行后提前结束,Close 负责释放未消费完的结果集。
		if scanErr := rows.Scan(&user.ID, &user.Name); scanErr != nil {
			return User{}, scanErr
		}
		return user, nil
	}
	// 没有行不等于一定没有错误,先检查迭代状态。
	if err := rows.Err(); err != nil {
		return User{}, err
	}
	return User{}, sql.ErrNoRows
}
在循环后检查 Err
Next 返回 false 时,可能只是已经没有下一行,也可能是驱动读取网络数据、解码结果或推进结果集时出现错误。只看循环是否结束,会把后者误判成成功。
所以 rows.Err() 必须放在循环之后。它可以在显式或隐式 Close 后调用;如果返回非 nil,就把这个错误交给上层。对于多个结果集,还要根据驱动能力使用 NextResultSet,进入下一个结果集后仍然要先调用 Next 再 Scan。
把生命周期规则收进可复用函数
业务层最好只接收“结果列表 + error”,不要让每个调用方重新编写 Next、Scan、Close 和 Err 的组合。封装函数时,可以把字段映射、最大读取数量和上下文作为明确参数,把资源释放责任留在函数内部。
| 位置 | 应做什么 | 常见误区 |
|---|---|---|
| QueryContext 成功后 | 立即安排 Rows.Close | 等业务判断后再决定是否关闭 |
| 读取当前行 | 先 Next,再 Scan | 没有 Next 就直接 Scan |
| Scan 返回错误 | 停止读取并返回 | 忽略错误继续追加半成品 |
| 循环结束后 | 检查 Rows.Err | 把 Next=false 一律当成成功 |
| 提前返回或只取一行 | 依赖 defer Close 兜底 | 认为 return 会自动归还结果集资源 |
常见问题
Rows 读完后还需要 Close 吗?
正常读完时 Next 在没有更多结果集时会自动关闭 Rows,但仍建议在查询成功后立即安排显式 Close,以覆盖提前返回和异常分支。
为什么不能只判断 rows.Next()?
因为 false 同时表示“没有下一行”和“准备下一行时发生错误”。循环后调用 rows.Err() 才能区分两种情况。
Rows.Close 会关闭整个数据库连接吗?
它关闭的是当前结果集并释放本次读取占用的资源;*sql.DB 仍然是可复用的连接池句柄,不应把每次读取都理解成关闭数据库。
总结:把 *sql.Rows 当成需要明确管理的读取生命周期:查询成功后安排 Close,循环内用 Next 和 Scan 逐行处理,循环后检查 Err。这套顺序能同时覆盖正常结束、提前退出、扫描失败和驱动迭代错误,让连接池资源按预期归还。




