
OpenTelemetry Collector batch processor 怎样控制 flush 频率
来源:17golang原创
时间:2026-11-14 05:06:47 268浏览 收藏
OpenTelemetry Collector 的 batch processor 不是“每隔固定时间整批发送”的单一时钟。一个批次会在达到数量触发条件或等待时间到达时 flush;如果配置了 send_batch_max_size,过大的批次还会被拆分。官方地址:https://opentelemetry.io/docs/collector/
想控制 flush 频率,先调timeout控制最长等待,再用send_batch_size控制高流量下的提前发送;需要限制单次请求大小时,必须额外设置send_batch_max_size。低延迟场景缩短 timeout,吞吐优先场景增大它,但不要脱离 memory_limiter 和 exporter 队列单独调参。
timeout是时间触发,不是固定的全局 flush 节拍;send_batch_size是达到数量后的发送触发器。send_batch_size不等于发送上限,真正的硬上限是send_batch_max_size,且它不能小于触发值。memory_limiter应放在批处理前面;使用metadata_keys时,每个元数据组合都可能持有一份待发送批次。
先看懂 batch processor 的三个尺寸和一个时间
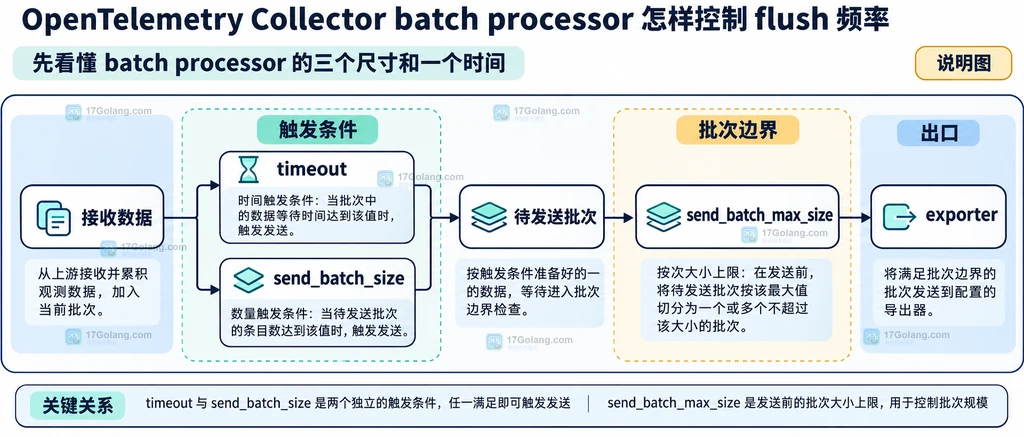
当前 Collector 的 batch processor 默认以数据项计数:span、metric data point 或 log record。官方文档给出的默认值是 timeout: 200ms、send_batch_size: 8192,send_batch_max_size 默认不设上限。
timeout 表示批次无论大小如何,最多等待多长时间;send_batch_size 达到后会提前触发发送,但它只负责“触发”,不会限制最终批次的大小。需要限制下游请求尺寸时,再设置 send_batch_max_size,并保证它大于或等于 send_batch_size。
processors:
  batch:
    # 低流量时最多等待 2 秒,避免小批次一直滞留。
    timeout: 2s
    # 高流量时达到 2000 个数据项就提前 flush。
    send_batch_size: 2000
    # 限制下游单次接收的最大数据项数量,过大批次会被拆分。
    send_batch_max_size: 5000
因此,flush 频率不是简单的“每 2 秒一次”:低流量更接近时间触发,高流量更可能由数量触发。调参时要先明确自己要控制的是等待延迟、发送频率,还是单次请求大小。
按延迟目标选择 flush 频率
如果链路更在意实时性,先从业务可接受的端到端延迟倒推 timeout。例如日志告警希望尽快到达后端,可以使用较短的时间窗口,再配合中等的 send_batch_size;如果是高吞吐指标汇聚,适当增大窗口可以减少请求次数和压缩开销。
| 场景 | 参数思路 | 主要代价 |
|---|---|---|
| 交互式链路、告警日志 | 较短 timeout;数量触发不要过大 | 请求次数增加,压缩收益下降 |
| 常规服务遥测 | 以默认值为起点,再看出口延迟与内存 | 需要结合后端限流调整 |
| 网关高吞吐汇聚 | 更大的 batch 和 timeout,设置明确 max_size | 等待时间和内存占用上升 |
不要把 send_batch_size 当作“每次刚好发送多少条”。官方说明它是触发器,不改变批次大小;如果同时存在多个接收来源或下游组件,实际请求边界还会受数据到达节奏和拆分逻辑影响。
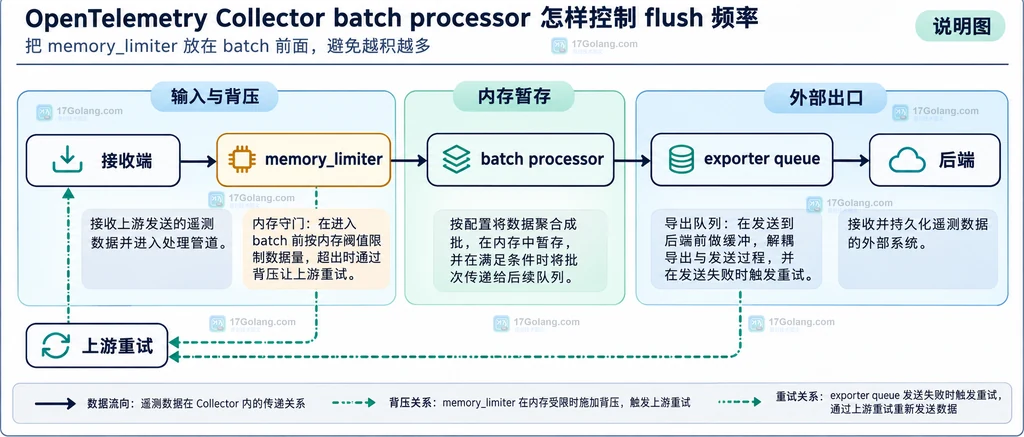
把 memory_limiter 放在 batch 前面,避免越积越多
批处理本身会在 Collector 内存中保留待发送数据,出口变慢时,等待中的批次和 exporter 队列会叠加。官方建议把 memory_limiter 作为 pipeline 的第一个 processor,让它有机会在下游处理器继续累积数据前施加背压。
processors:
  memory_limiter:
    # 每秒检查一次内存,先挡住持续增长的输入。
    check_interval: 1s
    # 容器环境可按 cgroup 总内存计算 Collector 堆上限。
    limit_percentage: 80
    # 为突发流量预留硬限制与软限制之间的缓冲。
    spike_limit_percentage: 15
  batch:
    # 这里的时间窗口服务于出口吞吐,不替代内存保护。
    timeout: 1s
    send_batch_size: 4096

service:
  pipelines:
    traces:
      receivers: [otlp]
      # 先限内存,再批处理;顺序会影响背压能否传回接收端。
      processors: [memory_limiter, batch]
      exporters: [otlp]
超过软限制后,memory limiter 会拒绝新的接收请求并期待上游重试;超过硬限制时还会尝试触发 GC。它不能替代合理的 batch、队列和实例容量规划,尤其要确认前置 receiver 能正确处理可重试错误,否则背压可能演变成数据丢失。
metadata 分片和双重 batching 是常见误区
启用 metadata_keys 后,Collector 会按不同元数据组合创建独立 batcher。每个 batcher 都可能持有待发送数据,所以租户、授权信息或路由标签的基数越高,批处理占用的内存越难用单一 send_batch_size 估算。需要按业务控制 metadata_cardinality_limit,并观察对应的元数据基数指标。
另一个误区是同时在 pipeline 中使用 batch processor,又在 exporter 的 sending queue 中开启 batching。当前官方迁移方向是让 exporter 在队列之后完成批处理:这样队列容量、消费者并发、重试和 batching 可以一起管理。短期保留 processor 时,应明确每一层的职责,避免无意中增加等待时间。
新配置应为 exporter-level batching 留出迁移空间
OpenTelemetry 官方在 2026 年 11 月公布了 batch processor 的弃用路线:exporter-level batching 将逐步成为默认方向,queue_batch 用于需要在 processor 层继续批处理的场景;核心仓库和发行版计划在 v0.177.0(计划于 2027 年 5 月)移除原 batch processor。现有配置可以继续围绕 timeout 和数量参数运行,但新项目不宜把所有可靠性、排队和批处理语义都绑定在旧 processor 上。
迁移时可先把当前 batch 参数记录成延迟、请求大小、队列积压和内存的基线,再在 exporter 的 sending_queue.batch 中对应设置 flush_timeout、min_size 和 max_size。这不是把参数名机械替换:exporter batching 的 sizer 可以按 requests、items 或 bytes 计量,语义和原 processor 的数据项计数不同。
常见问题
把 timeout 改成 0 是不是关闭批处理?
对 batch processor 而言,timeout: 0s 会让数据立即发送,并忽略 send_batch_size 的触发作用,但仍受 send_batch_max_size 的拆分规则影响;它不是一个适合所有链路的“关闭开关”。
为什么 send_batch_size 设为 1000,实际请求仍然更大?
因为它只是达到数量后的发送触发器,不是上限。要约束单次批次,需要设置不小于它的 send_batch_max_size。
只调 batch processor 能解决出口堆积吗?
不能。出口堆积还涉及 exporter sending queue、消费者并发、重试时长、后端限流以及 Collector 总内存。应把这些因素和 batch 参数一起看。
-
214 收藏
-
143 收藏
-
147 收藏
-
228 收藏
-
500 收藏
-
科技周边 · 业界新闻 | 28分钟前 | 云原生 · kubernetes · Kubernetes NameSpace Requests limits ResourceQuota LimitRange471 收藏
-
482 收藏
-
302 收藏
-
217 收藏
-
446 收藏
-
401 收藏
-
296 收藏
-
491 收藏
-
295 收藏
-
267 收藏
-
247 收藏
-
352 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习