
Go教程技术文章
-
 Go archive/zip 读取中文文件名时,应先查看 ZIP 的 UTF-8 标志位与 File.NonUTF8,再决定是否做 GBK 或 GB18030 转码。本文给出默认读取、来源确认、显式解码和路径安全检查的完整边界。363 收藏
-
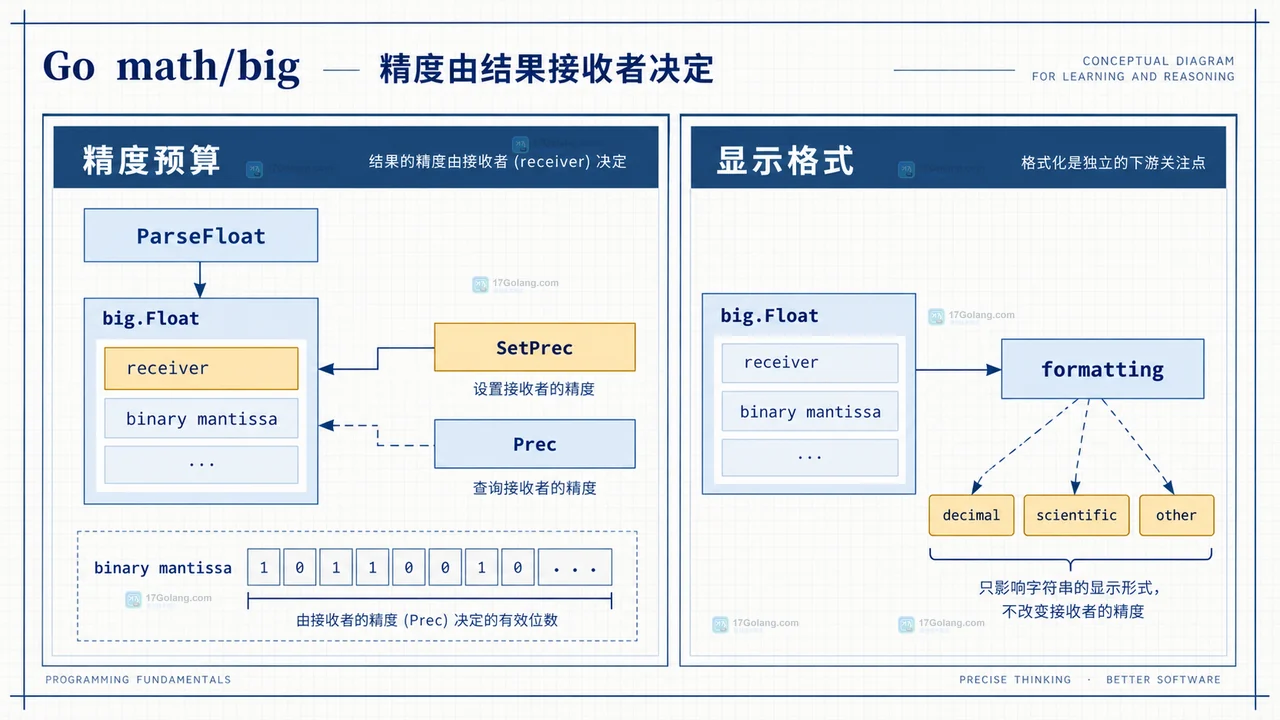 Go math/big 的精度控制关键在于 big.Float 的尾数位数、舍入模式和 Accuracy 状态。本文说明如何用 SetPrec、SetMode 和 Acc 设定并检查精度,并比较 big.Int、big.Rat 与 big.Float 的适用边界。363 收藏
-
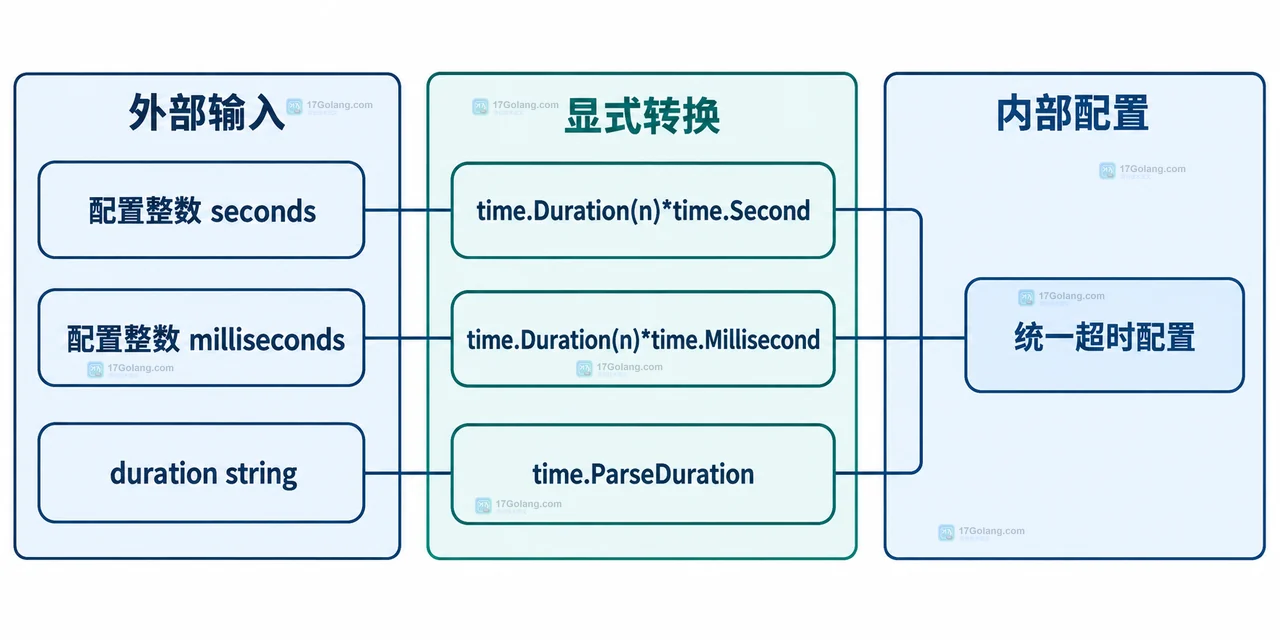 Go 的 time.Duration 底层是纳秒计数,裸整数不会自动变成秒。本文用超时、重试和配置解析示例,说明如何显式绑定单位并避开截断与溢出。362 收藏
-
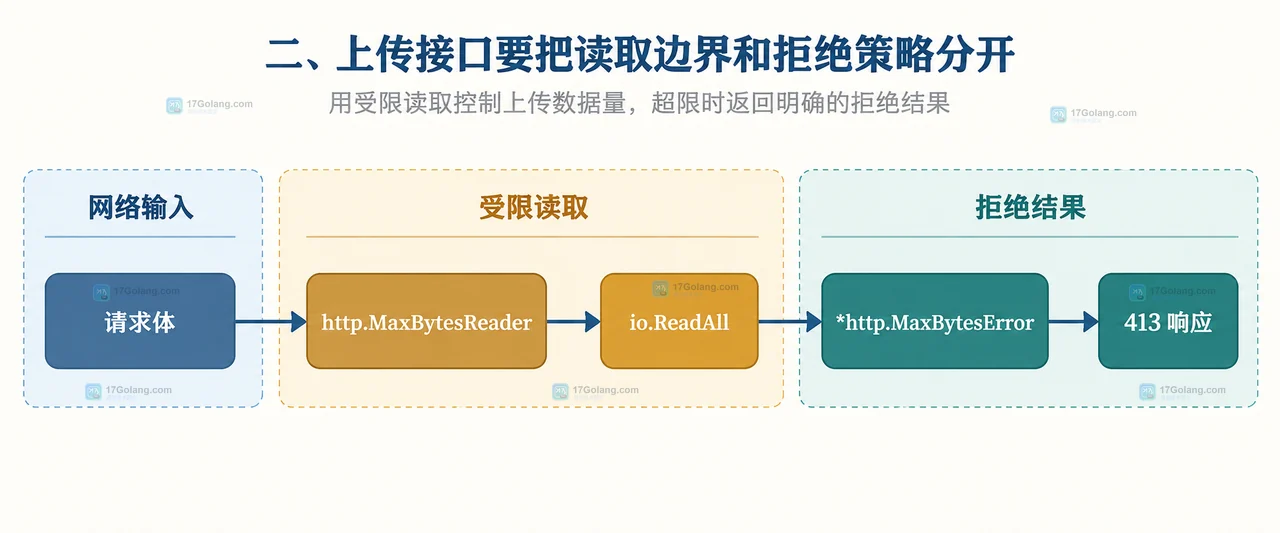 讲清 Go io.LimitReader 的字节上限与 EOF 语义,并用 http.MaxBytesReader 实现可识别超限错误的上传接口。362 收藏
-
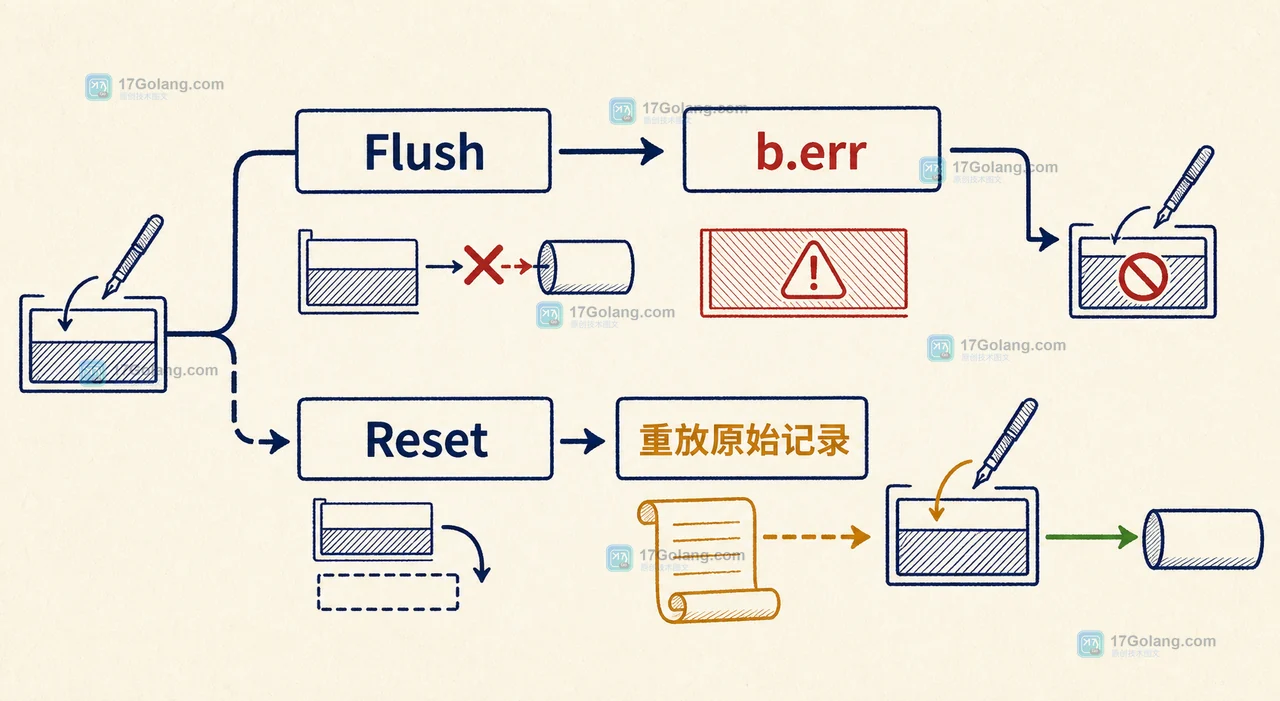 bufio.Writer.Flush 遇到底层 Writer 短写时,会把未写完的数据留在缓冲区并记住错误。本文用可控的 io.Writer 演示状态变化、错误传播和安全恢复边界。361 收藏
-
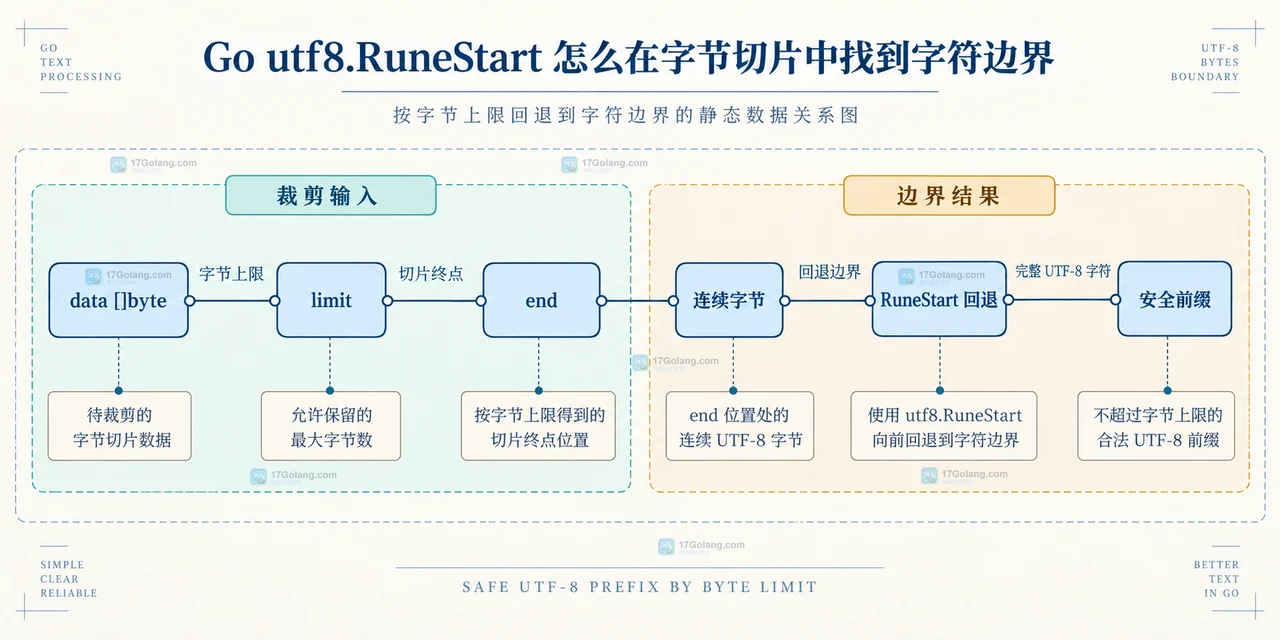 Go 按字节限制输出长度时,使用 utf8.RuneStart 找到 UTF-8 字符边界,并结合 utf8.Valid 与 DecodeRune 处理非法或不完整编码。361 收藏
-
 filepath.WalkDir 不会跟随符号链接进入目标目录,因为它按链接目录项本身判断 IsDir。本文用一个小型扫描器解释 DirEntry、Type、Info 与 EvalSymlinks 的边界。361 收藏
-
 Go 反射中 reflect.Value.CanSet 返回 false 时,先用 CanAddr 区分不可寻址的值副本,再用 CanInterface 和字段导出状态识别只读字段;本文给出指针、Elem、字段诊断和安全修复示例。361 收藏
-
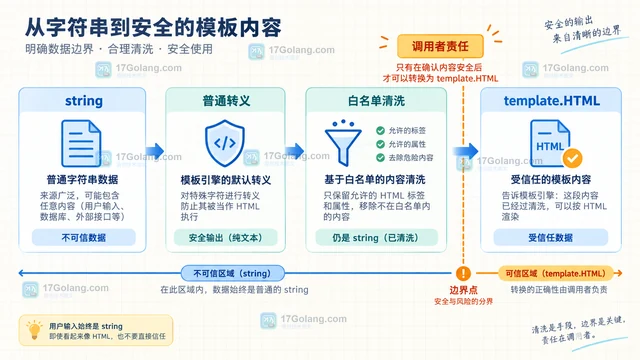 围绕 Go html/template 的上下文转义实践,说明 HTML 正文、属性、URI 和 JavaScript 数据位置的差异,并梳理 template.HTML 等安全类型的使用边界。361 收藏
-
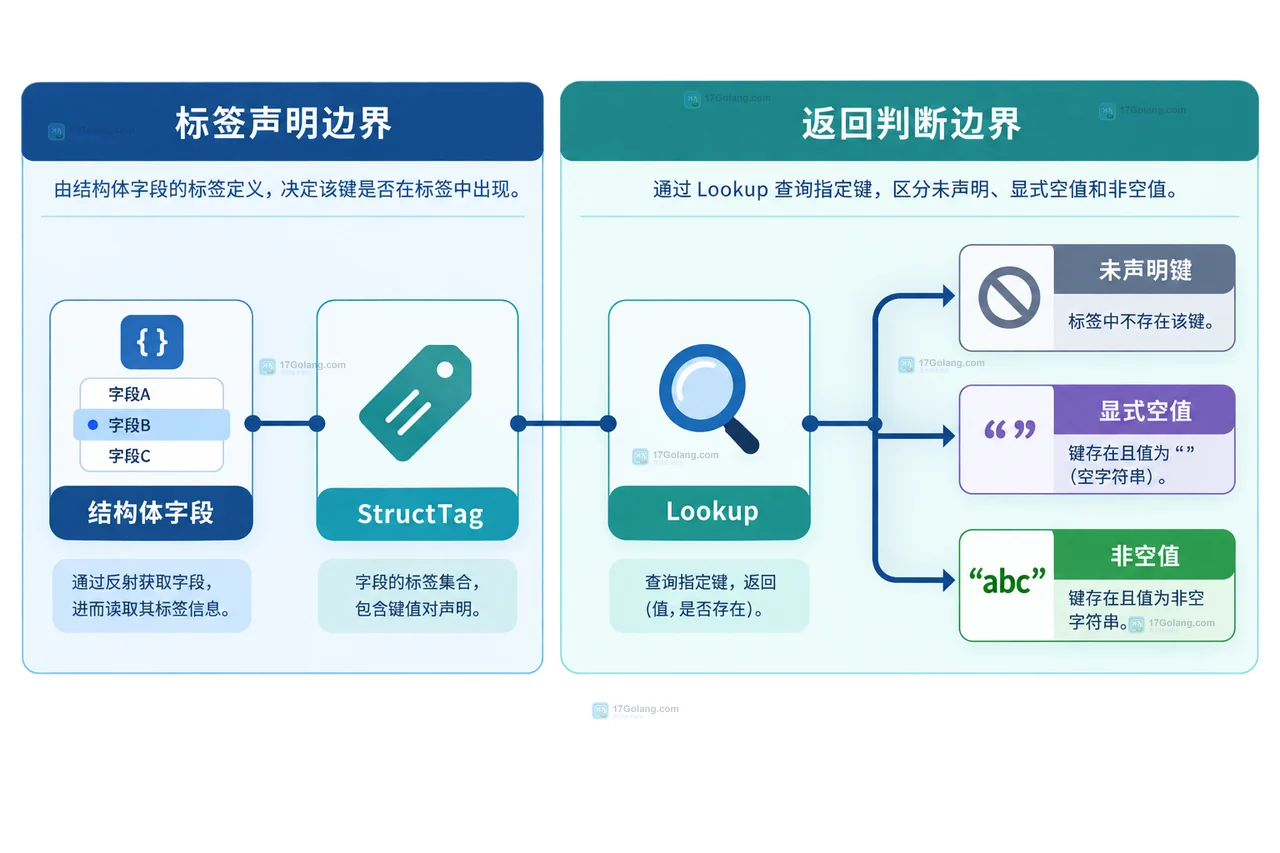 Go 反射读取结构体 json 标签时,Get 无法区分未声明与显式空值。本文用 StructTag.Lookup 解释 value 和 ok 的三态判断,并说明格式异常应如何配合 go vet 排查。360 收藏
-
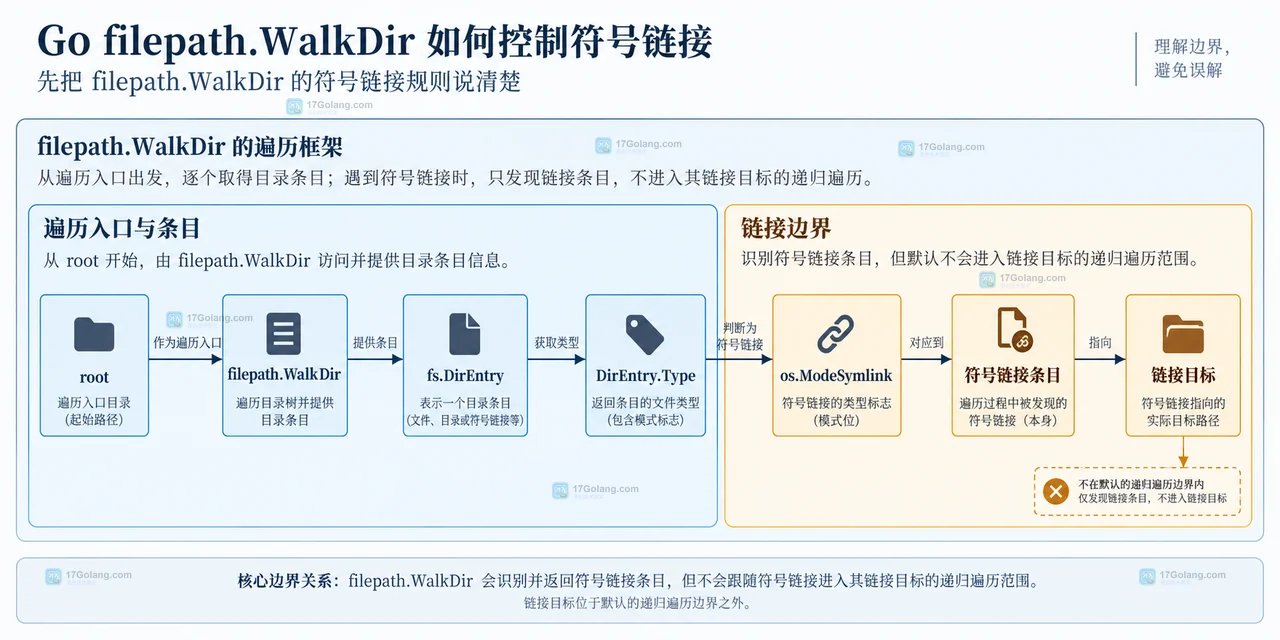 filepath.WalkDir 会发现符号链接,但默认不会沿着链接目标递归。本文用 DirEntry 判断链接类型,并说明需要跟随时如何解析目标、限制范围和避免循环扫描。359 收藏
-
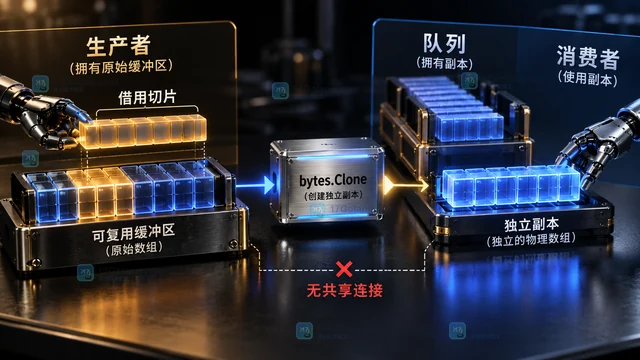 当 []byte 来自读取缓冲区、sync.Pool 或短生命周期回调时,直接保存会继续共享底层数组。本文说明如何在队列、goroutine 和缓存边界使用 bytes.Clone 获得独立副本,并处理 nil、空切片与复制成本。359 收藏
-
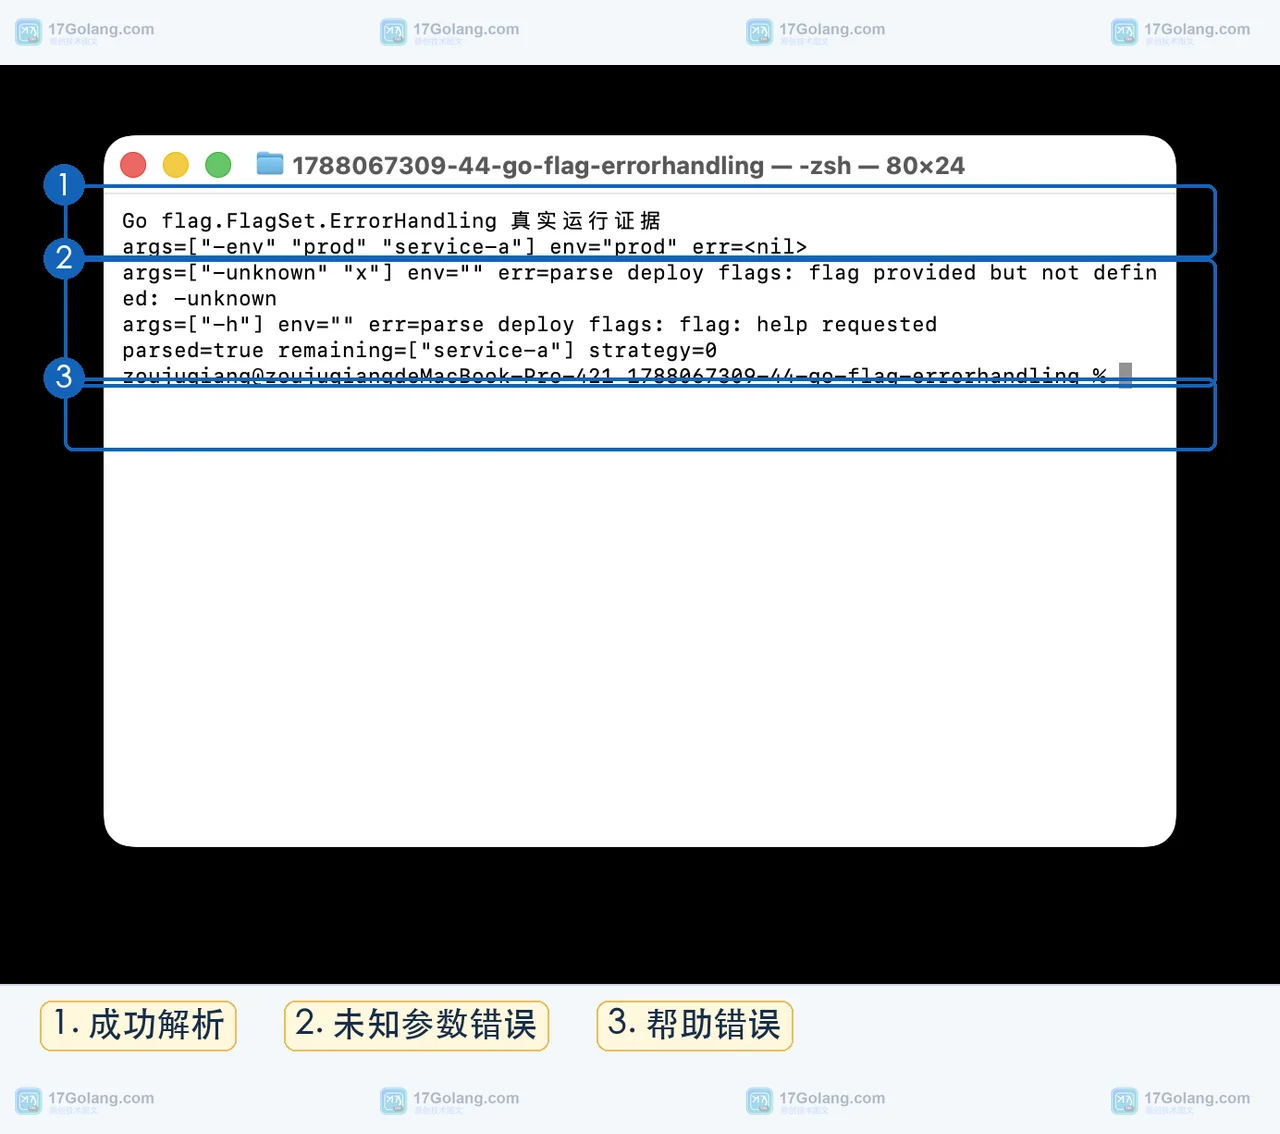 用独立 FlagSet 对比 ContinueOnError、ExitOnError 与 PanicOnError,演示如何让命令行错误可测试、可记录并保留稳定输出。358 收藏
-
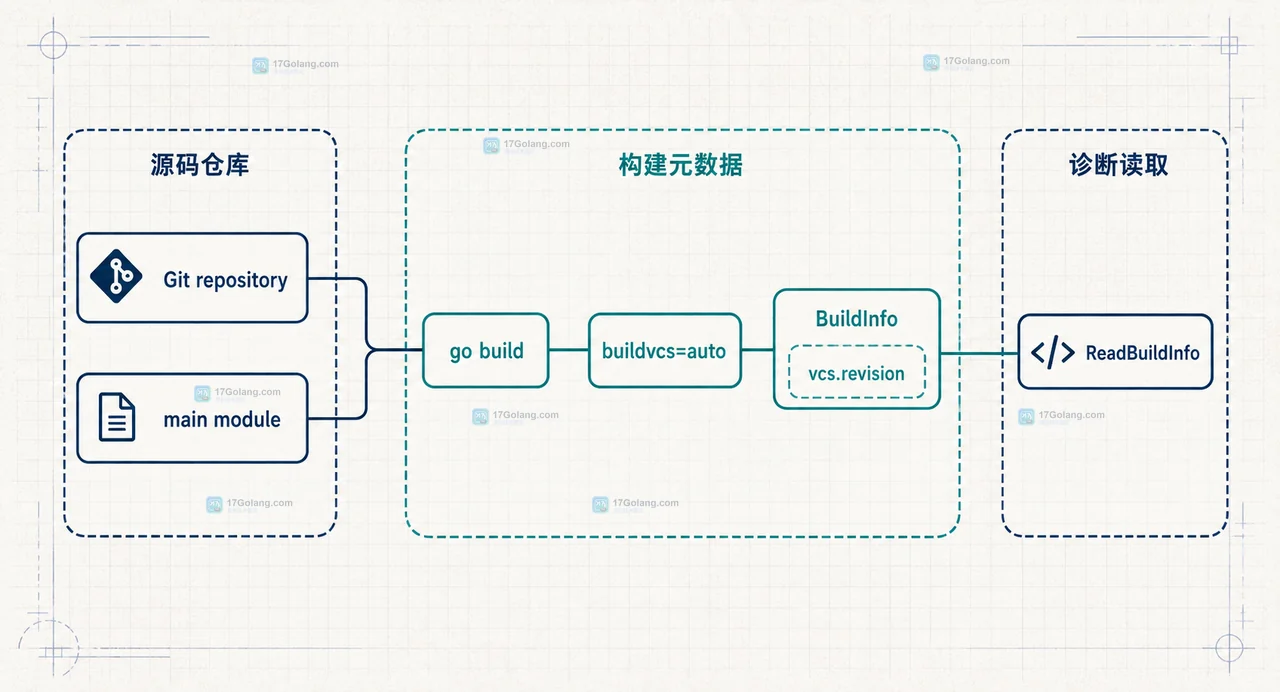 用 Go 的 go build -ldflags -X 在编译时注入版本号、Git 提交号和构建时间,并说明 buildvcs 元数据的读取边界。358 收藏
-
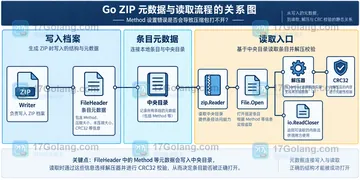 Go archive/zip 中 FileHeader.Method 不是任意压缩等级。本文解释 Store、Deflate、ErrAlgorithm、CreateHeader 与 CreateRaw 的边界,并给出写入错误、Close 收尾和读回校验的排查方法。358 收藏