登录
推荐 文章 Go 技术 课程 下载 专题 AI
首页 >  AI模型评测  >  C-Eval
C-Eval中文评测基准:大语言模型多学科能力评估指南

C-Eval

AI模型评测
248次浏览
2026-09-02

工具简介

深入了解C-Eval中文评估套件,涵盖52个学科与4级难度。本文详解其功能特点、Zero-shot/Few-shot使用方法及代码示例,助您全面评测LLM中文理解与泛化能力。

详细介绍

C-Eval是什么

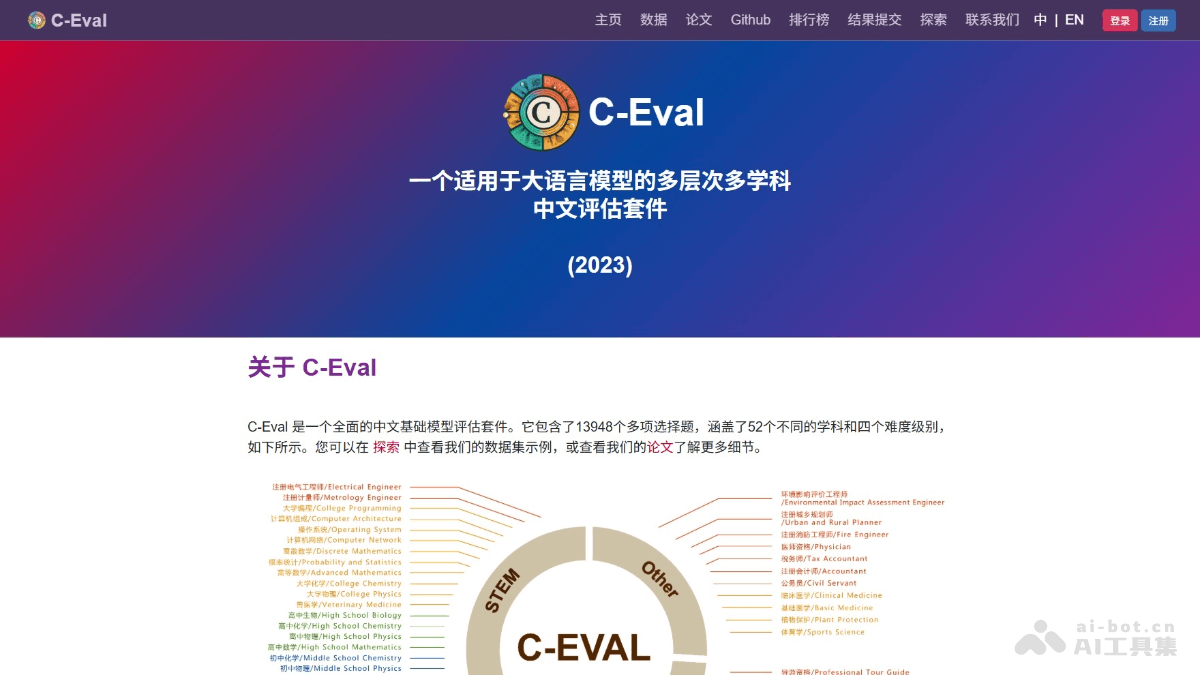
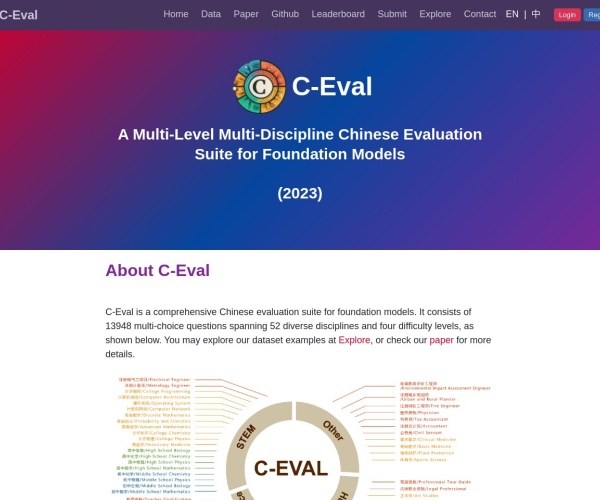
C-Eval是一套专为大语言模型设计的多层次、多学科中文评估基准,由上海交通大学、清华大学及爱丁堡大学的研究团队于2023年5月联合发布。该套件包含13,948道多项选择题,广泛覆盖52个不同学科领域,并划分为四个难度等级,旨在全面测评大模型的中文语境理解能力。借助零样本(zero-shot)和少样本(few-shot)测试机制,C-Eval能够有效评估模型在面对未知任务时的适应性与泛化性能。

C-Eval

C-Eval的主要功能

  • 广泛的学科覆盖:C-Eval收录了来自STEM(科学、技术、工程、数学)、社会科学及人文学科等52个不同领域的题目,全方位检验语言模型的知识广度与深度。
  • 细粒度的难度分级:设置从基础到高级的四个难度层级,能够细致地评估模型在不同复杂程度下的逻辑推理能力及知识泛化水平。
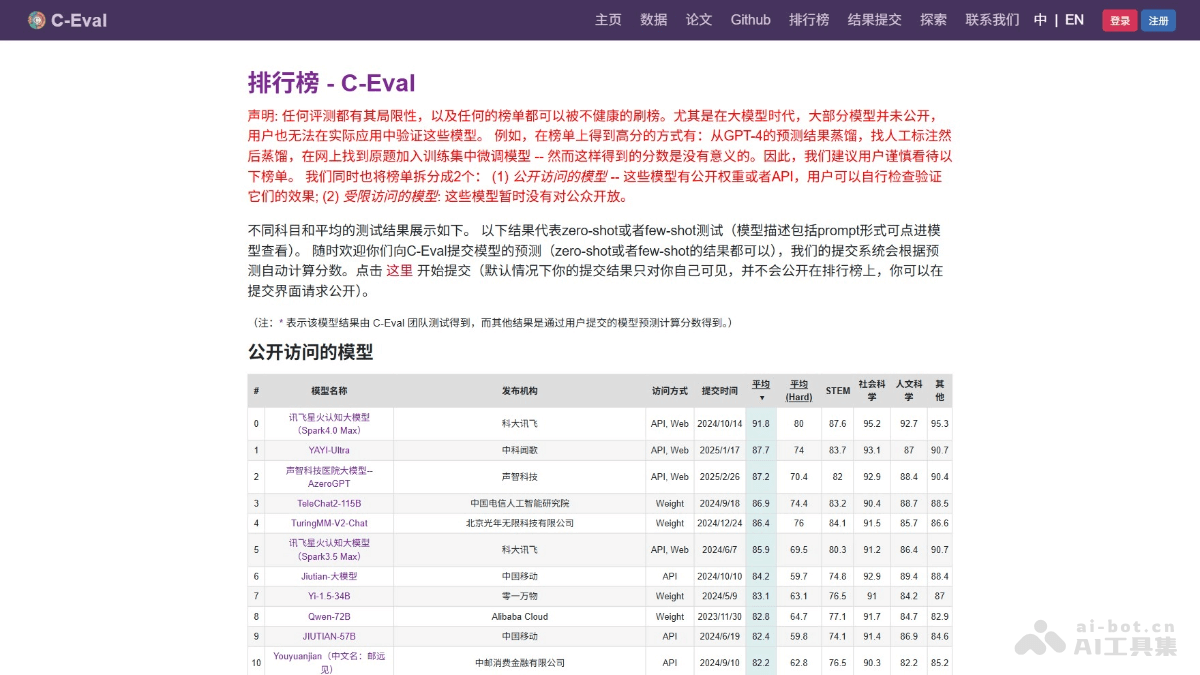
  • 标准化量化评估:基于13,948道标准化多项选择题,提供量化的性能指标评分体系,支持对不同大语言模型进行客观、公平的横向对比。

如何使用C-Eval

  • 获取数据集
    • 通过 Hugging Face 下载:
from datasets import load_dataset
dataset = load_dataset("ceval/ceval-exam", name="computer_network")
    • 或者直接下载 ZIP 压缩包并解压:
wget https://huggingface.co/datasets/ceval/ceval-exam/resolve/main/ceval-exam.zip
unzip ceval-exam.zip
  • 确定评估模式
    • 零样本(Zero-shot):模型在无额外示例辅助的情况下,直接对问题进行作答。
    • 少样本(Few-shot):模型在接收少量示例(例如5个演示样例)的提示后,再进行问题回答。
  • 加载模型:确保目标模型已正确加载并处于推理就绪状态。若使用 Hugging Face 生态,可参考以下代码加载模型:
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "your-model-name"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
  • 构建提示词(Prompt)
    • 零样本提示模板
以下是中国关于{科目}考试的单项选择题,请选出其中的正确答案。
{测试题目}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:
    • 少样本提示模板
以下是中国关于{科目}考试的单项选择题,请选出其中的正确答案。
{题目1}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:A
[k-shot 示例]
{测试题目}
A. {选项A}
B. {选项B}
C. {选项C}
D. {选项D}
答案:
  • 生成响应:调用模型生成回答内容。随后需从生成文本中提取答案选项(A、B、C、D),或通过计算各选项的概率分布来选择概率最高的答案。
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
answer = extract_answer(response)  # 自定义函数,提取答案选项
  • 执行评估
    • 针对验证集(val),可直接本地计算准确率。
    • 针对测试集(test),需将预测结果提交至 C-Eval 官方平台以获取最终评分。
from sklearn.metrics import accuracy_score

# 假设 `predictions` 是模型的预测结果,`labels` 是真实答案
accuracy = accuracy_score(labels, predictions)print(f"Validation Accuracy: {accuracy:.2f}")
  • 提交评测结果:整理所有测试题目的预测答案,生成符合要求的 JSON 文件:
{"chinese_language_and_literature": {"0": "A","1": "B",
    ...
  },
  ...
}
    • 登录 C-Eval 官方网站上传结果文件,以获取权威的最终评分。
C-Eval

C-Eval的应用场景

  • 大模型性能基准测试:全面量化语言模型的知识储备与逻辑推理能力,协助开发者针对性地优化模型表现。
  • 学术研究与横向对比:为科研人员提供统一标准的测试环境,便于深入分析并比较不同语言模型在各垂直学科的表现,推动AI学术研究进展。
  • 智慧教育工具开发:赋能智能辅导系统与自动化评估工具的开发,利用模型生成习题及自动批改功能,提升教育行业的智能化服务水平。
  • 垂直行业应用优化:在金融、医疗、客户服务等领域,精准评估模型的专业领域知识掌握情况,优化行业专用解决方案的效果。
  • 开源社区与技术竞赛:作为开放的评测平台,促进开发者之间的技术交流与合作,为各类模型竞赛及技术比拼提供公正、透明的基准测试工具。

最新文章

新能源汽车充电站日常巡检如何记录枪口、计费和告警状态

新能源汽车充电站日常巡检如何记录枪口、计费和告警状态

按充电枪建立巡检记录,分别核对设备状态、计费结果和告警处置,让充电站交接
Go regexp用 Expand 生成结构化替换文本的实践示例

Go regexp用 Expand 生成结构化替换文本的实践示例

用 Go regexp 的 Expand 和 FindSubmatchI
CSS scroll snap让横向卡片滚动停在卡片边界的实现方法

CSS scroll snap让横向卡片滚动停在卡片边界的实现方法

本文用一段最小 CSS 配方让横向卡片在滚动结束后停在卡片边界,说明 s
影视团队选择LibTV前要看什么?功能、成本与交付检查

影视团队选择LibTV前要看什么?功能、成本与交付检查

本文针对影视团队选型LibTV的实际需求,从功能、成本、交付三维度梳理全
Go archive/tar识别 Tar 硬链接与符号链接的排查指南

Go archive/tar识别 Tar 硬链接与符号链接的排查指南

Go archive/tar 不应通过文件名后缀判断 Tar 链接。读取
Linux inotify处理目录监控事件丢失风险的实现方法

Linux inotify处理目录监控事件丢失风险的实现方法

Linux inotify 不能保证事件永不丢失。本文围绕 IN_Q_O