OpenCompass是什么
OpenCompass是由上海人工智能实验室(上海AI实验室)在2023年8月正式发布的大模型开放评测体系。该体系通过提供完整、开源且可复现的评测框架,实现了对大语言模型及多模态模型的一站式评估,并定期更新发布权威的评测结果榜单。OpenCompass架构主要由三大核心模块组成:CompassKit(专业评估工具包)、CompassHub(基准数据社区)以及 CompassRank(权威评估排行榜)。该平台兼容多种模型接入方式(包括 Hugging Face 本地模型及各类 API 模型),覆盖语言能力、知识储备、逻辑推理等八大核心能力维度,并支持零样本(Zero-shot)、少样本(Few-shot)等多种主流评估方法。凭借分布式高效评估能力和灵活的扩展性,OpenCompass已促成众多知名企业与高校的深度合作,旨在推动大模型评估行业向标准化、规范化方向迈进。
OpenCompass的主要功能
- 模型评估工具(CompassKit):内置丰富的评估基准数据集和模型适配模板,支持零样本、少样本等多种评估策略,用户可根据具体需求灵活定制和扩展评估流程。
- 基准社区(CompassHub):构建开放的基准共享平台,允许用户上传和分享评估基准;社区内展示实时排行榜,高质量且经过验证的基准有机会被收录进官方权威榜单。
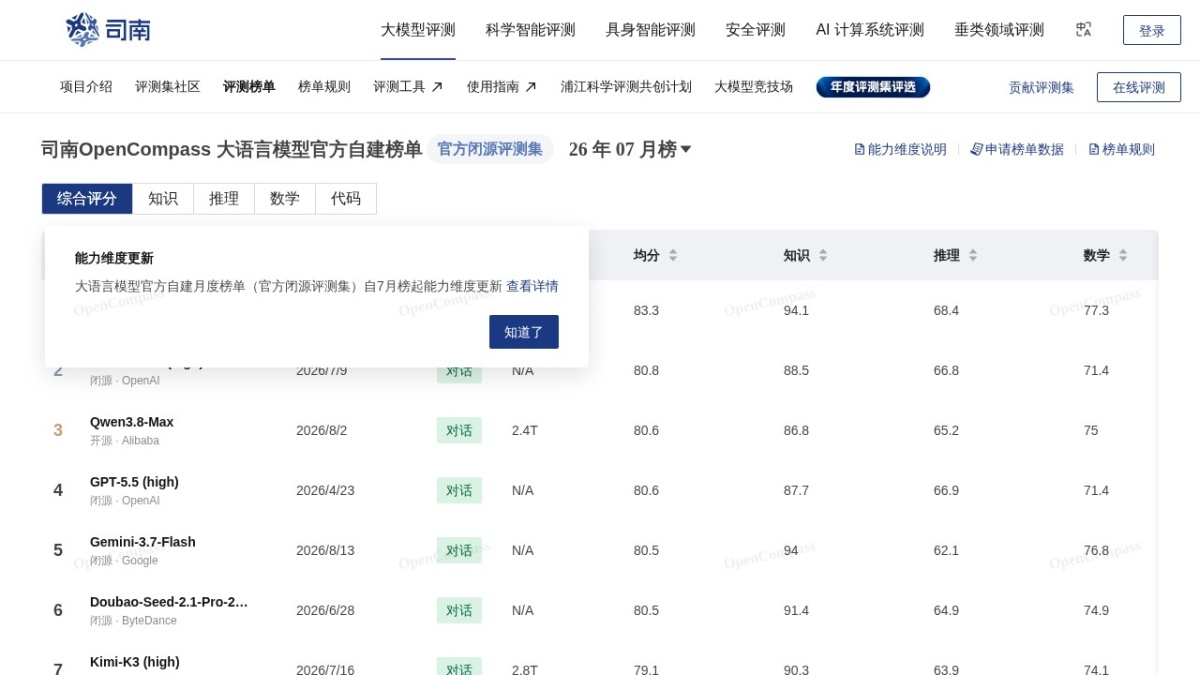
- 评估排行榜(CompassRank):提供全面、客观的模型评分与排名服务,涵盖八大核心能力维度,同时支持语言模型和多模态模型的横向对比,目前已吸引大量主流模型参与评测。
- 高效评估系统:采用分布式架构支持大规模模型的高效并行评估,内置实验管理功能和自动化报告生成工具,帮助用户实时监控进度并快速获取评估结果。
如何使用OpenCompass
- 访问官网:登录 OpenCompass 官方网站,全面了解平台的功能特性、最新资源及文档指南。
- 选择功能模块:根据实际需求选择对应的服务模块,如使用 CompassKit 进行本地评测、通过 CompassHub 共享基准或利用 CompassRank 查询排名。
- 提交模型或基准:若希望模型上榜,可在 CompassRank 提交模型的 API 接口或代码仓库地址;若有新的评估标准,可在 CompassHub 发布并共享评估基准。
- 安装与配置:若使用 CompassKit 进行本地评估,需从 GitHub 克隆项目代码,安装必要的依赖库并完成环境配置。
- 执行评估:利用 CompassKit 在本地环境中运行评估任务,或者提交模型后等待官方完成评估并将结果同步至 CompassRank。
- 查看结果:通过 CompassRank 浏览全球模型的公开排名情况,或使用 CompassKit 生成的本地报告深入分析模型性能细节。
OpenCompass的应用场景
- 模型性能评估与优化:帮助企业及科研机构对语言模型或多模态模型进行全方位的多维度评估,精准识别模型的优势领域与短板,从而针对性地优化模型性能。
- 学术研究:为研究人员提供丰富且标准化的基准测试集,便于开展不同模型间的对比实验与研究,加速人工智能领域的学术创新与发展。
- 企业级应用开发:企业在构建智能客服、自动写作等实际应用时,可利用该平台评估不同模型在特定业务场景下的表现,从而筛选或定制最契合需求的模型方案。
- 教育与培训:教育机构可将 OpenCompass 引入教学体系,作为实践工具帮助学生掌握大模型评估方法论及优化技巧,深化对人工智能技术的理解与应用能力。
- 社区共建与共享:鼓励开发者和研究者将自研模型或评估基准贡献至 OpenCompass 社区,促进资源互通与共享,共同推动大模型评估技术的进步与生态繁荣。