当前位置:首页 >专题 >Go PDF 文档处理与生成工程
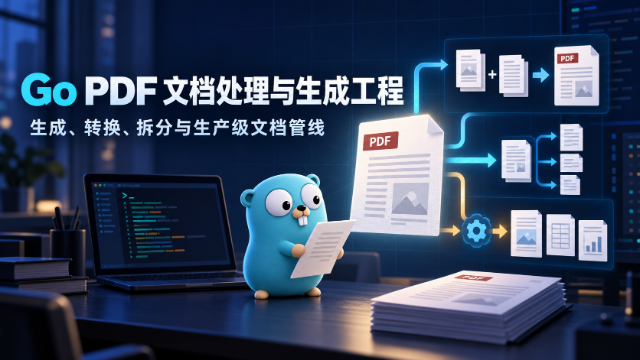
Go PDF 文档处理与生成工程
Go PDF 文档处理与生成工程
从 PDF 生成、转换到拆分、压缩与生产级文档管线
PDF 自动生成、格式转换和批量处理是报表、合同、票据与内容平台常见的工程需求。本专题以 Go 标准库图像能力和 pdfcpu 等当前工具为入口,精选站内真实文章,串起生成、渲染、拆分、压缩和服务化处理路线。
官方入口与开发资料
先建立 PDF API、工具与 Go 图像处理的资料基线
官方
Go image 包 API
Go 标准库图像类型、解码编码和像素模型的 API 参考。
官方
pdfcpu 官方网站
pdfcpu 的 Go API、命令行工具、处理能力与文档入口。
官方
pdfcpu Getting Started
官方快速开始,介绍安装 CLI 以及在应用中使用 Go API。
官方
pdfcpu Go API 文档
pdfcpu 包、配置、API 和错误处理的 GoDoc 参考。
官方
pdfcpu 官方仓库
源码、版本、API samples、CLI 示例和问题追踪入口。
官方
Go image/jpeg 与 image/png API
JPEG 编解码参数、质量设置和 PNG 处理相关 API 入口。
站内 PDF 工程实践路线
从生成与渲染到拆分、压缩和批处理




Go PDF 处理常见问题
围绕生成、转换、字体、性能与可靠性的实用答案
Go 生成 PDF 应该优先选哪类库?
先按需求区分生成、解析、合并拆分和渲染;需要纯 Go 的文档处理时可优先评估 pdfcpu,需要复杂排版时还要核对字体、中文和授权边界。
PDF 转 PNG 和 JPEG 如何选择?
PNG 更适合文字、线条和需要无损清晰度的预览,JPEG 更适合照片或对体积敏感的场景;最终应结合页内容、目标尺寸和传输成本实测。
批量拆分 PDF 时怎样避免内存暴涨?
控制单批页数,使用临时文件或流式边界,及时关闭文件句柄,并为大文件设置超时、并发上限和失败重试;不要把所有页面和输出一次性留在内存。
Go PDF 服务如何处理中文字体和乱码?
显式选择支持中文的字体并确认嵌入方式,统一 UTF-8 输入和字体文件来源;在部署环境中固定字体资产并用真实中文、数字和符号做回归测试。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- 矿山企业新员工上岗前如何留存安全培训记录
- 20秒前 490浏览
-
- Go slices.Compact 清理重复值时为什么还要处理尾部
- 4分钟前 254浏览
-
- Popover API 点击外部自动关闭时如何保留表单状态
- 5分钟前 220浏览
-
- Go pprof.Lookup 如何导出指定名称的运行时剖面
- 11分钟前 141浏览
-
- Linux ip rule 优先级冲突时如何判断实际路由表
- 14分钟前 357浏览
-
- Go slices.SortStableFunc 处理相等元素如何保持顺序
- 15分钟前 409浏览
-
- SkildArt Agent模式如何提高效率?复用任务简报与审核节点
- 19分钟前 372浏览
-
- Python json.loads 解析超大整数时如何限制输入风险
- 19分钟前 212浏览