当前位置:首页 >专题 >Hugging Face 开源模型工程实践专题
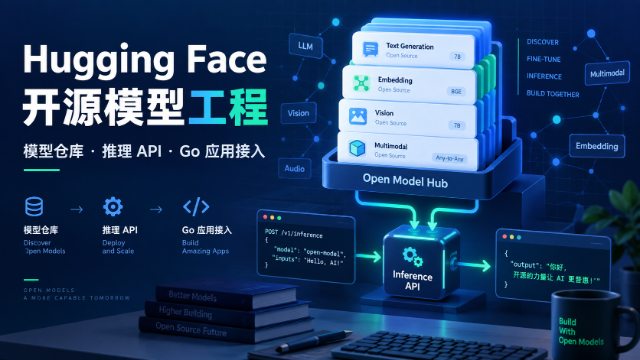
Hugging Face 开源模型
Hugging Face 开源模型工程实践专题
从模型仓库、推理 API 到 Go 应用接入
Hugging Face 已从模型展示平台发展为连接模型仓库、数据集、Spaces、推理服务与开源工具链的开发者基础设施。本专题不只介绍如何下载模型,而是围绕模型卡、许可证、访问令牌、Inference Providers、任务类型和服务稳定性,串起从发现模型到 Go 应用接入的工程闭环。
官网、模型仓库与推理 API 官方入口
先建立 Hub、模型卡、令牌、Provider 与 Go 接入的权威基线
官方
Hugging Face 官方首页
Hugging Face 官方总入口,连接模型、数据集、Spaces 与开发者工具。
官方
Hugging Face Hub 官方文档
官方 Hub 文档总览,覆盖模型仓库、数据集、Spaces、版本与协作。
官方
模型卡官方指南
说明模型卡中的用途、限制、训练数据、评估与许可证信息。
官方
访问令牌与安全官方文档
介绍 User Access Token 的权限范围、创建与安全使用方式。
官方
Inference Providers 官方指南
官方介绍通过 Hugging Face 访问多家推理 Provider 和模型服务。
官方
InferenceClient API 参考
官方 InferenceClient 参数、任务接口与响应契约参考。
官方
Hugging Face Hub Python 客户端仓库
官方客户端源码、变更记录与 API 实现参考。
官方
Hugging Face Go 生态包检索入口
Go 官方包索引中的 Hugging Face 相关库与实现检索入口。
站内开源模型与 AI 应用工程路径
从模型生态认知推进到推理、生成和应用层验收




Hugging Face 模型接入 FAQ
回答模型许可、Provider、令牌和 Go 服务上线前的关键问题
Hugging Face Hub 上的模型都可以直接用于商业项目吗?
不可以。必须逐个阅读模型卡、许可证、用途限制、训练数据说明和 Provider 条款;仓库可下载不等于获得相同的商业授权。
Inference Providers 和本地部署应该如何选择?
按数据敏感性、延迟、吞吐、模型许可、成本、可用区域和运维能力做基准测试;Provider 适合快速接入与弹性验证,本地部署适合对数据边界和长期成本有更强控制的场景。
Go 服务调用 Hugging Face 推理 API 要重点处理什么?
至少固定模型与 Provider,设置连接和请求超时,限制重试次数并区分 4xx 与 5xx,校验响应结构和错误字段,记录请求耗时、令牌或计费指标,并为限流、降级和幂等保留路径。
访问令牌应该放在 Go 代码或前端配置里吗?
不应该。令牌应放在服务端密钥管理或 CI Secret 中,按读取、写入和管理权限最小化,定期轮换并避免写入日志、镜像和客户端包;公共模型下载也应按官方限流与认证要求配置。
相关专题
继续查看相近方向内容
查看更多
最新文章
-
- Go io.CopyBuffer 传入零长度缓冲区为什么会 panic
- 7分钟前 428浏览
-
- tapaim电竞海选活动是什么?3.0.0版本公告与参与边界说明
- 7分钟前 228浏览
-
- Linux nftables 动态集合怎么设置元素过期时间
- 11分钟前 470浏览
-
- 喵次元 iOS自签入口怎么看?公开页面的平台提示与责任边界
- 18分钟前 344浏览
-
- Python subprocess.Popen pipesize 什么时候有效
- 19分钟前 187浏览
-
- Go printer.Config.Fprint 怎么控制 AST 输出缩进
- 20分钟前 447浏览
-
- Go gif.GIF.Disposal 长度与图像帧不一致怎么办
- 28分钟前 143浏览
-
- painter绘画助手笔刷平滑度怎么调?速度、压力与动态控制说明
- 30分钟前 490浏览