
Go compress/gzip 处理多成员流时怎么识别 EOF
来源:17golang原创
时间:2026-09-08 18:19:13 233浏览 收藏
处理连续 gzip 数据时,最容易误判的是“读到了 io.EOF”。Go 的 compress/gzip 默认开启多成员模式:多个带独立头尾的 gzip 成员会被当成一条解压后的逻辑流,只有整个输入结束后才算读完。若业务要逐个处理成员,就要调用 Multistream(false),在当前成员读取到 io.EOF 后,再用 Reset 判断是否存在下一个成员。
拼接读取用默认模式;逐成员读取用Multistream(false)。单成员的io.EOF表示当前成员结束,最后一次Reset返回io.EOF才表示没有下一个成员;截断数据和校验失败不能当作正常结束。
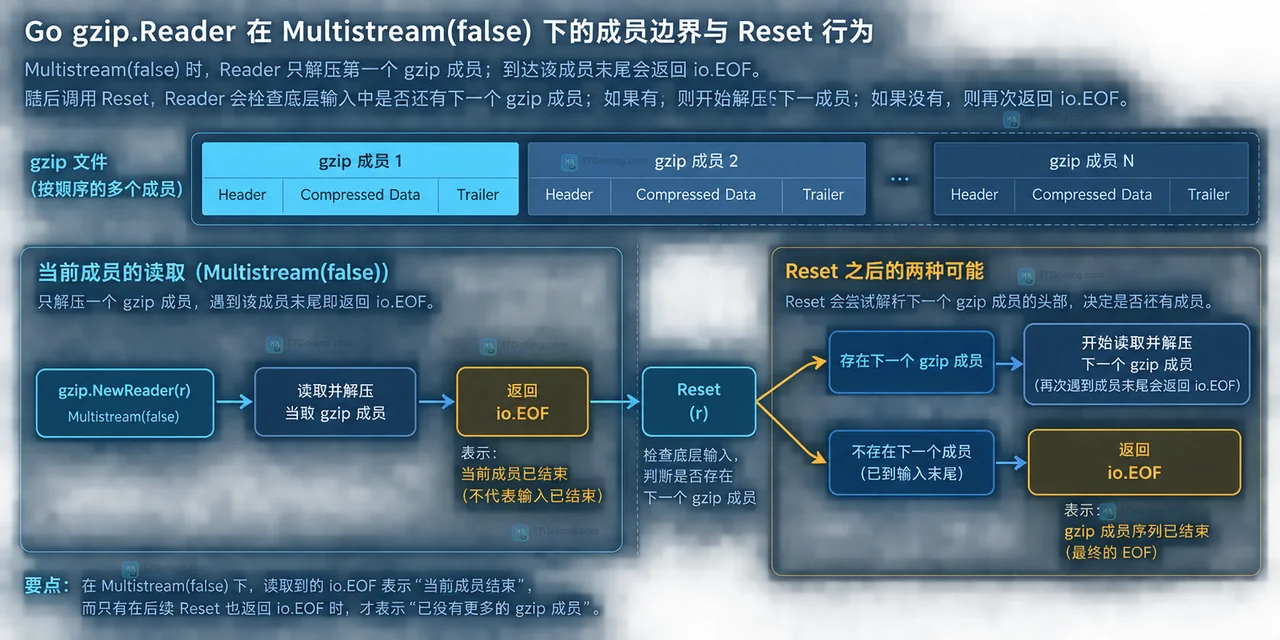
Multistream(true)会自动串联 gzip 成员,适合只关心解压后的总内容。Multistream(false)会在单个成员结束时返回io.EOF,然后通过Reset进入下一段。- 底层 reader 最好实现
io.ByteReader,并区分最后成员、截断输入和gzip.ErrChecksum。
Go gzip.Reader 默认为什么只给你一条流
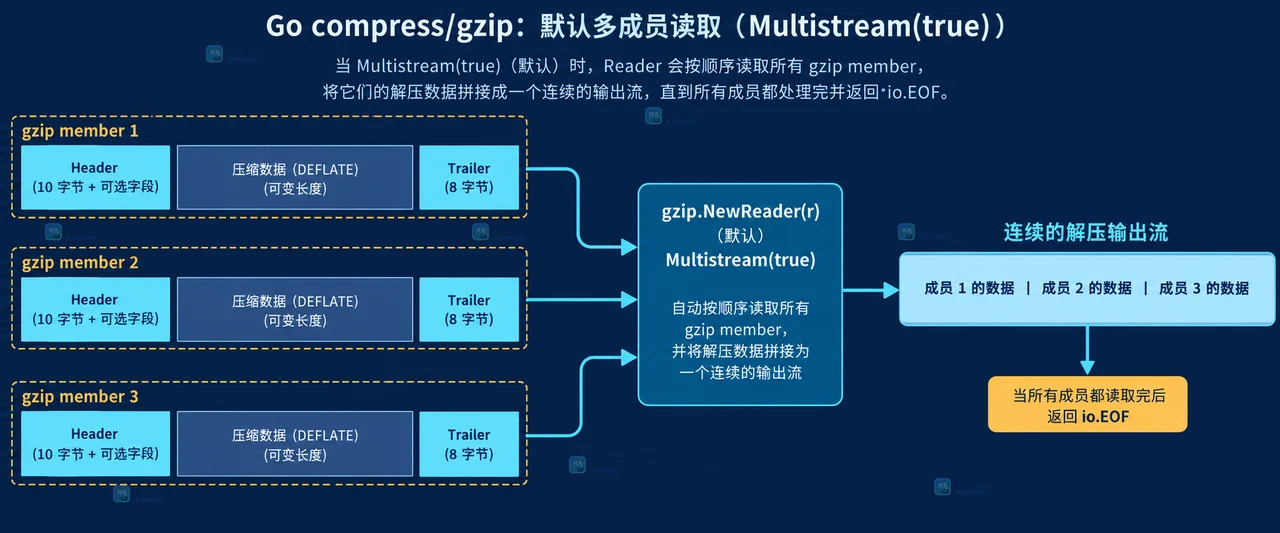
gzip 格式允许一个文件由多个 member 连接而成,每个 member 都有自己的头部、压缩数据和尾部。gzip.NewReader 创建的 reader 默认启用多成员支持,所以第一次成员读完后,它会继续寻找下一个 gzip 头部,把所有成员的解压结果连续返回。此时,调用方看到的 io.EOF 是整个成员序列的结束,而不是第一个成员的结束。
因此,日志切片、归档分段或“一个 member 对应一条记录”的场景,不应该只围绕默认的 io.Copy 写业务边界。先决定你要的是总内容,还是每个 member 的独立处理结果。
Multistream(false) 怎样识别每个成员的 EOF
逐成员读取的关键是把 io.EOF 分成两个位置理解:第一次出现在 Read 或 io.Copy 结束时,表示当前 member 已经完成;随后调用 Reset 读取下一个头部,如果它返回 nil,说明还有下一段,如果返回 io.EOF,才是整个输入结束。
package main

import (
    "bytes"
    "compress/gzip"
    "errors"
    "fmt"
    "io"
)

func readMembers(src *bytes.Reader) error {
    zr, err := gzip.NewReader(src)
    if err != nil {
        return fmt.Errorf("创建 gzip reader: %w", err)
    }
    defer zr.Close() // 释放解压器;底层 src 由调用方管理

    for member := 1; ; member++ {
        zr.Multistream(false) // 每次只消费一个 gzip member

        data, err := io.ReadAll(zr)
        if err != nil {
            // ErrChecksum、UnexpectedEOF 都不是正常的成员结束。
            return fmt.Errorf("读取第 %d 个 member: %w", member, err)
        }
        fmt.Printf("member %d: %s\\n", member, data)

        err = zr.Reset(src) // 重新读取下一个 member 的 gzip 头
        if errors.Is(err, io.EOF) {
            return nil // 没有下一个 member,整个输入正常结束
        }
        if err != nil {
            return fmt.Errorf("定位第 %d 个 member: %w", member+1, err)
        }
    }
}
示例中的 bytes.Reader 同时提供 Read 和 ReadByte,因此 gzip reader 能在成员边界后把底层位置保留下来。网络流、文件包装器或自定义 reader 如果只实现了 io.Reader,解压器可能预读超过当前成员,逐成员定位就不能依赖同样的边界行为。
EOF、截断和校验失败要怎样区分
不要把所有“读不到更多字节”的结果都归为成功。完整 member 的压缩数据、长度和 CRC 都被消费后,才会得到正常结束;数据在尾部前被截断时,通常会得到 io.ErrUnexpectedEOF;如果尾部存在但 CRC 或未压缩长度不匹配,gzip.Reader 会返回 gzip.ErrChecksum。官方文档也建议,在真正收到标记结束的 io.EOF 前,把已经读出的数据视为暂定结果。
| 返回结果 | 含义 | 处理建议 |
|---|---|---|
Read 得到 io.EOF | 当前 member 已完成(Multistream(false)) | 调用 Reset 尝试下一个 |
Reset 得到 io.EOF | 没有下一个 member | 结束整个序列 |
io.ErrUnexpectedEOF | 输入在完整尾部前截断 | 记录损坏并重试或丢弃 |
gzip.ErrChecksum | 校验值或长度不匹配 | 按数据损坏处理 |
实际项目中应该选择哪一种读取方式
如果下游只需要解压后的整体文本、日志或对象,保持默认多成员模式更简单;如果每个 member 都要单独落盘、计数、解析或失败重试,就使用 Multistream(false),让成员边界成为业务循环的一部分。输入来自网络时,还要考虑流可能永远没有最终 EOF,必须结合请求取消、最大读取量和超时控制,不能单靠 gzip 的结束信号保护服务。
最后检查两点:第一,Reset 前应让当前 reader 完整读到结束,不能中途跳过校验;第二,Close 不会替你关闭底层 reader,文件或 HTTP body 仍由外层负责关闭。这样处理,正常 EOF 与损坏输入才不会混在同一条成功路径中。
常见问题
默认 gzip.Reader 能不能读取多个 gzip 文件?
可以。默认 Multistream(true) 会把连续 gzip member 的解压结果拼接返回;只有需要独立边界时才关闭它。
为什么第一个 member 读完没有返回 EOF?
因为多成员模式会继续寻找下一个 gzip 头。改用 Multistream(false) 后,当前 member 的结束才会显式返回 io.EOF。
Reset 返回 EOF 是错误吗?
在逐成员循环里不是错误,它表示当前输入没有下一个 gzip member。真正需要关注的是 ErrUnexpectedEOF 和 ErrChecksum。
为什么底层 reader 要实现 io.ByteReader?
gzip reader 可能预读输入。实现 io.ByteReader 能让它在成员结束后更准确地停在下一个流的起点,便于 Reset 继续解析。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
142 收藏
-
189 收藏
-
424 收藏
-
192 收藏
-
364 收藏
-
328 收藏
-
430 收藏
-
182 收藏
-
478 收藏
-
413 收藏
-
475 收藏
-
165 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习