
Go xml.Decoder 设置 Strict=false 后哪些输入仍然不能解析
来源:17golang原创
时间:2026-09-14 20:12:15 128浏览 收藏
接手一段不稳定的 XML 导入代码时,最容易产生的误解是:把 Decoder.Strict 设为 false,所有“看起来像 XML”的文本就都能读进来。实际情况更窄:它主要放宽缺少结束标签、部分字符实体和局部标签闭合问题;输入如果连基本 token 都无法形成,或者编码、命名空间和文档边界出了问题,解析仍会失败。
判断 Strict=false 是否有用,先问“这是可恢复的结构小错,还是无法切词的语法/编码错误”。前者可以兼容,后者必须修复输入或显式转换。
- 缺失结束标签、未知或格式不良实体,是 Strict=false 主要照顾的两类输入。
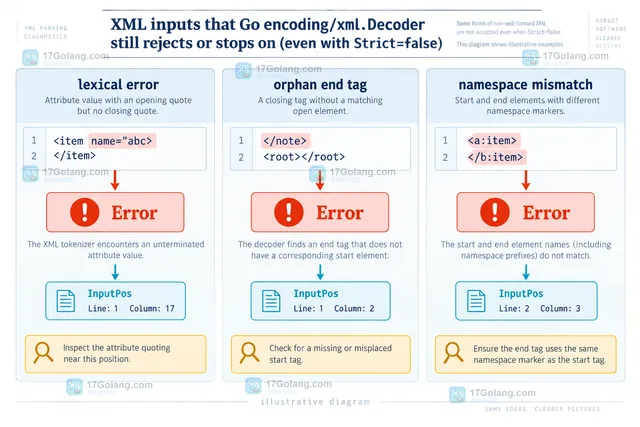
- 孤立结束标签、属性引号未闭合、损坏的注释或 CDATA,仍可能在 token 层失败。
- 非 UTF-8 数据要靠 CharsetReader;HTML 实体要靠 Entity,不能把它们混同于 Strict。
先看懂 Strict=false 究竟放宽了什么
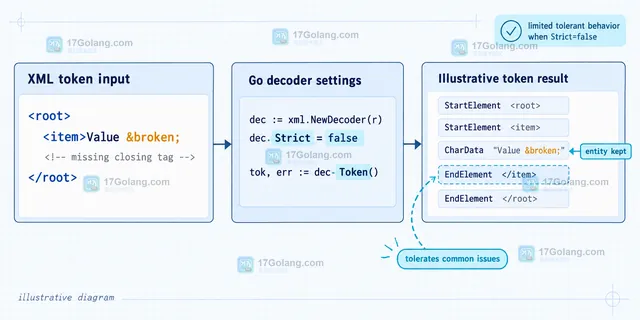
xml.NewDecoder 创建的解码器默认是严格模式。关闭后,遇到一个开始标签没有对应结束标签时,Token 可以补出结束节点,让返回的开始、结束元素保持平衡;属性值和字符数据中的未知或格式不良实体,也可以原样留下。这个行为适合读取来源不稳定、接近 HTML 的数据,但它不是 XML 清洗器。
即便把 Go 标准库 xml.Decoder 的 Strict 字段设置为 false,也只能跳过部分 XML 语法校验,不少存在底层格式错误、语义冲突、编码违规的输入依然会直接抛出解析错误,没法正常把数据映射到结构体中。
package main
import (
"encoding/xml"
"fmt"
"io"
"strings"
)
func main() {
input := `- 文本 &broken
示例中的 &broken 不会因为名字陌生就自动变成某个字符;如果业务需要 HTML 风格实体,应另行设置 d.Entity。同样,缺少结束标签被补齐,只代表 token 流能继续走,不代表原始文档已经合规。
哪些输入仍然会在解析阶段失败
第一类是连标签或属性都无法切出来的损坏。例如开始标签写到一半就结束、属性值使用引号却没有闭合、注释或 CDATA 起始标记没有对应结尾。这些问题发生在生成 token 之前,Strict=false 没有足够信息去推断原意。
第二类是没有可匹配父节点的结束标签,例如文档直接出现 。宽松模式可以对某些局部名称不一致的闭合做恢复,但没有任何已打开元素时仍是意外结束标签,不能当作正常节点交给 Decode。
第三类是命名空间不一致。未声明的前缀在 Token 中可能被记录为未知空间,但开始元素和结束元素的命名空间不同,仍然属于结构错误。不要把“忽略命名空间声明”误解成“允许任意命名空间混用”。
用四个字段把问题分层定位
| 现象 | 优先检查 | 处理建议 |
|---|---|---|
| 缺少结束标签 | Strict、AutoClose | 确认是否允许补齐,并记录原文告警 |
| 未知实体 | Entity | 定义映射或保留原样,避免静默改值 |
| 非 UTF-8 输入 | CharsetReader | 先转换为 UTF-8;转换器为空或报错就停止 |
| 失败位置不清 | InputPos、InputOffset | 把行列或字节偏移写入日志 |
AutoClose 只在非严格模式下把指定元素视为立即闭合,常见于类 HTML 输入;它不会修复任意嵌套关系。Entity 可以增加非标准实体映射,但内置的五个 XML 基本实体仍按标准处理。若输入声明了其他字符集,CharsetReader 必须返回非空的转换 reader,否则解码会以错误结束。
func decodeXML(data string) error {
    d := xml.NewDecoder(strings.NewReader(data))
    d.Strict = false // 兼容有限的脏输入
    d.Entity = map[string]string{"nbsp": " "} // 只声明业务确认过的实体

    for {
        _, err := d.Token()
        if err == io.EOF {
            return nil // 完整消费 token 后才算成功
        }
        if err != nil {
            line, column := d.InputPos() // 记录失败附近的行列
            return fmt.Errorf("XML 第 %d 行第 %d 列: %w", line, column, err)
        }
    }
}
把宽松解析放在正确的业务边界
配置文件、权限、账务或需要严格校验的接口,通常应保留默认严格模式,并把错误返回给上游。只有在确实面对历史 XML、抓取片段或类 HTML 数据时,才考虑 Strict=false;同时保存原文摘要、解析告警和缺失字段,避免“解析成功”掩盖数据被补齐或实体被保留的事实。
最终检查可以按这个顺序执行:先确认字符集,再确认是否能持续返回 token;发现缺失闭合时判断是否允许恢复;遇到实体时核对映射;最后用 InputPos 或 InputOffset 记录失败点。这样定位出来的才是“Strict 放宽范围之外的真实问题”。
常见问题
Strict=false 会自动把 XML 当 HTML 解析吗?
不会。要接近 HTML 的效果,通常还要配合 AutoClose 和 HTMLEntity;而且这仍是有限的 token 容错,不是完整 HTML 解析器。
未知实体会直接报错吗?
严格模式下通常会报错;非严格模式下,在属性值和字符数据中的未知或格式不良实体可以被保留。业务若需要字符替换,应显式维护映射并测试数据语义。
为什么少一个结束标签能成功,少一个属性引号却失败?
前者还能形成开始元素,解码器有机会补一个结束节点;后者破坏了属性值的词法边界,连合法 token 都不一定能产生,所以不能简单靠 Strict=false 推断。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
319 收藏
-
454 收藏
-
169 收藏
-
280 收藏
-
228 收藏
-
303 收藏
-
490 收藏
-
Golang · Go问答 | 1小时前 | Go问答 · XML解析 · encoding/xml · 切片生命周期 · Go排错 · Decoder.Token Go encoding/xml xml.CharData CharData.Copy Go XML 文本复用399 收藏
-
466 收藏
-
Golang · Go问答 | 2小时前 | 错误处理 · go · 指针类型 · errors.As · 错误包装 · Go errors.As errors.As目标变量 Go包装错误 Go指针错误类型 Go错误类型判断391 收藏
-
Golang · Go问答 | 3小时前 | 标准库 · 错误处理 · go · errors.Join · errors.Is · errors.Is Go错误处理 Go errors.Join 多错误包装 错误匹配198 收藏
-
164 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习