
Go pprof goroutine profile 的等待状态怎么解释
来源:17golang原创
时间:2026-09-15 14:09:30 330浏览 收藏
我第一次把 Go 服务的 goroutine profile 打开时,最容易误判的是方括号里的等待状态:看到大量 IO wait 就以为线程被网络拖死,看到 chan receive 就以为发生了死锁。其实 goroutine profile 只是某一时刻所有存活协程的栈快照,状态要和栈顶函数、等待时长以及业务上下文一起解释。
debug=2最适合人工阅读,会显示等待状态、时长和完整栈。- 状态描述“当前停在哪里”,不直接等于故障;短暂等待、后台循环和请求空闲都可能正常。
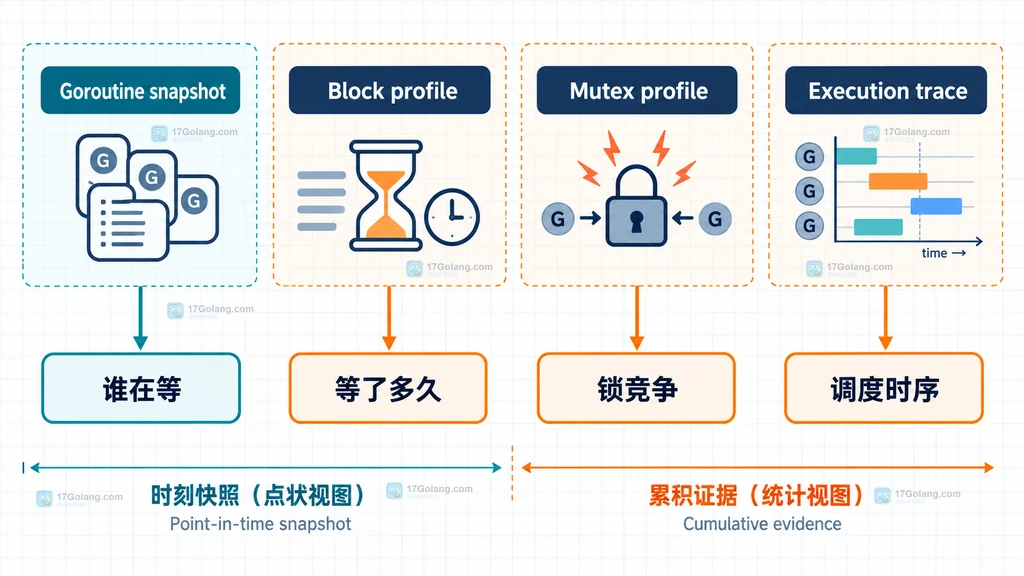
- 要回答“累计阻塞多久、锁竞争多大”,应补采 block 或 mutex profile。
先采集一份能读懂的 goroutine profile
标准库预置的 goroutine profile 记录当前协程栈。服务已经引入 net/http/pprof 时,可以先拿文本快照:
# 用 debug=2 获取类似 panic 堆栈的可读格式
curl -sS 'http://127.0.0.1:6060/debug/pprof/goroutine?debug=2' -o goroutines.txt

# 统计快照中的协程头部,先观察状态分布
grep '^goroutine ' goroutines.txt | sort | uniq -c
若应用使用自定义路由,也可以直接调用 pprof.Lookup("goroutine").WriteTo 写入文件。debug=1 是传统文本格式,debug=2 则更接近未恢复 panic 时的协程栈,更适合排障阅读。协程头部常见形态是 goroutine 42 [chan receive, 3 minutes]:编号用于串联整段栈,方括号是运行时等待原因,后面的时间是该次等待的持续时间线索。
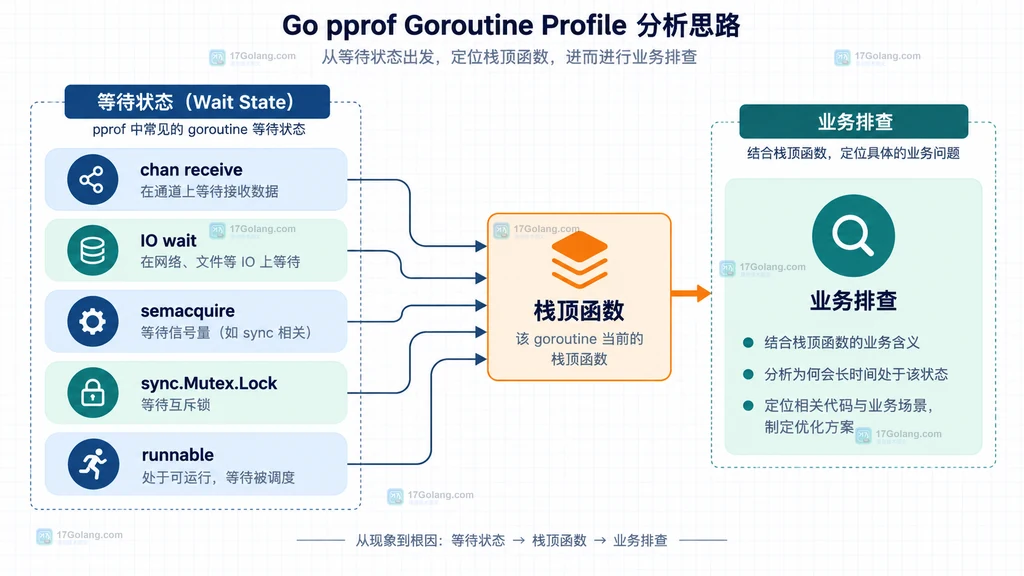
等待状态要和栈顶函数一起解释
我通常先按“等待对象”分组,再看每组最深的业务栈,而不是把状态名当结论:
| 状态线索 | 优先联想到 | 下一步 |
|---|---|---|
chan receive / chan send | 通道没有数据、没有接收者或生产消费失衡 | 沿栈找具体 channel 所在的循环、退出条件和关闭责任 |
semacquire | WaitGroup、信号量或其他运行时同步等待 | 检查 Add/Done 是否配对,以及等待者是否有超时或取消路径 |
sync.Mutex.Lock | 互斥锁竞争 | 看持锁栈和临界区;累计时间用 mutex profile 补证 |
IO wait | 网络轮询器等待可读写事件 | 检查连接、超时和请求量;它通常不等于占满 OS 线程 |
sleep / timer | 定时任务、退避或 ticker | 确认周期与业务目标,避免把正常休眠当泄漏 |
runnable 表示协程已可运行但快照时尚未拿到处理器;它不是“正在执行很久”的证据。running 也只是采样瞬间的状态。真正需要警惕的是多个采样中同一业务栈持续增长,或者一组协程互相等待、没有可达的释放路径。
什么时候该换用 block、mutex 或 trace
goroutine profile 回答的是“现在有哪些协程、它们停在什么栈上”,不负责累计每个同步点阻塞了多久。若问题是“哪个调用让大量协程排队”,在程序中按需开启 block profile,再用 go tool pprof 查看;锁竞争则选择 mutex profile。两者都能把等待从单次快照提升为一段时间内的统计。
package main

import "runtime"

func enableContentionProfiles() {
	// 记录同步阻塞事件,值为 1 表示尽量记录每次阻塞。
	runtime.SetBlockProfileRate(1)
	// 记录部分互斥锁竞争,比例需按生产开销谨慎选择。
	runtime.SetMutexProfileFraction(5)
}
这段配置不是 goroutine profile 的前置条件,而是另一条证据链。需要分析调度、系统调用、GC 或网络事件的时间关系时,再考虑 execution trace;不要仅凭一个等待状态就改调度参数或盲目增加 worker。
用重复采样把猜测变成判断
一次快照只代表一个时间点。我会间隔几秒保存两到三份 profile,比较协程总数、同一栈的数量和等待时长:数量稳定且栈符合后台职责,多半是正常等待;数量持续上升并集中在同一接收、发送或锁栈,才优先检查退出、关闭和超时逻辑。对 HTTP 服务,还要把 profile 中的请求栈和请求超时、连接池指标对照,避免把流量低谷误判成阻塞。
最后检查三件事:生产者是否一定会发送或关闭 channel,WaitGroup 的每次 Add 是否有对应 Done,外部 I/O 是否设置了可传播的 context 截止时间。这样读出来的“等待状态”才会落到具体修复动作。
相关问题
goroutine 数量多就一定是泄漏吗?
不一定。后台消费者、连接处理和定时器都会长期存活;要看数量趋势、栈是否重复以及是否能随请求结束回收。
为什么 IO wait 没有直接说明网络故障?
它只说明协程在等待网络轮询事件,连接可能很快就会就绪。结合超时、错误率和重复快照判断。
看到 semacquire 应该先改成 channel 吗?
不应该。先沿栈确认是 WaitGroup、信号量还是其他同步原语,再检查释放路径;换实现方式不是诊断结论。
记住一个实用顺序:先用 goroutine?debug=2 找“谁在等”,再用 block/mutex profile 找“等了多久”,最后用 trace 或业务指标确认“为什么没有被唤醒”。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
180 收藏
-
Golang · Go问答 | 36分钟前 | 单元测试 · 错误处理 · go · t.Cleanup · testing.T · Go testing.T Cleanup失败 Go t.Cleanup错误处理 Go测试清理函数继续执行 Go测试失败不终止 Go测试资源释放排查267 收藏
-
156 收藏
-
460 收藏
-
456 收藏
-
211 收藏
-
161 收藏
-
270 收藏
-
222 收藏
-
Golang · Go问答 | 2小时前 | uintptr · 垃圾回收 · Go问答 · unsafe.Pointer · 指针安全 · unsafe.Pointer uintptr go垃圾回收 Go指针转换 unsafe指针问题330 收藏
-
301 收藏
-
345 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习