
Go gzip Multistream(false) 为什么还要读取底层边界
来源:17golang原创
时间:2026-09-27 04:03:39 277浏览 收藏
先说结论:Multistream(false) 控制的是“首个 gzip member 结束后是否自动继续下一个 member”,并不保证解码器只向普通 io.Reader 请求恰好那么多字节。要让底层输入精确停在首个 member 之后,传给 gzip.NewReader 的对象还必须实现 io.ByteReader,最常见的做法是先包一层 bufio.Reader。
- 停止条件:关闭 multistream 后,首个 gzip member 完整读取后返回
io.EOF。 - 边界条件:底层对象实现
ReadByte,gzip 才能避免多取后续协议数据。 - 完整性条件:必须读到 EOF,才能完成 CRC32 与原始长度校验。
Multistream(false) 管 member,不管普通 Reader 的预读
我第一次在 gzip 数据后拼接自定义元数据时,直觉上以为调用 Multistream(false) 就足够了。实际问题在于两个“边界”并不是一回事:multistream 决定是否继续解析下一个 gzip member,而底层读取粒度由传入对象的接口能力决定。
一个 gzip member 由 header、压缩数据和 trailer 组成。trailer 保存未压缩数据的 CRC32 和长度,因此解码器必须读完它,才能确认刚刚交付的数据有效。Go 官方文档也明确说明:如果底层只实现 io.Reader,解压器可能读取超过必要范围的数据;只有实现 io.ByteReader,关闭 multistream 时才保证位置正好落在 gzip stream 之后。
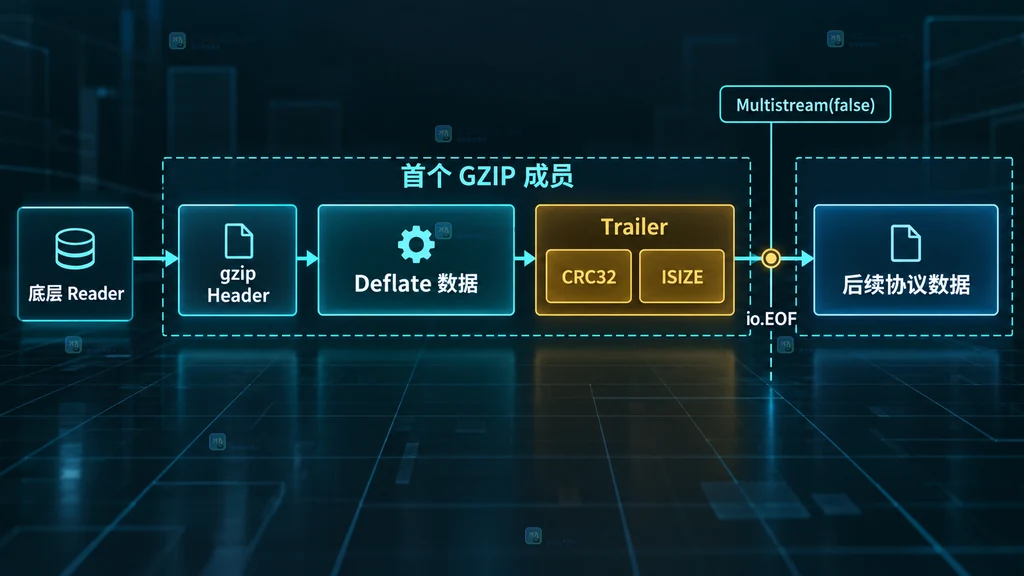
生产代码先把底层输入包装成 io.ByteReader
*bufio.Reader 同时实现 io.Reader 和 io.ByteReader。即使它提前从网络连接中读取了更多字节,这些字节也仍保存在同一个缓冲区里,后续解析继续从该缓冲区读取即可,不会丢失边界后的内容。
func readFirstMember(src io.Reader, dst io.Writer) (*bufio.Reader, error) {
    br := bufio.NewReader(src)

    zr, err := gzip.NewReader(br)
    if err != nil {
        return nil, fmt.Errorf("创建 gzip reader: %w", err)
    }
    defer zr.Close() // 只关闭 gzip reader,不会关闭底层 src

    zr.Multistream(false)

    // 必须读到 EOF,才能校验 trailer 中的 CRC32 与原始长度。
    if _, err := io.Copy(dst, zr); err != nil {
        return nil, fmt.Errorf("读取首个 gzip member: %w", err)
    }

    // 后续协议数据仍从 br 读取,不能绕过它直接读 src。
    return br, nil
}
这里最容易犯的错是:gzip 解码结束后又回到原始 src 继续读。由于 bufio.Reader 可能已经缓存了后续字节,绕过它会造成数据看似“消失”。正确做法是让 gzip 和后续协议解析始终共享同一个 br。
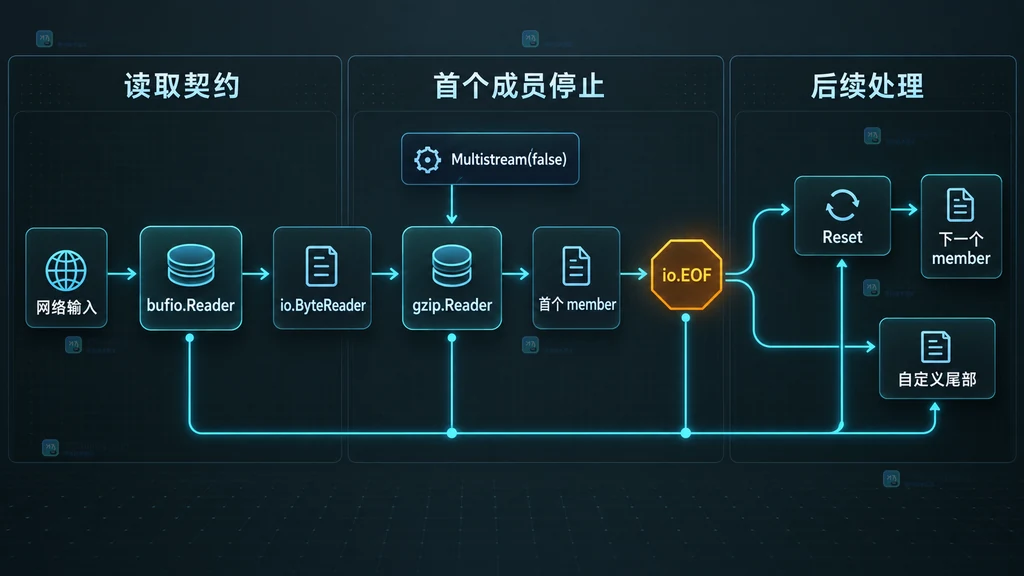
下一个 member 用 Reset,自定义尾部直接读 br
如果协议定义的是多个独立 gzip member,需要逐个读取各自的 Header,可以复用同一个 gzip.Reader。每轮读到 EOF 后调用 Reset(br),再重新设置 Multistream(false):
for {
    zr.Multistream(false)

    // 本轮只消费一个 gzip member,并完成校验。
    if _, err := io.Copy(dst, zr); err != nil {
        return fmt.Errorf("解压当前 member: %w", err)
    }

    if err := zr.Reset(br); errors.Is(err, io.EOF) {
        break // 已经没有下一个 gzip member
    } else if err != nil {
        return fmt.Errorf("读取下一个 member: %w", err)
    }
}
如果首个 member 后面是业务协议尾部,就不要调用 Reset,而应按协议直接读取 br。例如先 Peek 固定魔数,再用 io.ReadFull 读取长度字段和正文。这样 gzip 与业务协议的所有字节都经过同一缓冲层,边界才可推导。
上线前检查这四个条件
| 检查项 | 正确标准 | 常见错误 |
|---|---|---|
| 底层能力 | 传入对象实现 io.ByteReader | 直接把只实现 io.Reader 的连接传入 |
| 读取完成 | 持续读取直到 io.EOF | 拿到部分正文就提前停止 |
| 后续入口 | 继续从同一个 bufio.Reader 读取 | 绕过缓冲区回到原始连接 |
| 协议分支 | gzip member 用 Reset,其他数据按协议解析 | 把任意尾部都当成下一个 gzip header |
常见问题 1:调用 Close 能代替读到 EOF 吗?
不能。官方文档说明,只有把 Reader 完整消费到 EOF,gzip 校验和才会被验证;Close 也不会关闭底层 reader。
常见问题 2:bytes.Reader 还需要再包 bufio.Reader 吗?
通常不需要,*bytes.Reader 本身实现了 ReadByte。但网络连接、HTTP Body 或自定义 Reader 是否实现该接口要单独确认;不确定时统一包装成 bufio.Reader 更稳妥。
所以,“关闭多流”解决的是 gzip member 级别的停止策略,“实现 ByteReader 并复用同一缓冲区”解决的才是底层字节边界。把这两个层次分开,gzip 后拼接自定义协议、逐 member 解包和长连接复用都会稳定很多。
-
502 收藏
-
502 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
221 收藏
-
278 收藏
-
262 收藏
-
358 收藏
-
320 收藏
-
209 收藏
-
347 收藏
-
139 收藏
-
303 收藏
-
143 收藏
-
495 收藏
-
422 收藏
-
- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-
- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-
- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-
- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-
- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习