
RAG 重排器的候选数量和最终 TopK 怎么设置
来源:17golang原创
时间:2026-09-27 21:46:01 468浏览 收藏
RAG 重排器的参数最好拆成两个:candidate_k 是首阶段交给重排器的候选数量,final_top_k 是重排后真正进入大模型上下文的数量。一个实用起点是前者取 50~100,后者取 4~8,再根据召回率、答案正确率、延迟和 Token 成本调整。两者不能共用一个值,也不能只凭感觉调大。
官方资料:https://www.sbert.net/examples/cross_encoder/applications/README.html
- 先保证
candidate_k足够大,使相关片段有机会进入重排。 - 再压缩
final_top_k,避免低价值片段稀释上下文。 - 数值没有通用答案,应按查询集、文档粒度和延迟预算联合评估。
先分开候选数量和最终 TopK
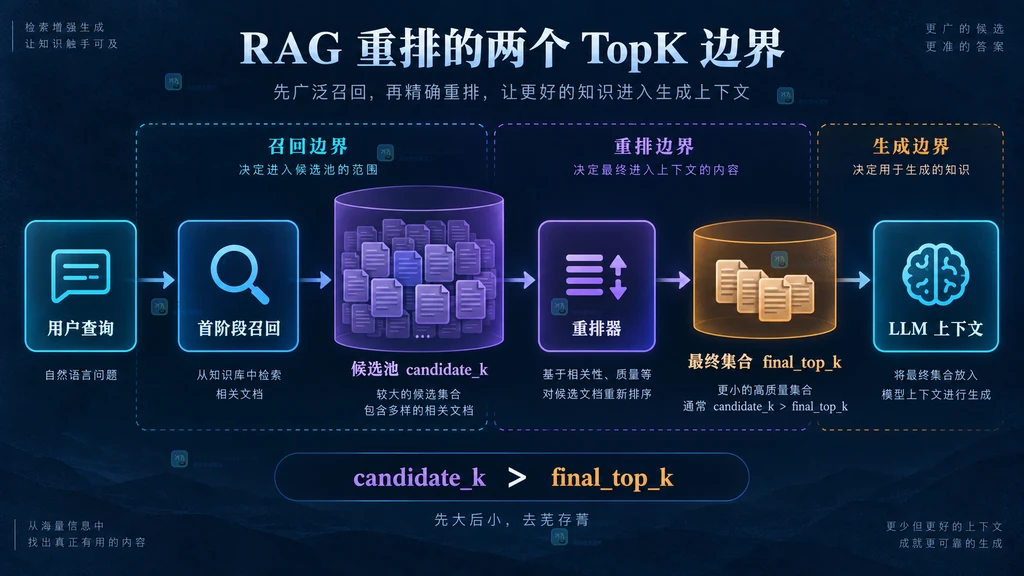
首阶段检索追求速度和召回,重排器追求更精细的相关性判断。Sentence Transformers 的 Retrieve & Re-Rank 示例先用高效检索器取得较大的候选集合,再让 Cross-Encoder 处理;官方示例使用 Top-100 候选,说明 100 是一种工程示范,不是所有系统都必须照搬的固定值。
candidate_k 太小,真正相关的片段根本进不了重排器,后面再强的模型也救不回来;final_top_k 太大,则会把相似重复、边缘相关甚至冲突片段塞给大模型。基本约束是 candidate_k >= final_top_k,并且通常应明显大于后者。
用任务类型确定第一组起点
| 任务 | candidate_k 起点 | final_top_k 起点 |
|---|---|---|
| 短问答、事实查询 | 30~50 | 3~5 |
| 长文归纳、跨段回答 | 80~150 | 6~10 |
| 混合检索、多来源核对 | 100~200 | 8~12 |
这些范围只是实验起点。文档切片越短、同义表达越多,候选池通常需要越大;上下文窗口并不等于应该塞满,最终数量要服从回答所需证据数。若一个事实只需要一段明确证据,保留十几个近似片段往往会增加噪声。
用三组指标逐轮收敛
第一组看重排前的 Recall@candidate_k 或命中率。如果相关片段经常不在候选池,先增大候选数量或改进混合检索。第二组看重排后的 MRR、NDCG 与前几名命中率,用来判断排序模型是否真的把正确片段推到前面。第三组看最终答案正确率、引用覆盖率、p95 延迟和 Token 成本。
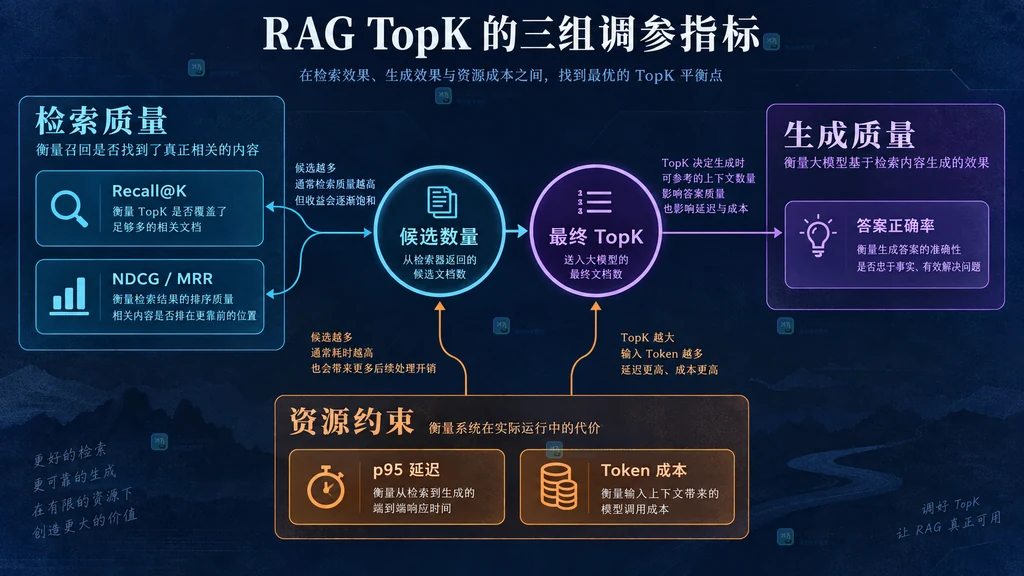
推荐固定一组代表性查询,先保持 final_top_k 不变,只扫描 30、50、80、100 等候选数量;找到召回收益开始变平的位置后,再固定候选数量扫描最终 TopK。这样能判断收益来自召回还是上下文,而不是把两个变量混在一次实验里。
把参数和阈值写进可观察代码
def retrieve_and_rerank(query, candidate_k=80, final_top_k=6):
    if final_top_k > candidate_k:
        raise ValueError("final_top_k 不能大于 candidate_k")

    # 首阶段多召回,优先保护相关片段的入选机会
    candidates = retriever.search(query, top_k=candidate_k)
    pairs = [(query, item.text) for item in candidates]

    # 重排分数只负责当前查询下的相对排序
    scores = reranker.predict(pairs)
    ranked = sorted(zip(candidates, scores),
                    key=lambda pair: pair[1], reverse=True)

    # 只把最终少量证据交给生成模型
    return [item for item, _ in ranked[:final_top_k]]
日志至少记录查询、两个 K、候选是否命中、重排名次、生成耗时与输入 Token。若还要设置分数阈值,不要直接复制其他项目的数值:重排分数通常依查询和模型而变,应先收集代表性查询与“刚好相关”的边界样本,再校准阈值。排查时遵循“先看召回是否进入候选池,再看排序,最后看生成”的顺序,定位会快很多。
候选数量越大,答案一定越好吗?
不一定。候选池扩大能提高召回上限,但也会线性增加重排计算,并引入更多难区分的近似片段。召回曲线变平后继续增加通常得不偿失。
最终 TopK 能直接等于上下文窗口上限吗?
不建议。窗口能容纳不代表内容都有价值。应以完成回答所需的独立证据数为核心,同时限制重复片段和冲突信息。
-
174 收藏
-
101 收藏
-
419 收藏
-
453 收藏
-
191 收藏
-
268 收藏
-
206 收藏
-
458 收藏
-
478 收藏
-
477 收藏
-
113 收藏
-
438 收藏
-
412 收藏
-
233 收藏
-
354 收藏
-
394 收藏
-
385 收藏
-
- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-
- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-
- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-
- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-
- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习