
MySQL EXPLAIN FORMAT=JSON 读取访问路径的操作清单
来源:17golang原创
时间:2026-09-28 21:16:23 243浏览 收藏
我第一次认真读 EXPLAIN FORMAT=JSON 时,最大的误区是从 query_cost 开始找答案。数字很醒目,却不能单独说明索引是否合理。更稳的读法是先找到每张表的访问节点,再把访问类型、候选索引、实际索引、估算行数和条件落点串起来看。
- 先确认 JSON 格式版本,再从
query_block定位表节点。 - 联读
access_type、possible_keys、key、used_key_parts。 - 用
rows_examined_per_scan、rows_produced_per_join和filtered判断估算选择性。 - 检查
attached_condition、using_index、排序和临时表标记。 - 成本只是优化器估算;最终还要用真实执行信息和业务指标验证。
官方资料:MySQL 8.4 EXPLAIN Statement、EXPLAIN Output Format。
先确认输出版本与检查边界
最小命令就是:
EXPLAIN FORMAT=JSON
SELECT o.id, o.created_at
FROM orders AS o
WHERE o.customer_id = 42
  AND o.created_at >= '2026-09-01';
MySQL 8.4 支持两种 JSON 输出版本:默认的版本 1 保留传统 JSON 层级;把系统变量 explain_json_format_version 设为 2 后,输出会以访问路径为中心。团队脚本如果会解析字段,必须先固定或记录版本,不能把两套结构混用。
SELECT @@explain_json_format_version;
EXPLAIN FORMAT=JSON SELECT ...;
本文以常见的版本 1 字段名为主。它适合回答“优化器准备怎样访问数据”,但普通 EXPLAIN 不会执行查询,所以行数和成本是估算值,不是实测耗时。
先从根节点找到表访问路径
先展开 query_block。单表查询通常可以直接看到 table;连接查询常见 nested_loop 数组,每个元素对应一个表访问节点。我的习惯是先抄下表名和节点顺序,再读节点内部字段,避免把某个索引信息归到另一张表上。
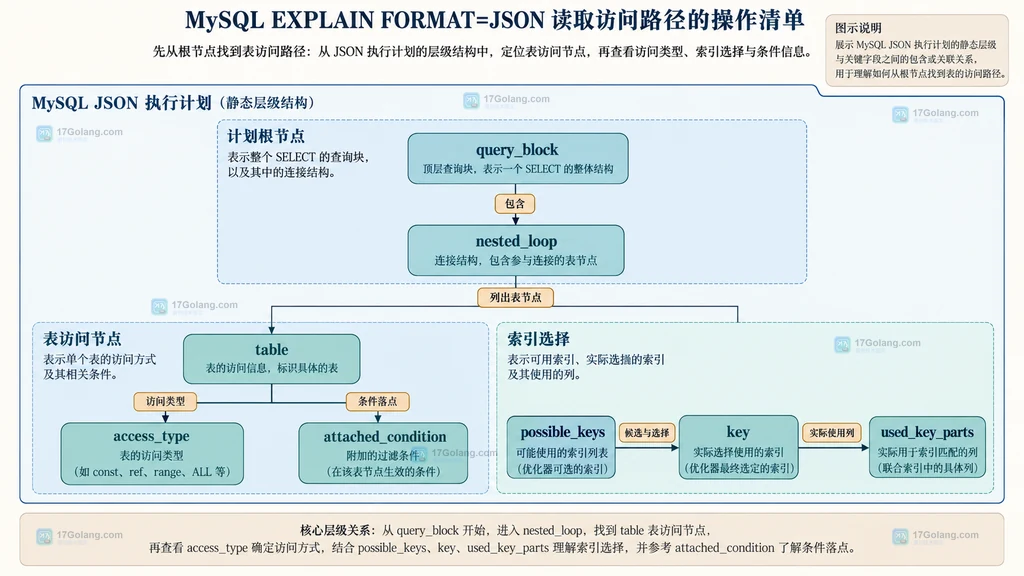
遇到派生表、子查询、分组或排序时,不要只搜索第一个 table。应保持 JSON 层级,分别记录外层查询块、子查询块以及 grouping_operation、ordering_operation 等包装节点。层级本身就是“这个动作属于谁”的证据。
把访问类型和索引选择放在一起看
表节点里最值得先读的是以下字段:
| 字段 | 要回答的问题 | 常见误判 |
|---|---|---|
access_type | 优化器按什么方式访问表 | 看到 ALL 就立即认定错误,小表全扫可能合理 |
possible_keys | 哪些索引具备候选资格 | 把候选索引当成已经使用 |
key | 最终选择了哪个索引 | 只看索引名,不看使用了哪些列 |
used_key_parts | 联合索引实际用到哪些键列 | 认为命中联合索引就等于全部列都生效 |
key_length | 使用键值的长度信息 | 脱离类型、字符集和可空性直接比较大小 |
ref | 索引查找与常量或前序列如何关联 | 忽略连接列的类型和字符集差异 |
一个可操作的判断是:possible_keys 有目标索引而 key 没选它,先查统计信息、选择性和成本;key 选中了联合索引但 used_key_parts 较短,再检查最左前缀、范围条件之后的列以及表达式是否与索引定义一致。不要只凭“索引存在”下结论。
把估算数字变成排查线索
rows_examined_per_scan 是每次扫描预计检查的行数,rows_produced_per_join 是当前节点在连接中预计产生的行数,filtered 表示条件过滤后预计保留的百分比。三者应放在同一个表节点内联读。
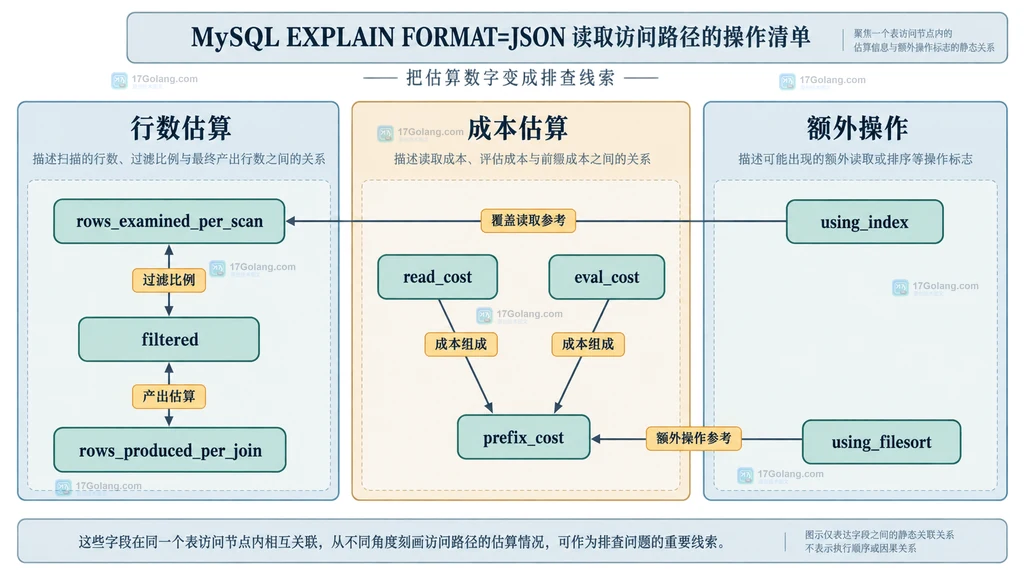
例如,预计扫描行数很大、filtered 又很低,通常说明大量数据在读取后才被条件淘汰。这不是自动等于“缺索引”,但值得继续检查条件能否进入索引、统计信息是否过旧、字段类型是否发生隐式转换。连接查询还要看这个估算是否在后续节点被放大。
cost_info 中常见 read_cost、eval_cost 和累计性质的 prefix_cost。这些值用于优化器内部比较候选计划,不是毫秒,也不适合跨机器、跨版本直接比较。最有价值的对比是在同一环境、同一统计信息背景下,对修改前后的候选计划做相对判断。
检查条件落点与额外操作
attached_condition 表示附着在当前表节点上的条件。它可以帮助确认谓词落在哪个节点,但不能只凭这一项断言条件是在存储引擎层还是服务器层完成。索引使用、索引条件下推和覆盖读取要结合相邻字段与官方输出说明判断。
using_index通常表示所需列可由索引提供,但仍要结合选择列与索引定义确认。using_filesort表示排序不能直接由当前访问路径自然满足;它不等于写入磁盘,也不等于一定很慢。using_temporary_table提示计划包含内部临时表相关操作,应结合分组、去重和排序结构检查。attached_subqueries、select_list_subqueries等子结构要单独读取其查询块,避免漏掉重复执行风险。
我会把这些字段当作“下一步检查入口”,而不是红灯。计划中出现额外操作并不自动证明 SQL 有问题;关键是它处理多少数据,以及是否有更符合业务约束的索引或写法。
按节点记录证据,再决定修改动作
读取完后,可以把每个表节点压缩成一行记录:
表名 | access_type | key / used_key_parts | rows_examined_per_scan
filtered | attached_condition | using_index | using_filesort | prefix_cost
然后按证据决定动作:
- 候选索引为空:确认条件列是否有可用索引,以及表达式、类型转换是否破坏匹配。
- 有候选但未选择:检查选择性、统计信息、回表代价和索引宽度;必要时在测试环境执行
ANALYZE TABLE后重看计划。 - 联合索引只用前几列:检查最左前缀、等值与范围条件的排列。
- 估算行数异常:比较表统计信息、数据分布和真实行数,避免只改 SQL 文本。
- 排序或临时表处理数据过多:检查过滤是否能提前、排序列是否能与索引顺序协调。
修改后做反向验证
调优后的第一步不是宣布“命中索引”,而是重新保存同一条语句的 JSON 计划,逐项比较表节点:访问类型是否改变、used_key_parts 是否更符合条件、预计扫描与产出是否收敛、排序或临时表标记是否变化。
随后再补真实执行证据。MySQL 的 EXPLAIN ANALYZE 会实际运行支持的语句,并提供迭代器的估算与实际行数、时间和循环次数;在生产环境使用前要先评估语句副作用与负载。最终判断仍应结合延迟分布、扫描行数、锁等待和业务吞吐,不能把 JSON 成本值当作耗时。
最终操作清单
- 记录 MySQL 版本与
explain_json_format_version。 - 从
query_block保持层级地定位所有表与子查询节点。 - 联读
access_type、possible_keys、key、used_key_parts。 - 同节点比较扫描行数、产出行数和
filtered。 - 检查
attached_condition、覆盖索引、排序和临时表标记。 - 只在同一环境中相对比较
cost_info。 - 修改后重新采集计划,并用真实执行数据确认收益。
相关问题
possible_keys 有索引,为什么 key 仍然为空?
possible_keys 只表示索引具备候选资格。优化器仍可能认为全表扫描成本更低,或者受统计信息、选择性、类型转换等因素影响而不采用它。
using_filesort 是否一定会落盘?
不一定。它表示排序不是直接按索引顺序取得,排序可以在内存或其他内部机制中完成,不能仅凭这个标记推断磁盘 I/O。
query_cost 可以换算成毫秒吗?
不能。它是优化器成本模型中的相对估算值,适合比较候选计划,不是墙钟时间。真实耗时要看实际执行和监控指标。
-
228 收藏
-
500 收藏
-
252 收藏
-
488 收藏
-
164 收藏
-
303 收藏
-
184 收藏
-
153 收藏
-
110 收藏
-
287 收藏
-
210 收藏
-
333 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习