
MySQL 窗口函数 ROWS 与 RANGE 框架的结果差异
来源:17golang原创
时间:2026-09-29 02:11:41 394浏览 收藏
MySQL 窗口函数中的 ROWS 按排序后的物理行位置划定框架,RANGE 按 ORDER BY 值的范围划定框架。最明显的结果差异出现在排序列有重复值时:RANGE ... CURRENT ROW 会把与当前行排序值相等的全部 peer rows 纳入,而 ROWS ... CURRENT ROW 只截止到当前这一个物理位置。
我遇到过一次日报累计金额“在同一天第一条记录就跳到当天总额”的问题。SQL 没有写错聚合列,真正的原因是只写了窗口内 ORDER BY,却省略了 frame clause。MySQL 在有 ORDER BY 时使用的默认框架等价于 RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW,同一天的记录因此成组进入累计值。
MySQL 8.4 官方文档:https://dev.mysql.com/doc/refman/8.4/en/window-functions-frames.html
重复排序值为什么会让累计结果不同
先准备三条数据,其中两条 score 都是 10。这里的重点不是表结构,而是让窗口排序值产生重复。
-- 创建只用于解释窗口框架的小表
CREATE TABLE frame_demo (
    id INT PRIMARY KEY,
    score INT NOT NULL,
    amount DECIMAL(10, 2) NOT NULL
);

-- 两条 score=10 的记录构成同一个 peer group
INSERT INTO frame_demo (id, score, amount) VALUES
    (1, 10, 100.00),
    (2, 10, 200.00),
    (3, 20,  50.00);
用相同的 ORDER BY score 分别声明 ROWS 和 RANGE:
-- 对比物理行累计与排序值范围累计
SELECT
    id,
    score,
    amount,
    SUM(amount) OVER (
        ORDER BY score
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS sum_by_rows,
    SUM(amount) OVER (
        ORDER BY score
        RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS sum_by_range
FROM frame_demo
ORDER BY score, id;
对于 score=10 的两条记录,RANGE 会把同值行视为一个 peer group,所以两行的 sum_by_range 都是 300。ROWS 则逐个物理位置累计:先进入框架的那条是 100 或 200,第二条才到 300。由于窗口内只按 score 排序,同值行谁先谁后没有保证;查询最外层的 ORDER BY score, id 只负责最终展示顺序,不会反过来改变窗口内的排序定义。
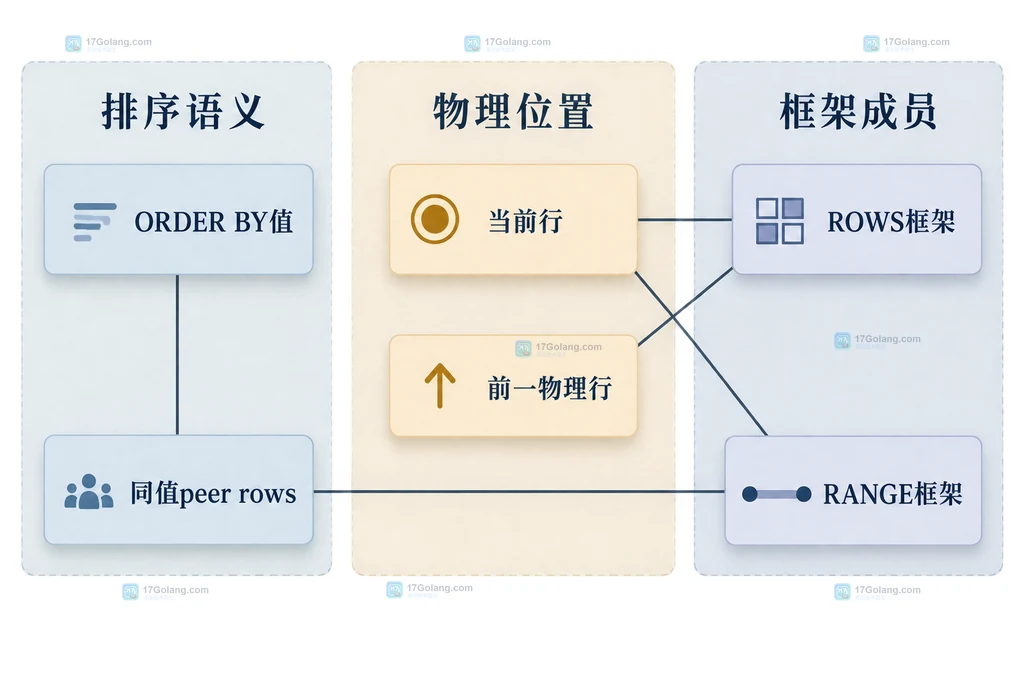
这也是我认为最容易误判的地方:结果表看起来已经按 id 排好了,不代表窗口函数计算时也使用了 id。窗口内和查询最外层的两个 ORDER BY 是不同职责。
按业务语义选择 ROWS 或 RANGE
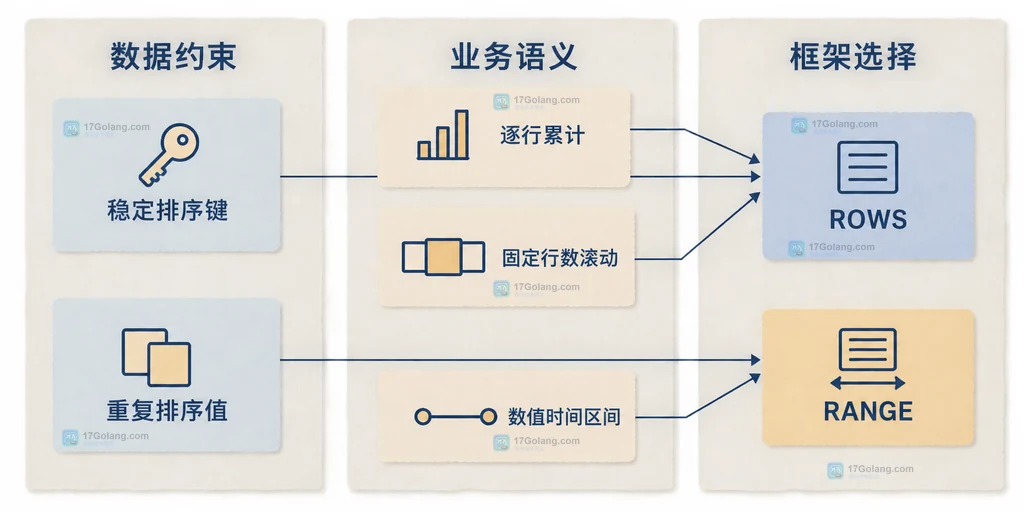
我现在不会先问哪一种“更快”或“更常用”,而是先问业务需要的是位置还是值域。若需求是“当前记录加前两条记录”“逐笔累计”,它描述的是物理行位置,优先选 ROWS。若需求是“最近7天”“价格上下5元”“相同结算日一起累计”,它描述的是排序值范围,优先选 RANGE。
| 业务问题 | 更合适的框架 | 主要原因 |
|---|---|---|
| 逐笔交易累计 | ROWS | 每条记录都应单独推进一次 |
| 当前行与前3行平均值 | ROWS | 窗口大小由行数决定 |
| 同一天记录显示同一累计值 | RANGE | 相同日期属于同一 peer group |
| 当前日期向前7天汇总 | RANGE | 窗口由时间值区间决定 |
| 价格在当前值上下固定区间 | RANGE | 窗口由数值差决定 |
这里还有一个数据密度约束。ROWS BETWEEN 6 PRECEDING AND CURRENT ROW 永远最多考虑当前行与前6个位置,不关心这些记录跨了几天;RANGE BETWEEN INTERVAL 6 DAY PRECEDING AND CURRENT ROW 则关心日期范围,区间内有多少行就纳入多少行。数据稀疏或一天多条时,两者的结果自然会明显不同。
省略框架时,默认值可能改变结果
MySQL 官方文档给出的默认规则很重要:
- 窗口定义含
ORDER BY,但没有 frame clause:默认等价于RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW。 - 窗口定义不含
ORDER BY:整个分区都是 peer rows,默认框架覆盖整个分区。
因此,仅仅为了让结果“看起来稳定”而给窗口新增 ORDER BY,也可能把原来的整分区聚合变成从分区开头到当前 peer group 的累计聚合。我的习惯是:只要函数确实受 frame 影响,就把框架显式写出来,不让默认值承担业务语义。
-- 显式声明逐行累计,避免默认 RANGE 把同值行一起纳入
SELECT
    id,
    score,
    amount,
    SUM(amount) OVER (
        ORDER BY score, id
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_amount
FROM frame_demo
ORDER BY score, id;
上面把 id 加进窗口内排序,目的是为 ROWS 提供稳定的逐行顺序。这样两条 score=10 的记录会按 id 依次进入框架,累计值可以重复得到相同结果。
ROWS 需要稳定排序键
ROWS 的含义依赖“前一行、当前行、后一行”,所以只要 ORDER BY 不能唯一定位顺序,同值行之间的物理次序就可能不确定。对逐笔累计、前后行差值和固定行数滚动平均,这种不确定会直接体现在结果里。
稳定排序通常需要把业务时间与唯一键组合起来:
-- created_at 负责业务顺序,id 负责打破同一时间的并列
SELECT
    id,
    created_at,
    amount,
    AVG(amount) OVER (
        ORDER BY created_at, id
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS moving_avg_3_rows
FROM payments
ORDER BY created_at, id;
这段 SQL 的窗口最多包含3个物理位置。即便同一秒写入多笔交易,id 也会把顺序固定下来。若业务并不认可 id 代表先后关系,就应使用更合适的序列号,而不是为了语法完整随便拼一个列。
添加唯一排序键还有一个容易忽略的后果:如果把同样的 ORDER BY created_at, id 用在 RANGE ... CURRENT ROW,peer rows 需要所有排序表达式都相等。id 唯一时,每个 peer group 通常只剩一行,原本希望“同一时刻一起累计”的语义就会消失。因此,稳定 ROWS 和保留 RANGE 同值组是两个不同目标。
RANGE 更适合数值与时间范围
RANGE 不只是处理重复值。它还可以使用数值偏移或时间间隔,让框架跟随当前排序值移动。MySQL 要求偏移类型与 ORDER BY 表达式匹配:数值范围使用数值排序表达式,时间范围使用时间表达式。
-- 按业务日期计算当前日及前6天的七日金额
SELECT
    sale_date,
    amount,
    SUM(amount) OVER (
        ORDER BY sale_date
        RANGE BETWEEN INTERVAL 6 DAY PRECEDING AND CURRENT ROW
    ) AS amount_last_7_days
FROM daily_sales
ORDER BY sale_date;
若某天有多条记录,它们会共享相同的日期值,并一起落入对应日期范围。若中间某天没有数据,RANGE 仍然按日期边界计算,而不会把更早的一条记录自动补进来。这正是“7天”与“7行”的区别。
-- 按分数值区间统计当前分数及前5分范围内的金额
SELECT
    id,
    score,
    SUM(amount) OVER (
        ORDER BY score
        RANGE BETWEEN 5 PRECEDING AND CURRENT ROW
    ) AS amount_in_score_range
FROM frame_demo
ORDER BY score, id;
使用带偏移的 RANGE 时,应保持窗口内 ORDER BY 聚焦在一个数值或时间表达式上,避免同时混入无关的唯一键破坏值域语义。展示顺序仍可在查询最外层追加其他列。
哪些函数不会按框架改变结果
并非所有窗口函数都使用 frame。MySQL 文档说明,ROW_NUMBER()、RANK()、DENSE_RANK()、LAG()、LEAD() 等函数按整个分区语义工作,即使写了 frame clause 也会忽略它。本文的 ROWS 与 RANGE 差异主要针对会读取当前框架的聚合窗口函数,以及 FIRST_VALUE()、LAST_VALUE()、NTH_VALUE() 等函数。
LAST_VALUE() 尤其容易让人困惑。默认的 RANGE ... CURRENT ROW 只到当前 peer group,不是整个分区末尾;如果要取分区最后一行,应显式写到 UNBOUNDED FOLLOWING。
-- 显式覆盖整个分区,LAST_VALUE 才表示分区末尾值
SELECT
    id,
    score,
    LAST_VALUE(amount) OVER (
        ORDER BY score, id
        ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
    ) AS partition_last_amount
FROM frame_demo
ORDER BY score, id;
落地时的检查清单
- 先写清业务需要的是固定行数、逐行累计,还是数值与时间范围。
- 检查窗口内
ORDER BY是否存在重复值。 - 使用
ROWS时,为同值行补充有业务意义的稳定排序键。 - 使用
RANGE时,确认是否需要 peer rows 一起进入框架。 - 不要依赖默认框架,显式写出起点和终点。
- 区分窗口内排序与结果集最终排序,二者不要互相替代。
- 确认所用窗口函数是否真的读取 frame,避免给排名函数添加无效配置。
我的选择可以归结为一句话:业务说“几行”就用 ROWS,业务说“多大数值区间或多长时间”就用 RANGE;只要排序值可能重复,就必须明确 peer rows 是应该一起计算,还是应该用唯一键逐行推进。
常见问题
ROWS 一定比 RANGE 结果更精确吗?
不是。两者表达的是不同语义。逐笔累计用 ROWS 更准确,按同一日期或值域汇总则 RANGE 更符合业务。精确与否取决于框架是否匹配需求。
为什么只加 ORDER BY,累计值就变了?
因为有 ORDER BY 且省略框架时,默认是从分区开头到当前 peer group 的 RANGE 框架;没有 ORDER BY 时,默认覆盖整个分区。
RANGE CURRENT ROW 是否只包含当前一行?
不是。它包含与当前行在窗口 ORDER BY 上相等的全部 peer rows。只有排序键唯一时,peer group 通常才只有一行。
最近7天能否写成 ROWS BETWEEN 6 PRECEDING?
只有每天恰好一行且没有缺失日期时才可能碰巧相同。一般应使用基于日期的 RANGE INTERVAL,因为 ROWS 计算的是记录位置,不是日历时间。
-
374 收藏
-
499 收藏
-
384 收藏
-
184 收藏
-
265 收藏
-
376 收藏
-
243 收藏
-
228 收藏
-
500 收藏
-
252 收藏
-
488 收藏
-
164 收藏
-
303 收藏
-
184 收藏
-
153 收藏
-
110 收藏
-
287 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习