
Go compress/lzw.NewWriter 怎么选择 LSB 与 MSB 位序
来源:17golang原创
时间:2026-10-04 05:12:56 150浏览 收藏
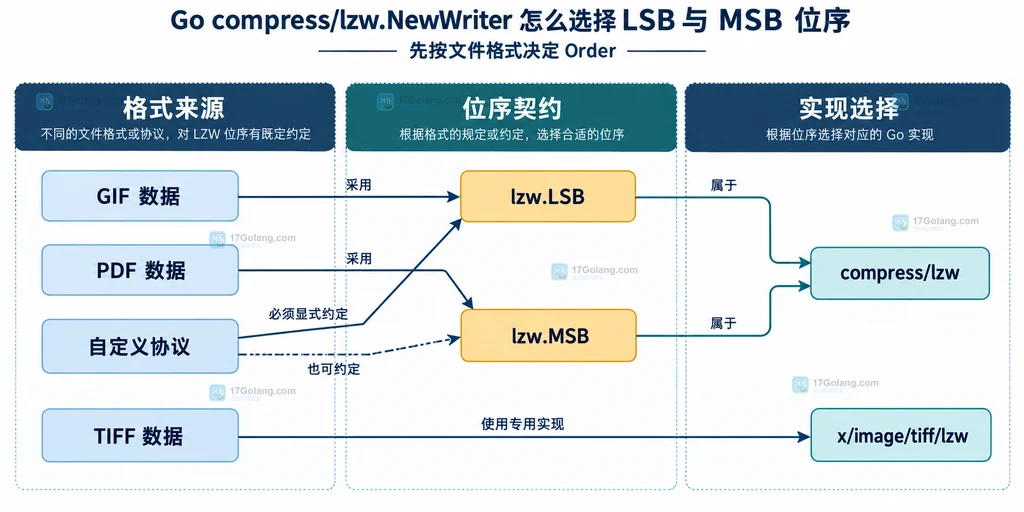
compress/lzw.NewWriter 的 order 不是“选哪个压缩率更高”,也不是跟随 CPU 大小端。选择规则只有一个:服从目标文件格式或双方协议。GIF 风格的 LZW 代码按最低有效位优先打包,使用 lzw.LSB;PDF 风格使用最高有效位优先,选择 lzw.MSB;自定义协议可以任选一种,但写端和读端必须把它写进协议契约。
还有一个容易踩的坑:Go 标准库虽然提供 MSB,但 TIFF 的 LZW 还有算法差异,不能简单把 compress/lzw 加上 MSB 就当成完整 TIFF 实现。处理 TIFF 应优先使用 golang.org/x/image/tiff/lzw 或更上层的 TIFF 编解码器。
Go 官方文档:https://pkg.go.dev/compress/lzw
项目目标:把位序变成显式参数
我第一次接触这个参数时,也容易把 LSB/MSB 理解成输入字节顺序。看过标准库接口和源码后,区别就清楚了:LZW 先产生可变宽度的“代码”,Order 决定这些代码的位如何装进输出字节。原始输入仍然是普通 []byte,不会因为选择 LSB 就把每个字节反转。
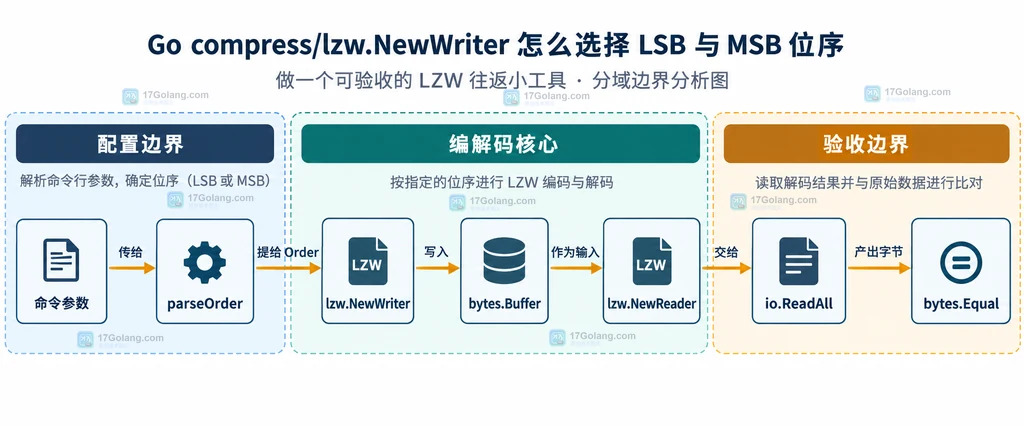
我们做一个很小但完整的命令行工具:
- 通过
-order=lsb或-order=msb选择位序; - 把一段文本压缩为 LZW 码流;
- 使用相同参数解压;
- 用
bytes.Equal验收解压结果; - 输出压缩字节的十六进制,直观看到两种位序生成的码流不同。
这个小工具不负责组装完整 GIF、PDF 或 TIFF 文件,它只用来确认 compress/lzw 的参数契约。
环境准备:先确定 Order 和 litWidth
NewWriter(w, order, litWidth) 的两个关键参数需要成对考虑。order 决定位打包顺序,litWidth 是字面量代码的初始位宽,允许范围是 2 到 8,通常处理任意字节时取 8。写入的每个字节必须小于 1 ,读端还必须使用相同的 litWidth。
| 数据来源 | 建议选择 | 原因或限制 |
|---|---|---|
| GIF 图像数据中的 LZW | lzw.LSB | Go 文档明确说明 GIF 使用最低有效位优先 |
| PDF 的 LZWDecode 数据 | lzw.MSB | Go 标准库实现覆盖 PDF 风格的 LZW |
| 自定义二进制协议 | LSB 或 MSB 均可 | 必须在协议中固定,并保证生产者与消费者一致 |
| TIFF LZW | x/image/tiff/lzw | TIFF 存在相对标准 LZW 的算法差异,仅选 MSB 不足以保证兼容 |
如果你操作的是完整 GIF 文件,通常直接使用 image/gif 更稳妥;如果你在 PDF 库内部实现过滤器,则要同时遵循 PDF 容器对流、参数和结束条件的规定。
核心代码:完成一组可复用的编解码函数
先把编码和解码封装起来。这里最重要的不是代码长度,而是两个资源边界:写端一定要调用 Close 刷出残留位和 EOF 代码,读端也要关闭读取器;任何一个阶段的错误都不能忽略。
package main

import (
	"bytes"
	"compress/lzw"
	"encoding/hex"
	"errors"
	"flag"
	"fmt"
	"io"
	"os"
	"strings"
)

func parseOrder(value string) (lzw.Order, error) {
	// 位序来自文件格式或协议,这里只把显式参数映射为标准库常量。
	switch strings.ToLower(value) {
	case "lsb":
		return lzw.LSB, nil
	case "msb":
		return lzw.MSB, nil
	default:
		return 0, fmt.Errorf("未知位序 %q,只支持 lsb 或 msb", value)
	}
}

func encode(src []byte, order lzw.Order, litWidth int) ([]byte, error) {
	var dst bytes.Buffer
	w := lzw.NewWriter(&dst, order, litWidth)

	if _, err := w.Write(src); err != nil {
		// 写入失败后仍尝试关闭,主错误保持为 Write 返回值。
		_ = w.Close()
		return nil, fmt.Errorf("写入 LZW 数据: %w", err)
	}
	// Close 会刷新尚未凑满一个字节的位,并写入结束代码。
	if err := w.Close(); err != nil {
		return nil, fmt.Errorf("关闭 LZW writer: %w", err)
	}

	// 复制结果,避免调用方意外依赖 Buffer 的内部存储。
	return append([]byte(nil), dst.Bytes()...), nil
}

func decode(encoded []byte, order lzw.Order, litWidth int) ([]byte, error) {
	r := lzw.NewReader(bytes.NewReader(encoded), order, litWidth)
	plain, readErr := io.ReadAll(r)
	closeErr := r.Close()
	if readErr != nil {
		return nil, fmt.Errorf("读取 LZW 数据: %w", readErr)
	}
	if closeErr != nil {
		return nil, fmt.Errorf("关闭 LZW reader: %w", closeErr)
	}
	return plain, nil
}

func run(orderName, text string) error {
	order, err := parseOrder(orderName)
	if err != nil {
		return err
	}

	const litWidth = 8 // 8 位覆盖任意单字节输入。
	src := []byte(text)
	encoded, err := encode(src, order, litWidth)
	if err != nil {
		return err
	}
	decoded, err := decode(encoded, order, litWidth)
	if err != nil {
		return err
	}
	if !bytes.Equal(decoded, src) {
		return errors.New("往返验收失败:解压结果与原文不同")
	}

	fmt.Printf("order=%s input=%d compressed=%d\n", orderName, len(src), len(encoded))
	fmt.Printf("hex=%s\n", hex.EncodeToString(encoded))
	fmt.Printf("roundtrip=%t text=%q\n", true, decoded)
	return nil
}

func main() {
	orderName := flag.String("order", "lsb", "LZW 位序:lsb 或 msb")
	text := flag.String("text", "TOBEORNOTTOBEORTOBEORNOT", "待压缩文本")
	flag.Parse()

	// 统一从一个出口报告错误,便于命令行和脚本判断退出状态。
	if err := run(*orderName, *text); err != nil {
		fmt.Fprintln(os.Stderr, err)
		os.Exit(1)
	}
}
NewWriter 本身不返回 error,参数或输入不合法时,错误会从后续 Write 或 Close 暴露出来。同样,NewReader 也把大部分格式错误留到读取阶段,因此示例在每个 I/O 边界都检查错误。
命令行集成:让选择可见而不是写死
把上面的文件保存为 main.go 后,可以分别生成两种码流。两次运行使用相同原文和 litWidth=8,区别只有 Order。
# 生成 GIF 风格的最低有效位优先 LZW 码流,并用同一位序解压验收。
go run . -order=lsb -text='TOBEORNOTTOBEORTOBEORNOT'

# 生成 PDF 风格的最高有效位优先 LZW 码流,并用同一位序解压验收。
go run . -order=msb -text='TOBEORNOTTOBEORTOBEORNOT'
两个命令都应该显示 roundtrip=true,但十六进制压缩结果不同。这恰好说明:LSB 和 MSB 都可以形成自洽的 LZW 码流,真正决定“哪个正确”的,是接收方或文件格式期待哪一种。
本地运行时再做一组反向验证
只验证“同一种位序可以往返”还不够。为了捕获集成时的配置漂移,可以在测试中故意让读取端使用相反位序。错误位序可能导致读取错误,也可能产生不能通过原文比较的结果;测试不要依赖某一条固定错误消息。
func opposite(order lzw.Order) lzw.Order {
	// 测试辅助函数只在 LSB 与 MSB 两个已知常量之间切换。
	if order == lzw.LSB {
		return lzw.MSB
	}
	return lzw.LSB
}

func rejectMismatchedOrder(src []byte, order lzw.Order) error {
	encoded, err := encode(src, order, 8)
	if err != nil {
		return err
	}
	decoded, readErr := decode(encoded, opposite(order), 8)
	// 读失败或内容不相等都表示错配被测试发现。
	if readErr == nil && bytes.Equal(decoded, src) {
		return errors.New("错误位序意外通过验收")
	}
	return nil
}
生产协议还应携带算法版本、位序和 litWidth,不要靠消费者“试两次”。盲试会掩盖配置错误,也可能让一段偶然可解析的数据进入后续业务。
TIFF 集成为什么不能只选 MSB
标准库文档一方面说明 MSB 是 TIFF/PDF 使用的位序,另一方面明确指出 TIFF 使用的是相似但不兼容的 LZW 版本。关键差异不只是位从哪一端写入,还包括代码宽度增长时机等算法细节。
TIFF LZW 官方扩展包:https://pkg.go.dev/golang.org/x/image/tiff/lzw
该包专门说明它实现 TIFF 所用 LZW,并包含相对标准 LZW 的 “off by one” 差异。实际业务如果要读写完整 TIFF,优先使用 golang.org/x/image/tiff 上层能力;不要手工拼 TIFF 容器,也不要因为看到 lzw.MSB 就跳过兼容性判断。
验收清单:位序之外还要检查什么
- 格式来源:先确认数据属于 GIF、PDF、自定义协议还是 TIFF。
- 位序一致:写端和读端使用相同
lzw.Order。 - 字面量位宽一致:
litWidth在 2 到 8 之间,且两端相同。 - 输入范围:每个输入字节都小于
1 ;通用字节数据通常使用 8。 - 关闭 writer:写入后检查
Close,否则尾部位与结束代码可能没有完整输出。 - 内容验收:测试解压结果与原始字节相等,不只检查读取有没有报错。
- 容器边界:
compress/lzw只处理 LZW 码流,不替代 GIF、PDF 或 TIFF 的完整容器编码。 - TIFF 特例:使用专用 TIFF LZW 实现,不把标准库 MSB 当作完整兼容开关。
常见问题
LSB 和 MSB 会改变压缩率吗?
它们主要改变代码位进入字节流的顺序,不是压缩策略选项。同一组 LZW 代码通常不会因为位序选择而获得有意义的压缩率优势,选择应服从格式兼容性。
LSB 是否等于 little-endian?
这里不是 CPU 整数的字节序。lzw.Order 描述可变宽 LZW 代码的位打包顺序,输入字节本身不会被反转。
litWidth 为什么通常是 8?
8 位可以表示 0 到 255 的任意字节。较小位宽只适合字面量集合确实受限的格式场景,而且所有输入字节都必须小于 1 。
解压端位序写错会发生什么?
读取器会按错误边界解释代码,可能返回格式错误,也可能得到错误内容。可靠测试应同时检查读取错误和解压字节是否与原文相同。
最终选择可以压缩成一句话:GIF 选 lzw.LSB,PDF 选 lzw.MSB,自定义协议把位序和 litWidth 写进契约,TIFF 使用专用实现。不要让机器大小端、个人偏好或一次偶然成功的往返测试替你决定格式。
-
427 收藏
-
371 收藏
-
171 收藏
-
396 收藏
-
132 收藏
-
125 收藏
-
361 收藏
-
177 收藏
-
301 收藏
-
239 收藏
-
194 收藏
-
466 收藏
-
120 收藏
-
337 收藏
-
130 收藏
-
408 收藏
-
327 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习