
Go json.Decoder.InputOffset 怎么定位解析错误附近字节
来源:17golang原创
时间:2026-10-04 14:50:10 298浏览 收藏
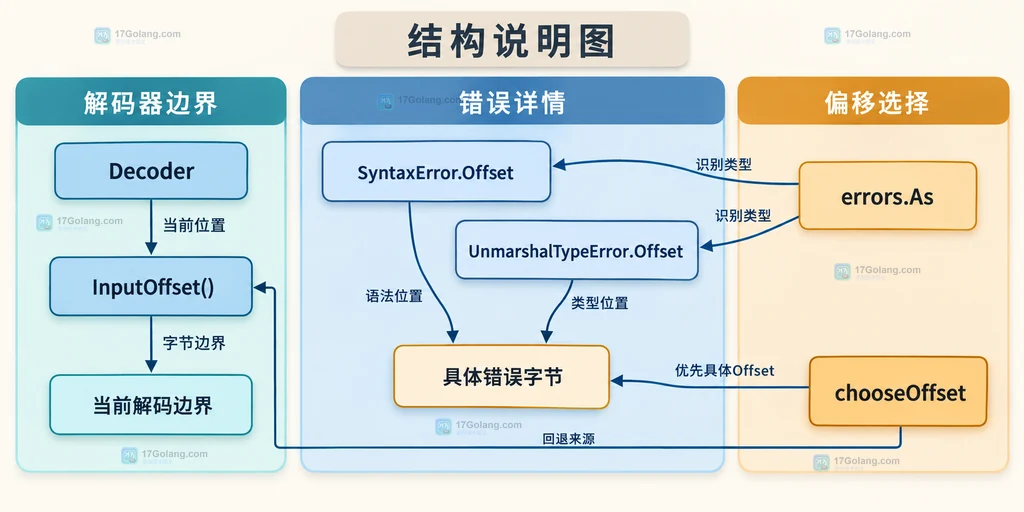
json.Decoder.InputOffset() 返回的是当前 Decoder 在输入流中的字节偏移:它位于最近一次成功返回的 token 末尾,也位于下一个 token 的开头。要定位解析错误附近的原始字节,可以保留输入的 []byte,在失败后取得偏移,再截取偏移前后的一小段窗口。
不过有一个关键边界:InputOffset 是 Decoder 的当前位置,不保证等于每一种 Decode 错误的精确发生位置。遇到 *json.SyntaxError 或 *json.UnmarshalTypeError 时,应优先使用错误对象自己的 Offset;其余情况再回退到 InputOffset。
官方文档:https://pkg.go.dev/encoding/json
InputOffset 表示当前解码边界
官方定义强调了两个词:byte offset 和 current decoder position。这意味着它不是 rune 序号、字符序号,也不是底层 io.Reader 已经读取的总量。Decoder 会自行缓冲,并可能从 Reader 预读超过当前 JSON 值的数据,因此不能用 Reader 计数替代 InputOffset。
| 位置来源 | 适用场景 | 含义 |
|---|---|---|
Decoder.InputOffset() | Token 流、连续 JSON 值、通用回退 | 当前解码边界 |
SyntaxError.Offset | JSON 语法错误 | 读取到发生语法错误处时的字节数 |
UnmarshalTypeError.Offset | JSON 值不能赋给 Go 类型 | 读取到类型不匹配处时的字节数 |
旧写法的问题是丢失原始字节
很多代码直接把请求体交给 Decoder,然后只记录 err.Error()。这样能知道“为什么失败”,却无法稳定展示错误附近的输入。更实用的改法是先取得受大小限制的原始字节,再用 bytes.NewReader 创建 Decoder。
func decodeConfig(data []byte, dst any) (*json.Decoder, error) {
    // 保留 data,解析失败后才能按字节偏移截取上下文。
    dec := json.NewDecoder(bytes.NewReader(data))
    dec.DisallowUnknownFields()

    // 返回 Decoder,让调用方在失败后读取当前位置。
    if err := dec.Decode(dst); err != nil {
        return dec, err
    }
    return dec, nil
}
对 HTTP 请求体不要无上限地读入内存。可以先用 http.MaxBytesReader 或 io.LimitReader 限制大小,再保存这份有限字节。本文只讨论偏移定位,大小上限应由接口协议决定。
优先读取具体错误的 Offset
下面的函数把选择规则集中起来:语法错误优先,其次是类型错误,最后才使用 InputOffset。这样既保留了 InputOffset 对流式边界的价值,也不会把它误当成所有错误的精确坐标。
type OffsetInfo struct {
    Offset int64
    Source string
}

func chooseOffset(dec *json.Decoder, err error) OffsetInfo {
    info := OffsetInfo{
        Offset: dec.InputOffset(),
        Source: "Decoder.InputOffset",
    }

    var syntaxErr *json.SyntaxError
    if errors.As(err, &syntaxErr) {
        // 语法错误对象记录了更具体的读取位置。
        info.Offset = syntaxErr.Offset
        info.Source = "SyntaxError.Offset"
        return info
    }

    var typeErr *json.UnmarshalTypeError
    if errors.As(err, &typeErr) {
        // 类型不匹配也带有独立的字节偏移。
        info.Offset = typeErr.Offset
        info.Source = "UnmarshalTypeError.Offset"
    }
    return info
}
errors.As 比直接类型断言更稳妥,因为错误可能被上层用 fmt.Errorf("...: %w", err) 包装。对于 DisallowUnknownFields 返回的未知字段错误,没有公开的专用 Offset 字段,因此只能把 InputOffset 当作附近边界,而不是声称它精确指向字段名。
按偏移截取安全的字节窗口
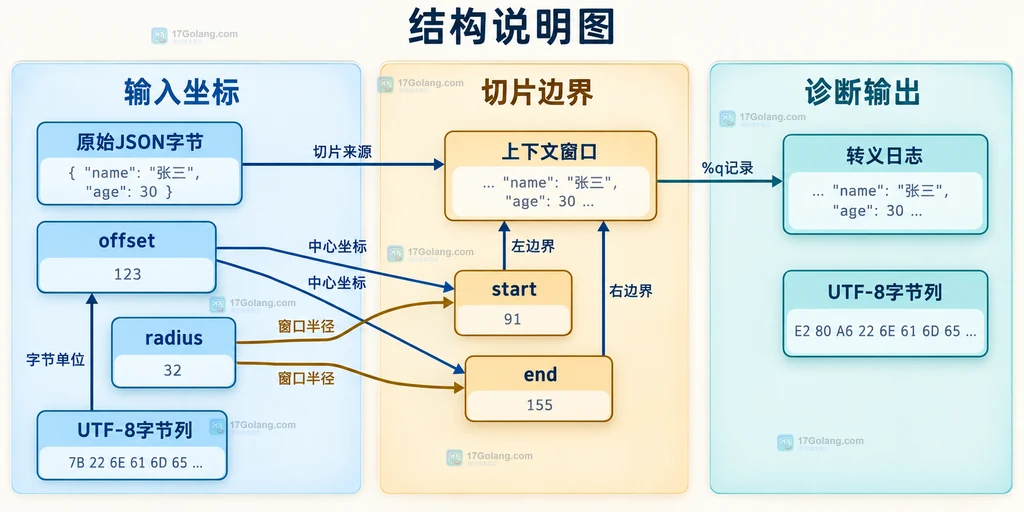
SyntaxError.Offset 和 UnmarshalTypeError.Offset 的注释都是“读取 Offset 个字节后发生错误”。为了把窗口中心放在相关字节附近,通常把它换成零基索引时减 1;同时必须把索引钳制到 [0, len(data)],避免错误本身又触发切片越界。
func contextWindow(data []byte, offset int64, radius int) []byte {
    if len(data) == 0 {
        return nil
    }
    if radius  0 {
        pos-- // “读取了 N 个字节”换算为零基附近索引。
    }
    if pos = len(data) {
        pos = len(data) - 1
    }

    start := pos - radius
    if start  len(data) {
        end = len(data)
    }

    // 复制窗口,避免调用方意外持有并修改原始缓冲区。
    return append([]byte(nil), data[start:end]...)
}
日志中建议用 %q 输出 []byte,这样换行、制表符和不可见字节会被转义,不会破坏日志格式。完整调用可以保持很紧凑:
func decodeWithContext(data []byte, dst any) error {
    dec := json.NewDecoder(bytes.NewReader(data))
    if err := dec.Decode(dst); err != nil {
        info := chooseOffset(dec, err)
        near := contextWindow(data, info.Offset, 24)

        // %q 让不可见字符以转义形式进入日志。
        return fmt.Errorf(
            "decode JSON: %w; offset=%d; source=%s; near=%q",
            err, info.Offset, info.Source, near,
        )
    }
    return nil
}
用一个错误样本检查定位逻辑
下面这段 JSON 在数组末尾多了一个逗号。严格 JSON 不支持注释,所以示例块保持原样;需要关注的是 ] 前面的逗号。
{
  "name": "alpha",
  "items": [1, 2,]
}
func main() {
    data := []byte(`{
  "name": "alpha",
  "items": [1, 2,]
}`)

    var dst struct {
        Name  string `json:"name"`
        Items []int  `json:"items"`
    }

    // 返回错误中会包含来源、字节偏移和转义后的附近窗口。
    if err := decodeWithContext(data, &dst); err != nil {
        log.Print(err)
    }
}
不要在文章或监控规则里硬编码某个示例偏移数字;空格、缩进、换行风格或前置 JSON 值都会改变绝对字节位置。可靠做法是始终从错误对象或当前 Decoder 读取偏移。
流式输入还要注意三个边界
InputOffset 是整个输入流的绝对字节位置
当一个 Reader 中连续包含多个 JSON 值时,第二个值的偏移不会从零重新开始。保存完整原始数据时可以直接切片;若只保留分块缓冲,则还要记录该块在总流中的起始偏移。
Reader 的已读字节数可能大于 InputOffset
json.Decoder 有自己的缓冲区,可能预读后续数据。官方也明确说明 NewDecoder 可能从 Reader 读取超过当前 JSON 值所需的数据。因此基于 Reader 包装器统计的读取量,只能说明底层传输了多少字节,不能替代当前解码位置。
字节列不等于人眼字符列
UTF-8 中文通常占多个字节。InputOffset 和错误 Offset 都是字节单位;如果要转换成编辑器显示的“第几行第几列”,应先按字节找到行,再根据编辑器规则计算 rune 列或可视列。日志里同时保留绝对字节 offset 最稳妥。
迁移清单
- 把只记录
err的解析入口改为同时保留受大小限制的原始[]byte。 - 语法错误优先使用
SyntaxError.Offset,类型错误优先使用UnmarshalTypeError.Offset。 - 其他错误使用
Decoder.InputOffset(),并把它描述为附近解码边界。 - 把“读取字节数”转换为零基索引时处理减 1,并对 start、end 做边界钳制。
- 日志使用
%q或等价转义方式,避免换行和控制字符破坏日志。 - 多值流记录分块起始偏移;不要用 Reader 读取量替代 Decoder 位置。
常见问题
InputOffset 能直接当成切片下标吗?
不建议直接使用。它是字节边界;具体错误 Offset 又表示“读取 Offset 个字节后发生错误”。先明确来源,再换算并钳制到合法范围。
为什么 Decode 失败后 InputOffset 可能看起来偏早?
因为它报告当前 Decoder 位置,而读取一个完整 JSON 值时的扫描错误不一定把当前位置推进到具体出错字节。语法错误应读取 SyntaxError.Offset。
只拿到 io.Reader,怎么展示错误附近内容?
需要在解析前引入受限缓存,或者实现带容量上限的环形窗口并记录绝对起始位置。Decoder 的 Buffered 只暴露尚未被 Decode 或 Token 消费的已缓冲数据,不能自动还原全部历史输入。
结论
InputOffset 最适合回答“Decoder 当前走到哪个字节边界”,而 SyntaxError.Offset 与 UnmarshalTypeError.Offset 更适合回答“具体错误发生在读取到哪个字节时”。保留原始字节、按错误类型选择偏移、再截取经过钳制的前后窗口,就能得到既紧凑又不会越界的 JSON 解析诊断信息。
-
344 收藏
-
159 收藏
-
352 收藏
-
156 收藏
-
285 收藏
-
473 收藏
-
398 收藏
-
367 收藏
-
383 收藏
-
446 收藏
-
Golang · Go教程 | 4小时前 | Go教程 · database/sql · Go database/sql 动态查询 sql.Rows.ColumnTypes ColumnType DatabaseTypeName ScanType122 收藏
-
451 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习