
MySQL 怎么从 Performance Schema 汇总近期死锁
来源:17golang原创
时间:2026-10-04 16:08:36 372浏览 收藏
线上告警只告诉我“Deadlock found when trying to get lock”,最初我会立刻去查 data_lock_waits,结果经常是空表。原因不是 Performance Schema 失效,而是 InnoDB 检测到死锁后会立即回滚一个牺牲事务;等人登录数据库时,那个等待环通常已经消失。
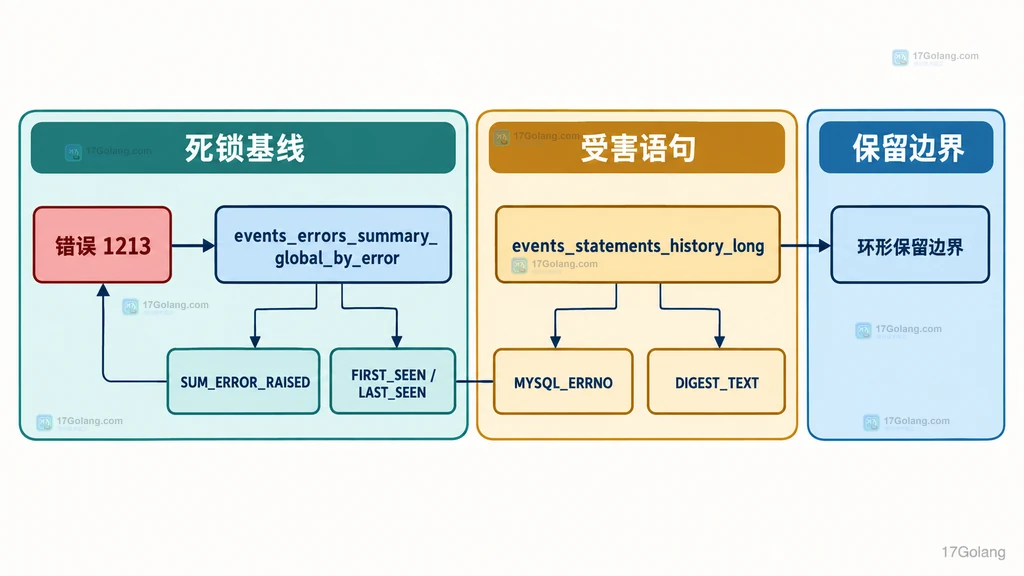
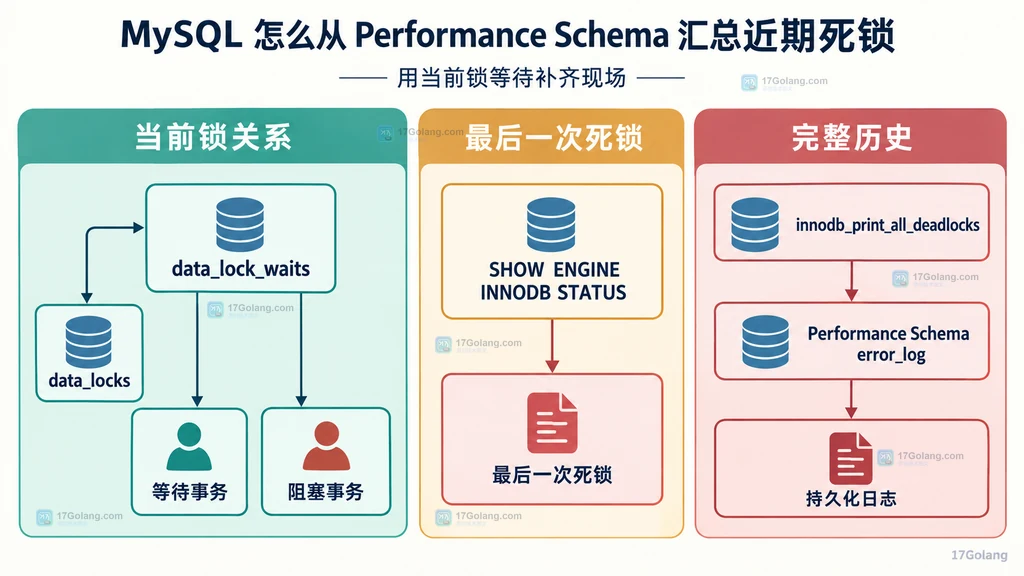
要汇总“近期死锁”,应把证据拆成三层:events_errors_summary_*_by_error 统计错误 1213 的次数和最近出现时间,events_statements_history_long 保存环形缓冲区内的受害语句,data_lock_waits 只解释查询当下仍存在的阻塞关系。需要完整死锁图时,再让 innodb_print_all_deadlocks 把详情写入错误日志。MySQL 8.4 官方入口:https://dev.mysql.com/doc/refman/8.4/en/innodb-deadlocks.html
- 先用
ERROR_NUMBER=1213看死锁基线,不要把锁等待超时 1205 混进来。 - 再从
events_statements_history_long按DIGEST_TEXT汇总受害 SQL;它是有容量上限的近期样本,不是永久历史。 data_lock_waits适合补充当前阻塞现场,不能还原已经结束的死锁环。- 需要完整历史时启用
innodb_print_all_deadlocks,并把错误日志纳入持久化采集。
先保护两类关键证据
死锁排查真正要保护的资产有两类。第一类是影响证据:出现了多少次、集中在哪些账号或 SQL 形态、最近一次是什么时候。第二类是因果证据:哪些事务互相持锁、InnoDB 选择了哪个牺牲事务、每个事务当时执行什么语句。Performance Schema 能很好地提供前一类,也能保存部分受害语句和当前锁关系,但它默认不会把每次完整死锁环永久留在历史事件表中。
| 要回答的问题 | 首选来源 | 主要边界 |
|---|---|---|
| 1213 一共出现多少次,最近何时出现 | events_errors_summary_global_by_error | 统计从服务启动或汇总表重置后开始,不是天然的最近 1 小时窗口 |
| 哪些 SQL 反复成为牺牲者 | events_statements_history_long | 只保留全局最近 N 条已结束语句,满后覆盖最老行 |
| 现在谁在等谁 | data_lock_waits + data_locks | 只反映当前等待边,不保存已结束死锁 |
| 完整死锁参与者和锁细节 | InnoDB 错误日志 | 默认只可从状态看到最后一次;要保留全部需启用打印并做好日志留存 |
这也是为什么单查一张表经常得出错误结论:错误汇总有次数却没有 SQL,语句历史有受害语句却没有完整对手方,锁表能看到对手方却只覆盖当前时刻。应先接受这些边界,再组合证据。
把 1213 变成可读的近期基线
MySQL 的 InnoDB 死锁错误号是 1213。错误汇总表直接提供累计发生数、首次出现时间和最近出现时间,适合作为值班时第一条查询。
-- 只统计死锁错误 1213;不要把锁等待超时 1205 合并进来
SELECT ERROR_NUMBER,
       ERROR_NAME,
       SQL_STATE,
       SUM_ERROR_RAISED,
       SUM_ERROR_HANDLED,
       FIRST_SEEN,
       LAST_SEEN
FROM performance_schema.events_errors_summary_global_by_error
WHERE ERROR_NUMBER = 1213;
SUM_ERROR_RAISED 是当前汇总生命周期内的累计值,FIRST_SEEN 和 LAST_SEEN 给出边界时间。它们可以判断“最近是否还发生”,但不能直接回答“过去 15 分钟新增多少次”。如果需要固定窗口,最稳妥的做法是让监控系统周期性采集这个计数并计算增量;不要频繁 TRUNCATE 汇总表来制造时间窗,因为重置会同时破坏其他排障基线。
如果总数明显上升,可以继续按用户或账号切分。这样做的价值不是追责,而是把影响范围从全实例缩到一个服务账号。
-- 按数据库账号查看 1213 分布,定位主要受影响的应用边界
SELECT USER,
       SUM_ERROR_RAISED,
       FIRST_SEEN,
       LAST_SEEN
FROM performance_schema.events_errors_summary_by_user_by_error
WHERE ERROR_NUMBER = 1213
  AND SUM_ERROR_RAISED > 0
ORDER BY SUM_ERROR_RAISED DESC;
找出反复成为牺牲者的 SQL 形态
确认死锁频率后,下一步不是立即阅读原始 SQL,而是先按摘要归并。events_statements_history_long 保存全线程最近结束的 N 条语句;每条记录带有 MYSQL_ERRNO、RETURNED_SQLSTATE、MESSAGE_TEXT、SQL_TEXT、DIGEST 和 DIGEST_TEXT。其中 DIGEST_TEXT 会把字面量规范化,更适合把同一模板的不同请求聚到一起。
-- 按规范化 SQL 汇总当前环形缓冲区内的死锁牺牲语句
SELECT CURRENT_SCHEMA,
       DIGEST,
       DIGEST_TEXT,
       COUNT(*) AS DEADLOCK_VICTIMS
FROM performance_schema.events_statements_history_long
WHERE MYSQL_ERRNO = 1213
GROUP BY CURRENT_SCHEMA, DIGEST, DIGEST_TEXT
ORDER BY DEADLOCK_VICTIMS DESC
LIMIT 20;
这张榜单回答的是“近期缓冲区里哪类语句最常被回滚”,不是“哪条语句制造了全部死锁”。牺牲语句只是死锁环的一端;真正的修复通常要同时检查另一事务的访问顺序、索引范围和事务持续时间。
需要查看最近的个例时,可以从同一张表读取错误文本和原始 SQL。原始 SQL 可能包含业务字面量,应限制查询权限和导出范围,日常看板优先展示 DIGEST_TEXT。
-- 查看最近保留下来的 1213 个例;TIMER_END 仅用于同一实例内排序
SELECT THREAD_ID,
       EVENT_ID,
       CURRENT_SCHEMA,
       SQL_TEXT,
       DIGEST_TEXT,
       RETURNED_SQLSTATE,
       MESSAGE_TEXT
FROM performance_schema.events_statements_history_long
WHERE MYSQL_ERRNO = 1213
ORDER BY TIMER_END DESC
LIMIT 20;
如果查不到行,先检查 consumer。MySQL 官方示例中 events_statements_history_long 可能处于关闭状态;运行期可以只打开语句全局历史,而不必一次打开所有历史 consumer。
-- 先确认 statement 仪表和全局语句历史 consumer 的状态
SELECT NAME, ENABLED
FROM performance_schema.setup_consumers
WHERE NAME IN ('events_statements_current',
               'events_statements_history_long',
               'statements_digest');

-- 仅在评估内存开销并获得配置权限后启用全局语句历史
UPDATE performance_schema.setup_consumers
SET ENABLED = 'YES'
WHERE NAME = 'events_statements_history_long';
表容量由启动参数 performance_schema_events_statements_history_long_size 决定,运行期不能动态放大。高吞吐实例里,默认容量可能只覆盖很短时间,所以告警采集应尽快读取并外部保存聚合结果。
用当前锁等待补齐现场
错误历史告诉我“谁被回滚过”,当前锁表则回答“现在谁还在等谁”。data_lock_waits 用 requesting 与 blocking 两组锁标识建立多对多关系,再分别连接 data_locks 就能看到对象、索引和锁模式。
-- 将当前等待边连接到请求锁和阻塞锁,观察正在发生的锁竞争
SELECT w.REQUESTING_ENGINE_TRANSACTION_ID AS WAITING_TRX_ID,
       req.OBJECT_SCHEMA,
       req.OBJECT_NAME,
       req.INDEX_NAME,
       req.LOCK_TYPE,
       req.LOCK_MODE AS REQUESTED_LOCK_MODE,
       w.BLOCKING_ENGINE_TRANSACTION_ID AS BLOCKING_TRX_ID,
       blk.LOCK_MODE AS BLOCKING_LOCK_MODE,
       blk.LOCK_DATA AS BLOCKING_LOCK_DATA
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS req
  ON req.ENGINE = w.ENGINE
 AND req.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID
JOIN performance_schema.data_locks AS blk
  ON blk.ENGINE = w.ENGINE
 AND blk.ENGINE_LOCK_ID = w.BLOCKING_ENGINE_LOCK_ID
ORDER BY WAITING_TRX_ID, BLOCKING_TRX_ID;
如果这条查询为空而 1213 计数刚刚上涨,两者并不矛盾:死锁已经被检测并解除。相反,如果这里长期存在相同对象和事务边,即使尚未出现 1213,也说明当前有明显锁竞争,值得继续查长事务、访问顺序和索引选择。
让完整死锁细节进入可检索记录
Performance Schema 的语句历史并不等于完整死锁档案。官方说明中,SHOW ENGINE INNODB STATUS 只用于查看最后一次 InnoDB 用户事务死锁;若要记录所有死锁,应启用 innodb_print_all_deadlocks,让详情进入 mysqld 错误日志。该变量默认关闭、可动态修改。
-- 先确认当前设置;生产修改应走受控变更并使用最小权限账号
SHOW GLOBAL VARIABLES LIKE 'innodb_print_all_deadlocks';

-- 排障窗口内记录所有 InnoDB 用户事务死锁到服务器错误日志
SET GLOBAL innodb_print_all_deadlocks = ON;
MySQL 8.4 在日志 sink 支持时,会把最近错误事件同时暴露到 performance_schema.error_log。它带有真实的 LOGGED 时间戳,适合按时间范围检索;但它本身仍是固定大小的内存环形缓冲区,旧记录会被丢弃,不能替代集中日志系统。
-- 在 error_log 表已由日志 sink 填充时,查询最近一天的 InnoDB 死锁记录
SELECT LOGGED,
       THREAD_ID,
       PRIO,
       ERROR_CODE,
       DATA
FROM performance_schema.error_log
WHERE SUBSYSTEM = 'InnoDB'
  AND LOGGED >= CURRENT_TIMESTAMP - INTERVAL 1 DAY
  AND DATA LIKE '%deadlock%'
ORDER BY LOGGED DESC;
如果 error_log 始终为空,先核对 log_error_services 是否包含支持该表的 sink。即使表里能查到记录,也应由日志采集器把错误日志转存到受控存储,设置保留期、访问权限和脱敏规则。排障结束后是否关闭 innodb_print_all_deadlocks,取决于日志量和团队的长期审计策略,而不是为了让看板数字好看。
按风险处理而不是只盯总数
死锁并不等于数据库损坏。InnoDB 检测到死锁后会选择一个事务回滚,应用仍必须捕获 1213 并重试整个事务。真正需要优先处理的,是重复集中在同一业务路径、导致用户请求失败,或频率持续上升的模式。
| 信号 | 判断 | 处理重点 |
|---|---|---|
| 1213 偶发,应用重试成功 | 低到中风险 | 保留样本,确认重试有退避和次数上限 |
| 某个 DIGEST_TEXT 占大多数牺牲语句 | 高集中度 | 比较事务访问顺序、锁定范围和索引 |
| 同一账号短时间持续增长 | 服务边界明确 | 关联发布、流量变化和事务时长 |
| 锁等待长期存在但 1213 不多 | 不一定是死锁,可能是阻塞 | 检查长事务和锁等待超时,勿混淆 1205 与 1213 |
| 历史表频繁覆盖 | 证据留存不足 | 提高启动时容量或缩短外部采集周期 |
最终复查可以用一张短清单完成:
- 确认汇总查询只筛选错误 1213,并记录当前统计生命周期。
- 确认
events_statements_history_long与statements_digest已启用,容量与业务吞吐相匹配。 - 日常看板优先保存摘要 SQL,不向无关账号暴露原始字面量。
- 用
data_lock_waits描述当前阻塞,不把空表解释为“从未发生死锁”。 - 需要完整因果链时启用所有死锁打印,并把错误日志持久化到实例外。
- 修复后同时观察 1213 增量、受害 SQL 集中度、事务耗时和业务重试成功率。
为什么 1213 计数有值,语句历史却没有记录?
常见原因是全局语句历史 consumer 未启用,或高吞吐把旧记录覆盖了。错误汇总和语句历史采用不同的保留模型,不能要求两者永远一一对应。
能直接用 SQL 做“最近一小时死锁次数”吗?
错误汇总表提供首次、最近时间和累计值,但不是分桶时间序列。需要准确的一小时增量时,应周期采集累计计数并在外部计算差值;错误日志表可按 LOGGED 过滤,但前提是所有死锁都已经写入日志且记录尚未被环形缓冲区淘汰。
降低事务隔离级别能彻底消除死锁吗?
不能。官方文档明确指出,死锁可能性不由隔离级别直接决定,因为写操作仍会加锁。更有效的措施是缩短事务、统一多表访问顺序、为锁定条件建立合适索引,并让应用正确重试整个事务。
只看最后一次死锁详情够不够?
只适合偶发排查。若问题重复发生,最后一次样本容易被覆盖,也不能说明频率和集中度。应把 1213 汇总、受害 SQL 摘要和所有死锁日志结合起来。
-
374 收藏
-
499 收藏
-
384 收藏
-
184 收藏
-
265 收藏
-
333 收藏
-
406 收藏
-
352 收藏
-
178 收藏
-
441 收藏
-
413 收藏
-
283 收藏
-
224 收藏
-
319 收藏
-
401 收藏
-
394 收藏
-
376 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习