
MySQL 字符串比较报 Illegal mix of collations 怎么定位
来源:17golang原创
时间:2026-10-04 23:26:56 486浏览 收藏
MySQL 出现 Illegal mix of collations,通常不是“字符串里有乱码”,而是同一个比较或字符串表达式中,两个操作数的排序规则无法按优先级合并。定位时先锁定报错表达式两侧,再分别查看 COLLATION() 与 COERCIBILITY();不要一上来就修改数据库默认字符集,因为默认值不会自动改掉已有列。
官方地址:https://dev.mysql.com/doc/refman/8.4/en/charset-collation-coercibility.html
- 先找出比较、连接或拼接中的两个字符串来源。
- 再比较两侧的 collation 和 coercibility 数字。
- 最后决定只修当前 SQL,还是统一存量列定义。
先记录冲突双方,不要先改全库
错误最常见于 =、JOIN ... ON、UNION、CASE 和 CONCAT()。第一步是把复杂 SQL 缩到最小表达式,确认是“列对列”“列对字面量”,还是“函数结果对列”。下面的临时表示例故意让两个同为 utf8mb4 的列使用不同排序规则:
-- 两列字符集相同,但排序规则不同
CREATE TEMPORARY TABLE c_left (
  name VARCHAR(40) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci
);
CREATE TEMPORARY TABLE c_right (
  name VARCHAR(40) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci
);

-- 两个列操作数的 coercibility 都是 2,比较时可能形成冲突
SELECT l.name
FROM c_left AS l
JOIN c_right AS r ON l.name = r.name;
这里的“基线指标”不是耗时,而是两个可复现的元数据:两侧 COLLATION() 名称不同,且两侧 COERCIBILITY() 都为 2。同优先级的两种 Unicode 排序规则没有自然胜出者,正是排查重点。
用 COLLATION 和 COERCIBILITY 看优先级
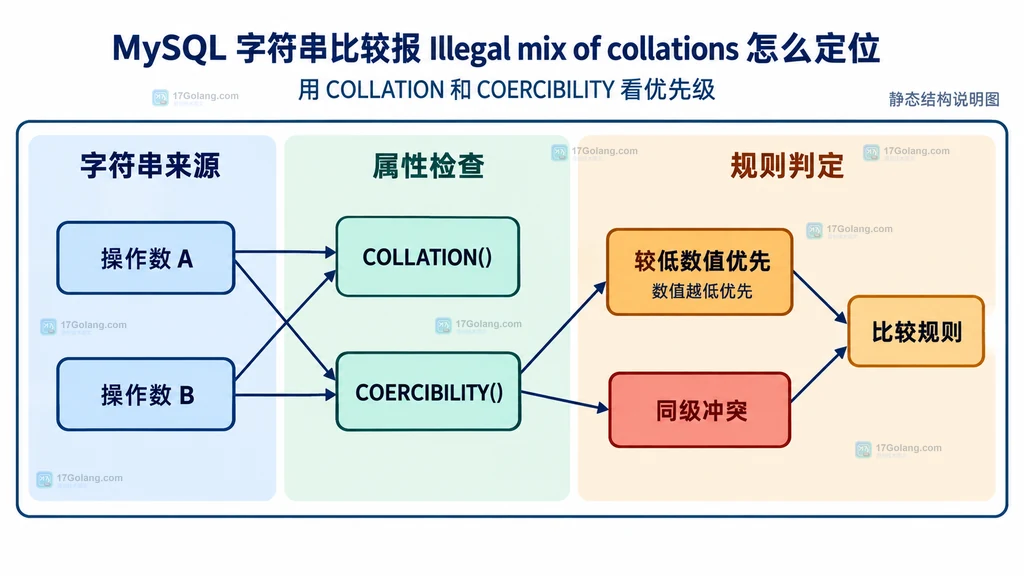
MySQL 会给字符串表达式分配 coercibility。数值越低,排序规则越“不可被强制转换”,比较时优先级越高。常用数值可以先记住三个:显式 COLLATE 是 0,列是 2,字符串字面量是 4。
-- 同时查看值、排序规则和优先级数值
SELECT
  COLLATION(l.name) AS left_collation,
  COERCIBILITY(l.name) AS left_rank,
  COLLATION(r.name) AS right_collation,
  COERCIBILITY(r.name) AS right_rank
FROM c_left AS l
CROSS JOIN c_right AS r
LIMIT 1;
判断规则是:数值较低的一侧优先;若数值相同,则继续看字符集是否同为 Unicode、是否同为非 Unicode,以及同字符集下是否混合 _bin 与 _ci/_cs。排查时不要只比较 utf8mb4 这个字符集名,完整的 collation 名称才包含大小写、重音和排序语义。
检查列定义和连接变量分别影响什么
列的排序规则属于列元数据;连接变量主要影响客户端传入的字符串和没有显式引导符的字面量。先查询存量列,再看当前会话,能避免把两个问题混在一起:
-- 检查参与比较的存量字符列定义
SELECT table_name, column_name, character_set_name, collation_name
FROM information_schema.columns
WHERE table_schema = DATABASE()
  AND table_name IN ('orders', 'customers')
  AND column_name IN ('customer_code', 'code');

-- 检查当前连接如何解释客户端文本与字面量
SELECT
  @@character_set_client,
  @@character_set_connection,
  @@collation_connection,
  @@character_set_results;
核对结果时有两个常见结论:如果是两张表的列定义不同,调整 SET NAMES 通常不能改变存量列的 collation;如果冲突来自字面量或隐式字符串转换,则 collation_connection 值值得继续检查。
按影响范围选择修复方式
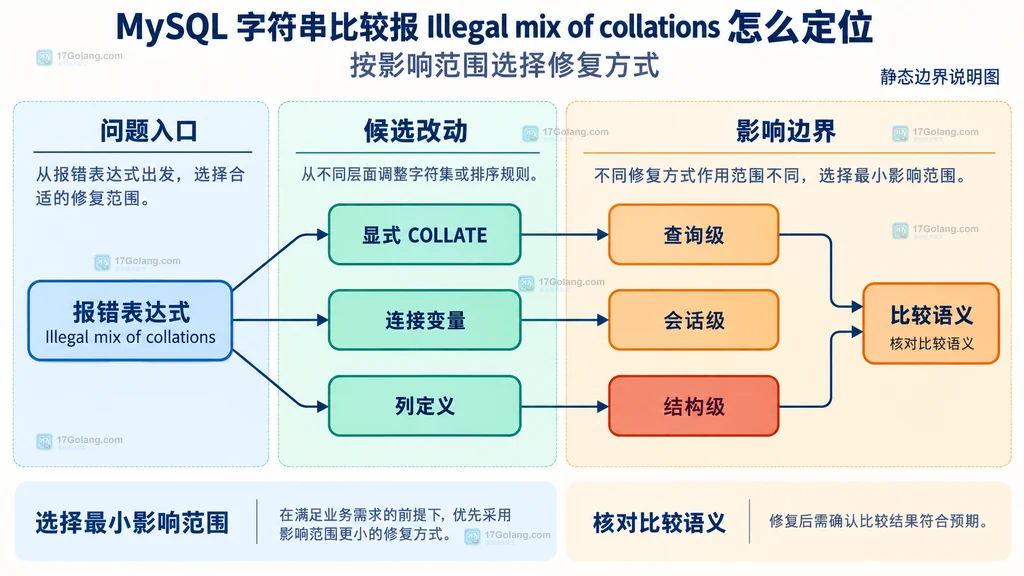
修复应从最小影响范围开始,但长期结构不一致不应永远靠查询补丁隐藏。
- 单条查询需要明确规则:在一个操作数上显式添加与另一侧兼容的
COLLATE。它的 coercibility 为 0,会直接决定本次表达式的比较规则。 - 字面量来源不明确:为字面量加字符集引导符和排序规则,例如
_utf8mb4'ABC' COLLATE utf8mb4_0900_ai_ci。 - 存量列长期需要互相比较:在评估数据、索引和唯一约束后,用
ALTER TABLE ... MODIFY ... CHARACTER SET ... COLLATE ...统一列定义。
-- 查询级修复:只改变本次比较采用的排序规则
SELECT l.name
FROM c_left AS l
JOIN c_right AS r
  ON l.name COLLATE utf8mb4_unicode_ci = r.name;

-- 结构级修复示例:执行前先核对列类型、数据和索引语义
ALTER TABLE c_left
  MODIFY name VARCHAR(40)
  CHARACTER SET utf8mb4
  COLLATE utf8mb4_unicode_ci;
显式 COLLATE 适合快速确认根因,但若它作用在索引列上,执行计划可能与原查询不同;结构级调整则可能改变排序、大小写或重音比较,也可能让原本不同的值在唯一索引下被视为相同。生产环境要先用真实数据副本检查冲突并准备回滚。
用原查询和语义样本复查
修复后至少做两类复查:第一类是重新执行原报错 SQL,确认错误消失;第二类是使用业务关心的字符串样本核对语义,例如大小写不同、带重音字符、尾部空格或多语言文本。只看到“SQL 能执行”还不够,比较结果也必须符合业务预期。
-- 用明确样本核对目标排序规则的比较语义
SELECT
  'A' COLLATE utf8mb4_unicode_ci = 'a' COLLATE utf8mb4_unicode_ci AS case_result,
  COERCIBILITY('A' COLLATE utf8mb4_unicode_ci) AS explicit_rank;
如果结构级改动涉及索引列,还应重新查看 EXPLAIN,并核对唯一索引是否出现值合并风险。本文不声称某一种 collation “更快”;选择标准应是字符覆盖、比较语义和团队的统一约定。
常见问题
问:把数据库默认 collation 改掉,旧列会一起变化吗?
不会自动变化。已有字符列保留创建或修改时确定的字符集与排序规则。
问:为什么列和字符串常量比较通常不报错?
列的 coercibility 通常是 2,字面量通常是 4,数值更低的列规则优先。
问:能否所有地方都加 COLLATE 解决?
它可以解决当前表达式的规则选择,但会增加维护成本,也可能影响索引使用;长期列定义不一致仍应治理。
问:只看 character_set_name 是否足够?
不够。相同字符集可以有多个 collation,比较语义和兼容规则取决于完整排序规则。
-
374 收藏
-
499 收藏
-
384 收藏
-
184 收藏
-
265 收藏
-
455 收藏
-
382 收藏
-
数据库 · MySQL | 8小时前 | MySQL · InnoDB · 数据库运维 · mysql 死锁 错误日志 events_statements_history_long data_lock_waits Performance Schema372 收藏
-
333 收藏
-
406 收藏
-
352 收藏
-
178 收藏
-
441 收藏
-
413 收藏
-
283 收藏
-
224 收藏
-
319 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习