
GitHub 如何重建超大型拉取请求的差异渲染
来源:17golang原创
时间:2026-10-05 07:00:38 446浏览 收藏
超大型拉取请求的难点,不是把更多代码行塞进页面,而是让“代码、评论和滚动位置”在持续变化时仍然像一个普通 PR 一样可用。GitHub Blog 最近复盘了 GitHub Copilot app 的一次重建:测试对象达到 2200 个文件、超过 100 万行变更,并带有 400 多条行内评论。它给出的答案不是单一组件,而是一组分层的数据、几何和测量策略。
官方资料:https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/
- 纯代码行继续使用固定几何和窗口虚拟化;评论线程改用延迟测量、有限修正和滚动锚点。
- 数据先流式提供文件结构与元数据,再按视口构建高亮、Markdown 和建议修改内容,并保留少量最近差异缓存。
- 用真实生产埋点、headless probe 和桌面自动化检查空白、滚动跳动、评论挂载与观察器泄漏。
先分清极端案例与普通 GitHub 限制
这次复盘描述的是 Copilot app 为极端大 PR 重建的差异界面,不等于普通 GitHub 网页会无条件渲染百万行内容。GitHub Docs 当前仍列出标准差异限制:一个拉取请求可加载的总差异不超过 20,000 行或 1 MB 原始 diff,单文件也有 20,000 行和 500 KB 的限制,单次差异最多 300 个文件。超过限制时,部分内容可能不显示。
因此,读者真正应该借鉴的是架构原则:当产品必须处理远超日常规模的数据时,把“正常路径”和“极端路径”拆开,让性能保护不破坏普通审查中的查找、复制和评论体验。
纯代码行与评论线程必须采用两套高度契约
代码行的高度通常由字体、行距和布局规则决定。渲染器可以提前算出第 N 行的偏移,只把视口附近的一小段 DOM 挂载出来,再回收滚出窗口的节点。这样,滚动条总高度、跳转到指定行和当前可见范围都可以通过几何表完成,而不是遍历全部行。
评论线程却不是固定高度。Markdown 会随窗口宽度换行,详情块可以展开,回复编辑器会变高,图片加载也可能改变布局。若一开始给每条评论预留一个“大概高度”,极端评论会被裁剪;若渲染后把真实高度直接写回全局偏移表,用户滚动时下方内容会突然移动。
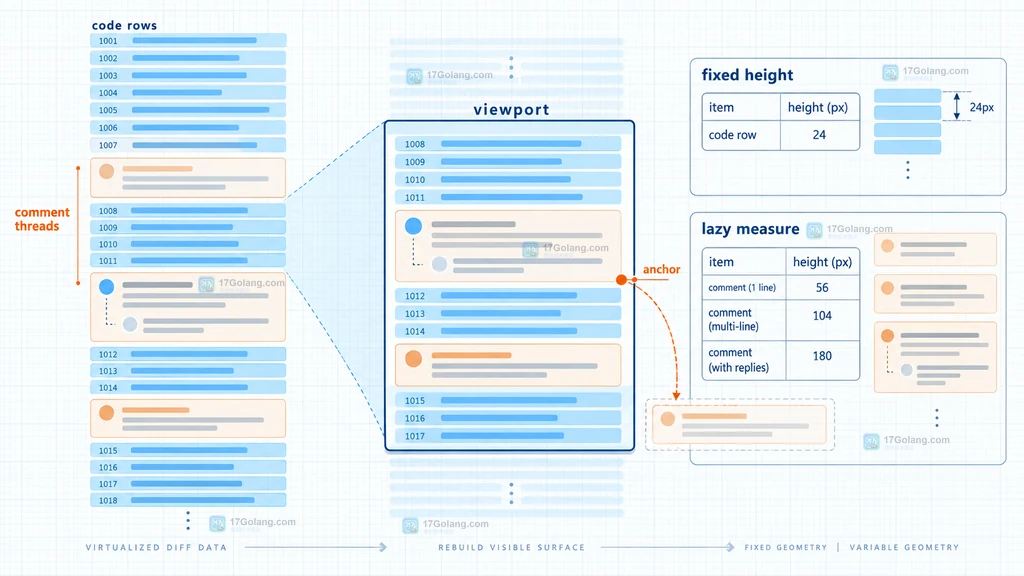
重建后的契约更实际:代码行保持已知高度,评论块只在接近视口时测量,修正幅度受控,并尽量围绕用户正在看的位置调整。这个边界很重要:虚拟化不是“所有东西都用同一套列表组件”,而是先识别哪些对象能提前知道几何,哪些对象必须接受运行时测量。
从结构优先到视口懒构建,数据管线也要分层
即使 DOM 很轻,数据管线堵住也会让界面像卡死。GitHub 的做法可以概括为四段:
| 阶段 | 处理方式 | 解决的问题 |
|---|---|---|
| 结构 | 先提供文件树、差异拓扑和元数据 | 用户先看到页面骨架,不必等待全部正文 |
| 内容 | 完整评论线程先解析,细节内容按需构建 | 避免滚动中反复发现新评论块 |
| 增强 | 语法高亮放到主线程之外,Markdown 与建议修改靠近视口再处理 | 先可交互,再逐步变丰富 |
| 缓存 | 只保留少量最近访问的差异文档,离开后淘汰更旧内容 | 回到刚看过的 PR 时减少白屏,同时避免长期吃满内存 |
这是一种数据生命周期设计:结构先到达,正文按需求进入,增强结果异步补齐,过期对象主动回收。它比“把整个 PR 一次性请求并交给 React”更适合不确定规模的数据。
小组件也会把大 PR 的成本放大
GitHub 另一篇性能复盘给出了一个很有代表性的方向:先简化每条 diff 行的组件和 DOM,再对真正超大的 PR 启用窗口虚拟化。在 10,000 行变更的测试中,重构后的实现减少了组件数量、DOM 节点和内存使用;对更大的 p95 PR,虚拟化把浏览器同时管理的内容限制在视口附近。
可迁移的工程清单并不复杂:
- 先数清单行的 DOM、组件和事件处理器,删除只负责转发的包装层。
- 把评论、菜单等低频状态移到需要它们的子区域,不要让每一行都携带完整状态。
- 用扁平结构和 Map 做路径加行号的常量时间查找,避免滚动时反复扫描全量评论。
- 将事件处理集中到父级,通过数据属性判断目标,减少成千上万条独立监听器。
- 普通规模优先保留浏览器原生查找和复制;只有跨过明确阈值后才切换虚拟化模式。
用自动测量闭环找出大 PR 的滚动与评论缺陷
大 PR 的缺陷往往不是每次都出现:某个浏览器、某个滚动位置、某种评论展开顺序才会触发。GitHub 没有把判断交给人工目测,而是让应用暴露生产级信号,再用两条自动化通道反复执行相同动作。
headless probe 对 mock server 执行打开 PR、滚动到指定比例、展开详情和调整窗口等声明式操作,同时读取 React 渲染计数、性能时间线和 requestAnimationFrame 采样。另一条自动化通道驱动真实桌面应用,覆盖冷启动、评论加载、回复框开关、文件折叠、侧边栏切换、深处文件扫描和窗口缩放。
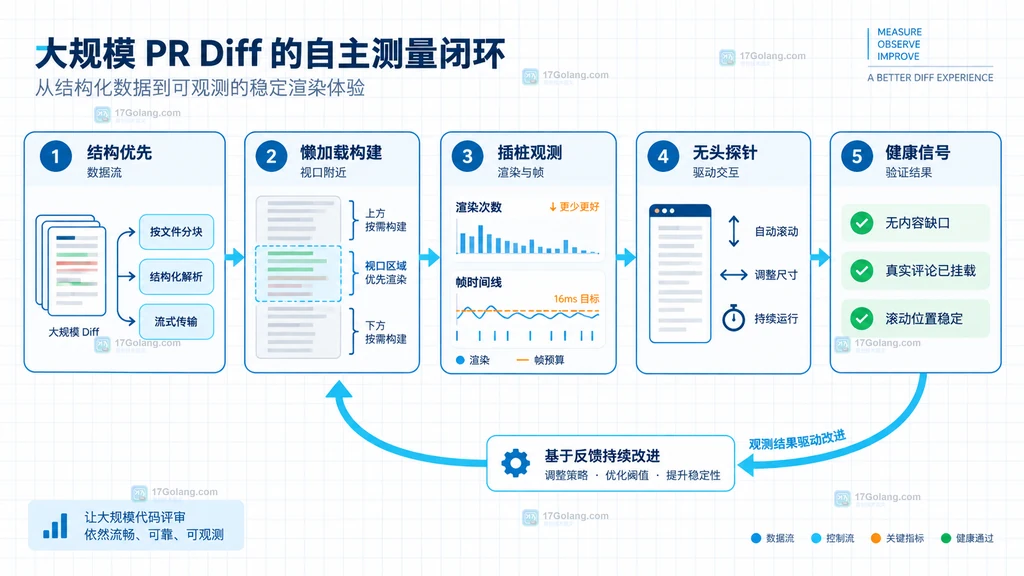
健康标准也要可计算:评论之间不能出现未填充的空白块,真正的线程内容必须挂载,滚动修正不能大幅跳动,视口外的观察器在卸载时必须清理。发现异常后只增加一个窄探针,复现、定位、固化成测试,再移除临时脚手架。这样,性能优化就从“感觉变快了”变成可回归的工程约束。
这套方案适合什么场景
如果你在做日志浏览器、代码审查器、数据表格或文档阅读器,先判断内容是否具备固定几何。固定高度的主列表可以大胆使用窗口虚拟化;可折叠卡片、富文本评论和图片附件则应单独建模,采用懒测量并保护当前视口。不要为了追求极限数据量,把所有操作都变成虚拟 DOM,从而丢掉用户依赖的查找、复制或打印能力。
GitHub 的经验也说明,性能不是一次重构的终点。先用指标确定瓶颈,再按数据、渲染、交互和缓存分层治理;把极端规模作为明确的降级分支,普通 PR 才能继续保持自然的审查手感。
相关问题
虚拟化是不是只渲染当前可见的一行?
不是。通常会保留视口附近的缓冲区,并按滚动方向提前准备内容;关键是不要让 DOM 数量随总行数线性增长。
为什么评论不能直接套用代码行的固定高度?
评论高度受换行、展开区、回复编辑器和异步图片影响,渲染前无法准确知道。固定估计会产生空白或裁剪,直接回写又会造成滚动跳动。
普通 GitHub PR 超过限制后怎么办?
先按 GitHub Docs 的限制拆分提交或拉取请求,必要时使用本地工具检查完整差异;不要把 Copilot app 的极端渲染案例理解成普通网页限制已经取消。
来源与继续核对
- GitHub Blog:
https://github.blog/engineering/user-experience/rendering-huge-pull-requests-in-the-github-copilot-app/ - GitHub Blog:
https://github.blog/engineering/architecture-optimization/the-uphill-climb-of-making-diff-lines-performant/ - GitHub Changelog:
https://github.blog/changelog/2026-01-22-improved-pull-request-files-changed-page-on-by-default/ - GitHub Docs:
https://docs.github.com/en/repositories/creating-and-managing-repositories/repository-limits
-
455 收藏
-
431 收藏
-
124 收藏
-
311 收藏
-
462 收藏
-
400 收藏
-
343 收藏
-
376 收藏
-
377 收藏
-
200 收藏
-
科技周边 · 业界新闻 | 14小时前 | kubernetes · 业界新闻 · Gateway API 云原生网络 HTTPRoute Cilium 1.20 ExternalAuth ext_authz118 收藏
-
419 收藏
-
279 收藏
-
487 收藏
-
269 收藏
-
492 收藏
-
221 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习